Implementasi Pivot Table dan Reshaping Data dengan Pandas: dari Wide ke Long Format
Struktur tabel yang nyaman dibaca manusia sering berbeda dari struktur yang dibutuhkan library analisis. Pandas menyediakan pivot_table, melt, stack, dan unstack untuk memindahkan data antara kedua bentuk tersebut tanpa mengubah nilai aslinya.
Membaca Perbedaan Wide Format dan Long Format pada DataFrame
Pada wide format, setiap kategori menempati kolom tersendiri. Tabel penjualan bulanan menyimpan Jan, Feb, dan Mar sebagai tiga kolom terpisah, sementara setiap baris mewakili satu kota. Pembacaan horizontal pada satu baris langsung memperlihatkan riwayat lengkap entitas tersebut, sehingga format ini nyaman untuk laporan dan ekspor ke spreadsheet.
Pada long format, satu baris mewakili satu observasi. Label periode disimpan di kolom month dan nilainya di kolom sales, sehingga jumlah baris menjadi hasil kali antara jumlah entitas dan jumlah periode. Sebagian besar fungsi plotting seperti seaborn dan plotly mengharapkan bentuk ini karena kategori cukup dipetakan ke satu kolom.
Beberapa tanda menunjukkan bahwa data perlu di-reshape. Nama kolom berisi periode atau nama entitas seperti Jan, 2023_Q1, atau produk_A. Satu kolom menyimpan metrik yang sama untuk banyak entitas. Kolom tambahan muncul dari salinan manual antar file. Pemeriksaan df.shape dan df.columns cukup untuk mengenali pola tersebut sebelum operasi lain dijalankan.
import pandas as pd

wide = pd.DataFrame({
    "city": ["Jakarta", "Bandung", "Surabaya"],
    "Jan": [120, 95, 110],
    "Feb": [135, 88, 102],
    "Mar": [150, 91, 118],
})

long = wide.melt(id_vars=["city"], var_name="month", value_name="sales")

print("Wide format")
print(wide.to_string(index=False))
print()
print("Long format")
print(long.to_string(index=False))
Output:
Wide format
    city  Jan  Feb  Mar
 Jakarta  120  135  150
 Bandung   95   88   91
Surabaya  110  102  118

Long format
    city month  sales
 Jakarta   Jan    120
 Bandung   Jan     95
Surabaya   Jan    110
 Jakarta   Feb    135
 Bandung   Feb     88
Surabaya   Feb    102
 Jakarta   Mar    150
 Bandung   Mar     91
Surabaya   Mar    118
Output dari kode di atas memperlihatkan perbedaan struktur secara langsung. Tabel wide memiliki tiga baris dan empat kolom, sedangkan tabel long memiliki sembilan baris dan tiga kolom. Nilai penjualan tetap sama, hanya posisinya yang berubah.
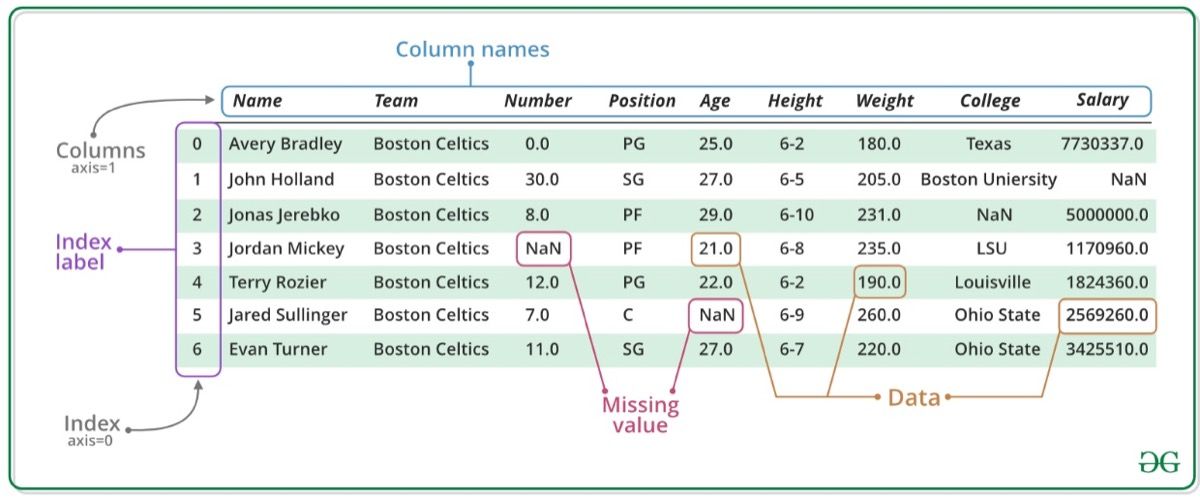
Gambar: Anatomi DataFrame: label index pada sumbu 0, nama kolom pada sumbu 1, sel data, dan nilai yang hilang (NaN) yang perlu diperhatikan saat reshaping — Sumber: Wikimedia Commons
Membangun Pivot Table dari Data Transaksi Mentah
Data transaksi selalu datang dalam bentuk long karena satu baris mewakili satu kejadian. pivot_table merangkum data tersebut menjadi tabel ringkas dengan entitas pada baris, kategori pada kolom, dan hasil agregasi pada sel pertemuannya. We mulai dari data transaksi mentah, lalu memeriksa hasil setiap operasi reshaping sebelum melanjutkan ke tahap berikutnya.
Empat parameter inti menentukan hasilnya. index menempatkan entitas pada baris, columns menyebarkan kategori ke kolom, values memilih kolom angka yang diagregasi, dan aggfunc menentukan fungsi agregasinya. Nilai default aggfunc adalah "mean", dan pilihan ini sering keliru untuk data penjualan. Gunakan "sum" bila yang dibutuhkan adalah total, dan "mean" bila yang dibutuhkan adalah rata-rata per transaksi.
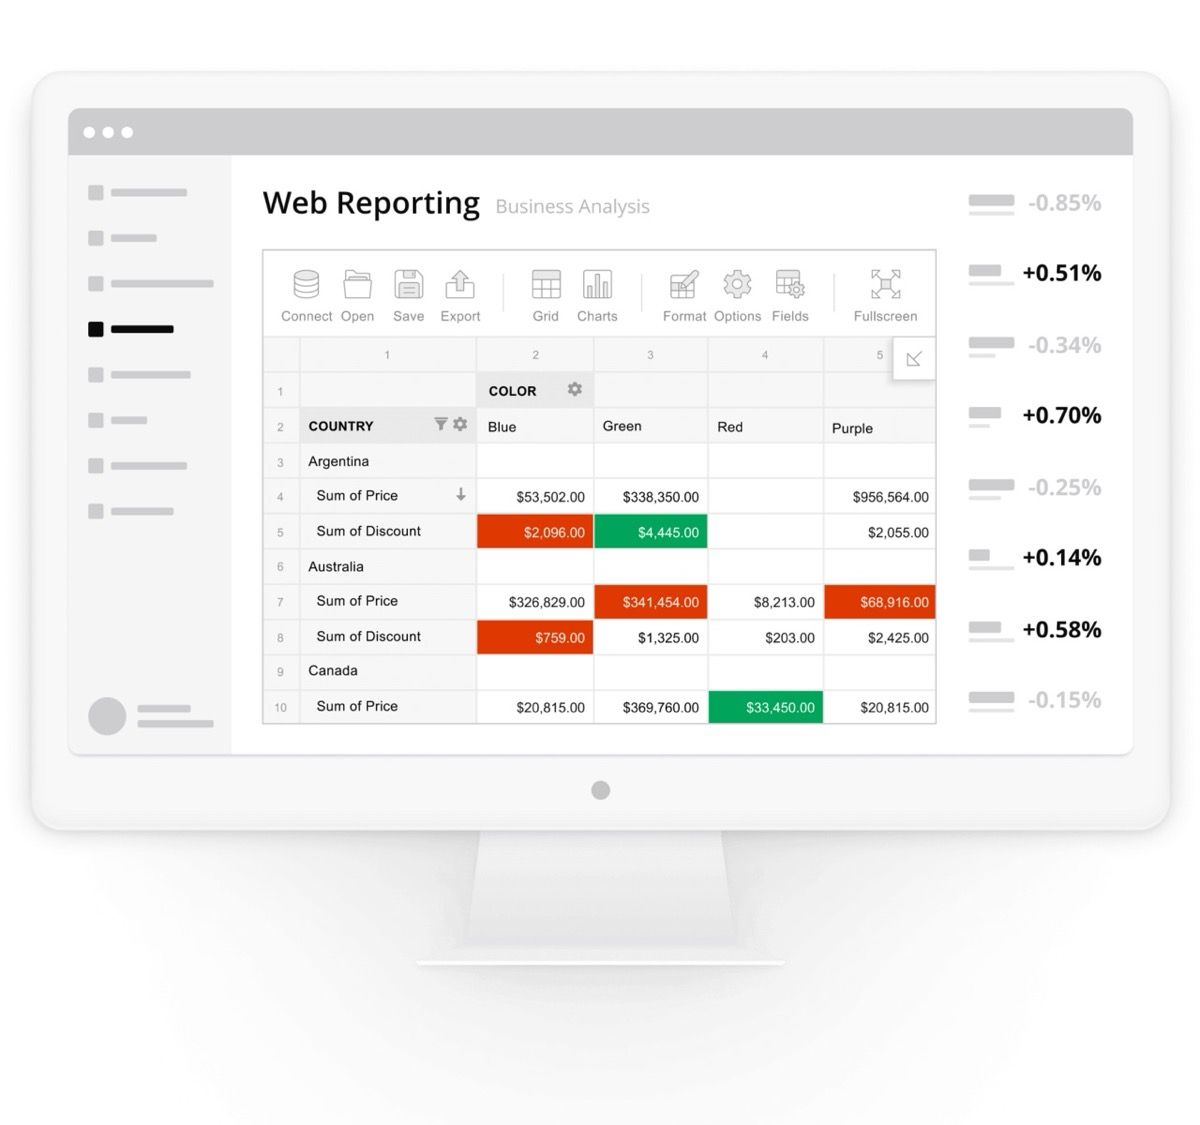
Gambar: Tata letak pivot table yang setara dengan index, columns, dan values di Pandas: entitas pada baris (COUNTRY), kategori pada kolom (COLOR), serta nilai agregat seperti Sum of Price di sel pertemuan — Sumber: Wikimedia Commons
Perbedaan pivot_table dengan groupby().unstack() terletak pada penanganan duplikat. pivot biasa menolak pasangan index dan kolom yang muncul lebih dari sekali, sedangkan pivot_table langsung mengagregasinya. Parameter fill_value mengisi sel kosong dengan nilai netral sehingga hasil tidak menyisakan NaN.
Parameter margins=True menambahkan total baris dan kolom pada hasil. Label total dapat diganti melalui margins_name. Perhitungan margins dilakukan sebelum fill_value diterapkan pada sel kosong, sehingga hasil total bisa berbeda dari penjumlahan manual bila data memiliki kombinasi yang hilang.
import pandas as pd

transactions = pd.DataFrame({
    "city": ["Jakarta", "Jakarta", "Bandung", "Bandung", "Surabaya", "Surabaya", "Jakarta", "Bandung"],
    "month": ["Jan", "Feb", "Jan", "Feb", "Jan", "Feb", "Jan", "Mar"],
    "sales": [120, 135, 95, 88, 110, 102, 140, 91],
})

pivot = pd.pivot_table(
    transactions,
    index="city",
    columns="month",
    values="sales",
    aggfunc="sum",
    fill_value=0,
    margins=True,
    margins_name="Total",
)

print(pivot)
print()
print(pivot.reset_index().to_string(index=False))
Output:
month     Feb  Jan  Mar  Total
city
Bandung    88   95   91    274
Jakarta   135  260    0    395
Surabaya  102  110    0    212
Total     325  465   91    881

    city  Feb  Jan  Mar  Total
 Bandung   88   95   91    274
 Jakarta  135  260    0    395
Surabaya  102  110    0    212
   Total  325  465   91    881
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Hasilnya berupa tabel kota versus bulan dengan total di baris dan kolom terakhir. Bila aggfunc diisi daftar seperti ["sum", "mean"], kolom hasil menjadi MultiIndex dan perlu diratakan dengan reset_index() atau droplevel() sebelum disimpan.
Mengubah Wide ke Long dengan melt dan stack
pd.melt memilih kolom yang dipertahankan lewat id_vars dan kolom yang dilebur lewat value_vars. Parameter var_name dan value_name menentukan nama dua kolom baru, sehingga hasilnya konsisten dengan konvensi penamaan proyek.
stack() mengambil jalur berbeda. Method ini memakai index sebagai identifier dan melebur level kolom menjadi level index baru. Langkah set_index sebelum stack dan reset_index sesudahnya mengembalikan hasil ke DataFrame datar. Nama kolom bawaan perlu diganti secara eksplisit karena stack memberi nama generik seperti level_1 dan 0.
Urutan baris kedua pendekatan tidak identik. melt mengelompokkan hasil per kolom nilai, sedangkan stack mengelompokkannya per index. Isi dan tipe data nilainya sama, sehingga pilihan di antara keduanya bergantung pada posisi identifier. Bila identifier masih berupa kolom, melt lebih langsung. Bila identifier sudah menjadi index, stack menghindari satu langkah tambahan.
import pandas as pd

wide = pd.DataFrame({
    "city": ["Jakarta", "Bandung", "Surabaya"],
    "Jan": [120, 95, 110],
    "Feb": [135, 88, 102],
    "Mar": [150, 91, 118],
})

melted = wide.melt(
    id_vars=["city"],
    value_vars=["Jan", "Feb", "Mar"],
    var_name="month",
    value_name="sales",
)

stacked = wide.set_index("city").stack().reset_index()
stacked.columns = ["city", "month", "sales"]

print(melted.to_string(index=False))
print()
print(stacked.to_string(index=False))
print()
print("shape melt:", melted.shape)
print("shape stack:", stacked.shape)
Output:
    city month  sales
 Jakarta   Jan    120
 Bandung   Jan     95
Surabaya   Jan    110
 Jakarta   Feb    135
 Bandung   Feb     88
Surabaya   Feb    102
 Jakarta   Mar    150
 Bandung   Mar     91
Surabaya   Mar    118

    city month  sales
 Jakarta   Jan    120
 Jakarta   Feb    135
 Jakarta   Mar    150
 Bandung   Jan     95
 Bandung   Feb     88
 Bandung   Mar     91
Surabaya   Jan    110
Surabaya   Feb    102
Surabaya   Mar    118

shape melt: (9, 3)
shape stack: (9, 3)
Kedua tabel memiliki shape yang sama, yaitu sembilan baris dan tiga kolom. Perbedaannya hanya pada urutan baris dan nama kolom sebelum proses rename dijalankan.
Mengembalikan Long ke Wide dengan pivot dan unstack
pivot(index, columns, values) adalah operasi kebalikan dari melt. Setiap pasangan unik antara index dan kolom menjadi satu sel pada tabel lebar. Syaratnya tegas: pasangan tersebut harus unik, jika tidak Pandas menghentikan proses dengan ValueError: Index contains duplicate entries.
Solusinya bergantung pada tujuan. Bila duplikat berasal dari data yang sah, gunakan pivot_table dengan aggfunc yang sesuai agar nilai digabung. Bila duplikat berasal dari baris ganda, drop_duplicates() lebih tepat karena tidak mengubah nilai. Menghapus duplikat tanpa memeriksa sumbernya berisiko menghilangkan transaksi valid.
unstack(level) bekerja pada Series atau DataFrame dengan MultiIndex. Method ini memindahkan satu level index menjadi kolom, dan parameter level menentukan level mana yang dipindahkan pada struktur dengan lebih dari dua level. Parameter fill_value mengisi kombinasi yang tidak memiliki data.
Urutan kolom hasil pivot mengikuti urutan nilai kategori, bukan urutan yang diinginkan untuk laporan. reindex(columns=["Jan", "Feb", "Mar"]) menetapkan urutan tersebut sekaligus menambahkan kolom yang belum ada. Nilai pengisi sebaiknya dipilih sesuai konteks: nol untuk jumlah dan hitungan, NaN untuk rata-rata agar tidak menurunkan nilai sebenarnya.
import pandas as pd

long = pd.DataFrame({
    "city": ["Jakarta", "Jakarta", "Bandung", "Bandung"],
    "month": ["Jan", "Feb", "Jan", "Feb"],
    "sales": [120, 135, 95, 88],
})

wide = long.pivot(index="city", columns="month", values="sales")
print(wide)
print()

duplicated = pd.concat([long, long.iloc[[0]]], ignore_index=True)

try:
    duplicated.pivot(index="city", columns="month", values="sales")
except ValueError as error:
    print("pivot gagal:", error)

safe = pd.pivot_table(
    duplicated,
    index="city",
    columns="month",
    values="sales",
    aggfunc="sum",
    fill_value=0,
)
print()
print(safe)

ordered = safe.reindex(columns=["Jan", "Feb", "Mar"], fill_value=0)
print()
print(ordered)

unstacked = long.set_index(["city", "month"])["sales"].unstack(fill_value=0)
print()
print(unstacked)
Output:
month    Feb  Jan
city
Bandung   88   95
Jakarta  135  120

pivot gagal: Index contains duplicate entries, cannot reshape

month    Feb  Jan
city
Bandung   88   95
Jakarta  135  240

month    Jan  Feb  Mar
city
Bandung   95   88    0
Jakarta  240  135    0

month    Feb  Jan
city
Bandung   88   95
Jakarta  135  120
Tabel lebar hasil rekonstruksi memuat kolom Jan, Feb, dan Mar dengan urutan yang sudah ditentukan. Baris duplikat pada contoh kedua tidak lagi menggagalkan proses karena pivot_table menjumlahkannya, sedangkan pivot tetap memberi pesan error sebagai peringatan.
Memakai Hasil Reshaping untuk Agregasi dan Visualisasi
Alur kerja yang stabil dimulai dari long format. Data dilebur lebih dulu, lalu diagregasi dengan groupby atau pivot_table, dan terakhir divisualisasikan. Urutan ini membuat kode agregasi tidak bergantung pada nama kolom yang berubah setiap kali periode baru ditambahkan.
Beberapa fungsi agregasi dapat dijalankan sekaligus melalui dictionary, misalnya {"sales": ["sum", "mean"]}. Hasilnya memiliki kolom bertingkat, sehingga nama kolom perlu diratakan sebelum dipakai sebagai label grafik. Rantai melt lalu pivot_table juga memudahkan penambahan kategori baru tanpa menyentuh bagian plotting.
Pilihan format untuk plotting bergantung pada jenis grafik. Tabel wide langsung dapat digambar dengan df.plot() karena setiap kolom otomatis menjadi satu seri. Tabel long lebih ringkas untuk seaborn dengan parameter hue, karena kategori tidak perlu ditulis manual sebagai nama kolom. Simpan hasil akhir dalam bentuk tidy agar tahap analisis berikutnya tidak mengulang reshaping yang sama.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

trend = pd.DataFrame({
    "city": ["Jakarta"] * 3 + ["Bandung"] * 3,
    "month": ["Jan", "Feb", "Mar"] * 2,
    "sales": [120, 135, 150, 95, 88, 91],
})

summary = pd.pivot_table(
    trend,
    index="month",
    columns="city",
    values="sales",
    aggfunc="sum",
    fill_value=0,
).reindex(["Jan", "Feb", "Mar"])

summary.plot(kind="line", marker="o")
plt.title("Tren Penjualan per Kota")
plt.xlabel("Bulan")
plt.ylabel("Total Penjualan")
plt.tight_layout()

print(summary)
print()
print(trend.groupby("month")["sales"].agg(["sum", "mean"]))
Output:
city   Bandung  Jakarta
month
Jan         95      120
Feb         88      135
Mar         91      150

       sum   mean
month
Feb    223  111.5
Jan    215  107.5
Mar    241  120.5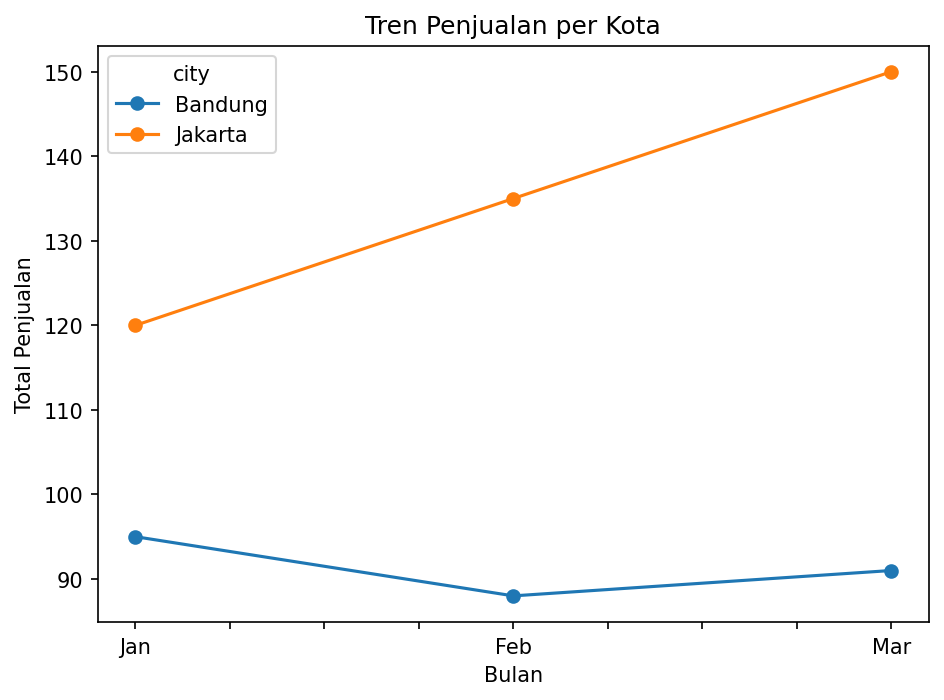
Grafik yang dihasilkan menampilkan satu garis per kota pada sumbu bulan. Tabel pivot di atasnya menjadi sumber data grafik, dan agregasi sum serta mean per bulan tetap dapat diperiksa pada output teks.
Menghindari Kesalahan Umum pada Operasi Reshaping
Kolom duplikat muncul ketika pivot_table dijalankan dengan daftar aggfunc. Setiap kolom hasil menjadi tuple seperti ("sales", "sum"), sehingga akses dengan nama tunggal gagal. Gunakan tuple lengkap atau ratakan nama kolom lebih dulu.
Beban memori meningkat cepat pada unstack dengan MultiIndex besar. Setiap kombinasi index dan kolom menjadi sel pada matriks padat, dan sebagian besar sel mungkin kosong. Agregasi sebelum unstack serta penggunaan dtype category menekan kebutuhan memori secara signifikan.
Tipe data juga dapat bergeser setelah melt. Kolom kategori berubah menjadi object, sementara kolom nilai umumnya mempertahankan tipe numeriknya. Konversi ulang dengan astype("category") mengembalikan efisiensi penyimpanan dan mempercepat operasi groupby berikutnya.
Kebiasaan aman yang sederhana: periksa shape, .head(), dan .dtypes sebelum serta sesudah reshaping. Simpan hasil antara ke variabel terpisah ketika rantai operasi panjang, lalu bandingkan jumlah baris dengan ekspektasi. Selisih jumlah baris biasanya menandakan duplikat yang tidak terdeteksi.
Manipulasi data dengan pandas adalah fondasi sebelum masuk ke tahap pemodelan. Rumah Coding menyediakan bootcamp Data Science yang membahas pandas, data wrangling, dan visualisasi secara terstruktur. Kunjungi halaman program Rumah Coding untuk melihat silabus lengkap dan jadwal batch terdekat.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.