Memahami Bayesian Optimization dengan Optuna untuk Hyperparameter Tuning yang Efisien
Mengapa Grid Search dan Random Search Boros Anggaran Evaluasi
Setiap trial hyperparameter berarti satu proses training penuh. Ketika kita memakai cross-validation lima lipatan, satu kombinasi saja sudah menuntut lima kali fit model. Anggaran komputasi karena itu tumbuh mengikuti jumlah kombinasi, bukan mengikuti kualitas keputusan yang diambil.
GridSearchCV mengevaluasi titik secara seragam pada grid yang kita tentukan. Resolusi kasar membuat optimum sebenarnya terlewat di antara dua titik grid. Resolusi halus menaikkan jumlah kombinasi secara eksponensial terhadap jumlah hyperparameter. Pada lima hyperparameter dengan lima nilai masing-masing, grid sudah berisi 3.125 kombinasi, dan setiap kombinasi masih harus divalidasi silang.
RandomizedSearchCV memperbaiki masalah dimensi. Sampling acak memberi peluang lebih besar untuk menyentuh area penting pada ruang berdimensi tinggi. Metode ini tetap tidak memakai informasi dari trial sebelumnya. Titik ke-51 dipilih tanpa melihat bahwa trial ke-10 sampai ke-50 semuanya mendapat skor rendah di area yang sama.
Sifat memoryless inilah akar masalahnya. Anggaran training habis di area ruang hyperparameter yang sudah terbukti buruk. Bayesian optimization masuk sebagai sequential model-based optimization: setiap evaluasi memperbarui model internal, lalu model itu menentukan titik berikutnya. Trial berikutnya tidak lagi acak, melainkan hasil keputusan berbasis histori.
Cara Kerja Bayesian Optimization Membangun Model Pengganti Fungsi Objective
Fungsi objective diperlakukan sebagai black box. Kita hanya bisa mengamati skor validasi dari scikit-learn, bukan turunan fungsi terhadap hyperparameter. Optimasi berbasis gradient karena itu tidak bisa dipakai langsung.
Dua komponen menjalankan proses ini. Surrogate model memberi estimasi skor beserta ketidakpastiannya pada titik yang belum dicoba. Acquisition function memakai estimasi tersebut untuk memilih titik evaluasi berikutnya. Surrogate model bisa dibayangkan sebagai peta perkiraan medan yang belum dijelajahi, lengkap dengan area yang masih kabur.
Expected Improvement adalah acquisition function yang paling sering dipakai. Fungsinya menyeimbangkan exploitation di area dengan skor tinggi dan exploration di area yang belum teramati. Tanpa exploration, proses berhenti di lokal optimum pertama. Tanpa exploitation, proses berubah menjadi random search yang mahal.
Siklusnya berulang dalam empat langkah. Fit surrogate pada histori evaluasi, maksimalkan acquisition function, evaluasi titik baru, lalu perbarui histori. Setiap iterasi membuat surrogate makin akurat di area yang relevan.
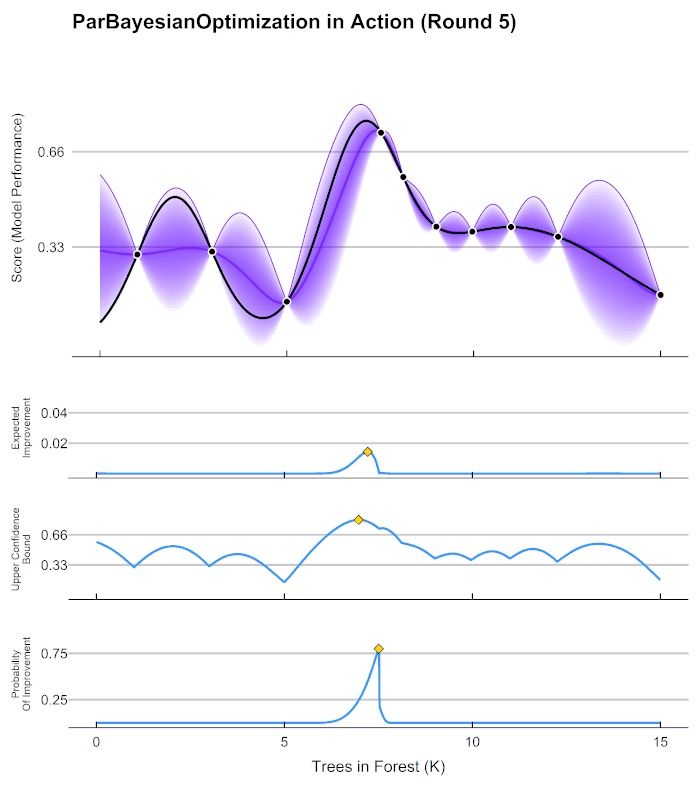
Gambar: Siklus Bayesian optimization — Gaussian Process (ungu) dengan pita ketidakpastian, tiga acquisition function di panel bawah, dan titik evaluasi berikutnya ditandai belah ketupat jingga. Karya AnotherSamWilson, CC BY-SA 4.0 — Sumber: Wikimedia Commons
Optuna memakai Tree-structured Parzen Estimator (TPE) sebagai sampler default. TPE memodelkan distribusi hyperparameter untuk hasil baik dan hasil buruk secara terpisah, lalu memilih titik dengan rasio yang menjanjikan. Pendekatan ini lebih murah daripada Gaussian Process pada ruang campuran, misalnya kombinasi max_depth integer dengan learning_rate kontinu. Kita tidak perlu memasang library tambahan untuk memakainya.
Menyusun Objective Function dan Study Pertama dengan Optuna
Objective function adalah satu-satunya bagian yang kita tulis sendiri. Optuna mengurus pencatatan histori, pemilihan titik berikutnya, dan penyimpanan hasil. Alur kerjanya sederhana: definisikan ruang pencarian, kembalikan satu skor skalar, lalu serahkan sisanya ke study.
Ruang pencarian didefinisikan lewat tiga method. trial.suggest_int untuk nilai bulat seperti n_estimators. trial.suggest_float untuk nilai kontinu, dan argumen log=True dipakai saat skala hyperparameter logaritmik seperti C pada SVM atau learning_rate. trial.suggest_categorical untuk pilihan diskret seperti criterion.
!pip install optuna scikit-learn

import optuna
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score, StratifiedKFold

X, y = load_breast_cancer(return_X_y=True)
cv = StratifiedKFold(n_splits=3, shuffle=True, random_state=42)


def objective(trial):
    n_estimators = trial.suggest_int("n_estimators", 50, 300, step=50)
    max_depth = trial.suggest_int("max_depth", 2, 16)
    min_samples_split = trial.suggest_int("min_samples_split", 2, 10)
    max_features = trial.suggest_float("max_features", 0.1, 1.0, log=True)

    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=min_samples_split,
        max_features=max_features,
        random_state=42,
        n_jobs=-1,
    )
    scores = cross_val_score(model, X, y, cv=cv, scoring="accuracy")
    return scores.mean()


study = optuna.create_study(
    direction="maximize",
    sampler=optuna.samplers.TPESampler(seed=42),
)
study.optimize(objective, n_trials=30)

print("best value:", round(study.best_value, 4))
print("best trial:", study.best_trial.number)
for key, value in study.best_params.items():
    print(f"  {key}: {value}")
Fungsi objective menerima satu trial dan mengembalikan scores.mean() dari cross-validation. Cross-validation dipakai agar skor tidak bergantung pada satu split kebetulan. Setiap parameter diambil dari trial, sehingga Optuna tahu titik mana yang sedang dievaluasi.
Dua argumen menentukan arah proses. direction="maximize" menandakan bahwa skor lebih besar lebih baik, sedangkan n_trials=30 membatasi jumlah evaluasi. Di balik layar, Optuna mencetak satu baris log per trial berisi nomor trial, nilai, parameter terpilih, dan durasi. Trial pertama sampai kedelapan biasanya masih acak karena TPE belum punya cukup histori untuk membangun distribusi.
Jumlah trial sebaiknya ditentukan dari anggaran waktu, bukan angka bulat. Jika satu trial butuh 40 detik dan kita punya 30 menit, batas realistisnya sekitar 45 trial.
Setelah selesai, study.best_params berisi kombinasi terbaik, study.best_value skor akurasinya, dan study.best_trial menyimpan objek trial lengkap beserta timestamp. Untuk audit, study.trials_dataframe() mengubah seluruh histori menjadi DataFrame berisi nilai, state, dan setiap parameter. DataFrame ini berguna saat kita ingin memeriksa trial mana yang mendapat skor tertinggi di luar trial terbaik. Keluaran yang kita harapkan kurang lebih seperti ini:
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
[I 2026-11-15 18:01:51,630] A new study created in memory with name: no-name-10088a8f-0f7c-4a04-8b7d-f94b2bccb638
[I 2026-11-15 18:01:51,995] Trial 0 finished with value: 0.9525851666202544 and parameters: {'n_estimators': 150, 'max_depth': 16, 'min_samples_split': 8, 'max_features': 0.3968793330444372}. Best is trial 0 with value: 0.9525851666202544.
[I 2026-11-15 18:01:52,166] Trial 1 finished with value: 0.9490578297595841 and parameters: {'n_estimators': 50, 'max_depth': 4, 'min_samples_split': 2, 'max_features': 0.7348118405270448}. Best is trial 0 with value: 0.9525851666202544.
[I 2026-11-15 18:01:52,684] Trial 2 finished with value: 0.9560846560846561 and parameters: {'n_estimators': 200, 'max_depth': 12, 'min_samples_split': 2, 'max_features': 0.9330606024425664}. Best is trial 2 with value: 0.9560846560846561.
...
[I 2026-11-15 18:02:01,408] Trial 28 finished with value: 0.9578297595841455 and parameters: {'n_estimators': 150, 'max_depth': 15, 'min_samples_split': 3, 'max_features': 0.25868490694296015}. Best is trial 6 with value: 0.9578483245149911.
[I 2026-11-15 18:02:01,638] Trial 29 finished with value: 0.956093938550079 and parameters: {'n_estimators': 100, 'max_depth': 16, 'min_samples_split': 4, 'max_features': 0.353541967044737}. Best is trial 6 with value: 0.9578483245149911.
best value: 0.9578
best trial: 6
  n_estimators: 150
  max_depth: 13
  min_samples_split: 3
  max_features: 0.3267641765781762
Angka pastinya bisa berbeda, tetapi polanya konsisten. Kenaikan terbesar terjadi pada sepuluh trial pertama, lalu kurva melandai. Titik melandai itu tanda yang perlu kita baca sebelum menambah n_trials.
Memangkas Trial yang Tidak Menjanjikan dengan Pruning
Pruning memotong biaya pada level trial, bukan pada level pemilihan titik. Trial yang sudah jelas buruk di tengah proses training tidak perlu diselesaikan. Pada model bertahap seperti gradient boosting, informasi itu sudah tersedia sebelum training berakhir.
MedianPruner membandingkan nilai antara pada step tertentu dengan median trial sebelumnya. Trial yang berada di bawah ambang dihentikan, lalu muncul sebagai optuna.TrialPruned. Implementasinya butuh dua panggilan: trial.report(value, step) untuk mengirim nilai antara, dan trial.should_prune() untuk memutuskan.
!pip install optuna scikit-learn matplotlib

import optuna
import optuna.visualization.matplotlib as optuna_plots
from sklearn.datasets import load_breast_cancer
from sklearn.ensemble import GradientBoostingClassifier
from sklearn.metrics import accuracy_score
from sklearn.model_selection import train_test_split

X, y = load_breast_cancer(return_X_y=True)
X_train, X_valid, y_train, y_valid = train_test_split(
    X, y, test_size=0.25, stratify=y, random_state=42
)


def objective(trial):
    learning_rate = trial.suggest_float("learning_rate", 1e-3, 0.3, log=True)
    max_depth = trial.suggest_int("max_depth", 2, 5)
    subsample = trial.suggest_float("subsample", 0.6, 1.0)

    model = GradientBoostingClassifier(
        learning_rate=learning_rate,
        max_depth=max_depth,
        subsample=subsample,
        n_estimators=10,
        warm_start=True,
        random_state=42,
    )

    best_accuracy = 0.0
    for step in range(20, 201, 20):
        model.n_estimators = step
        model.fit(X_train, y_train)
        accuracy = accuracy_score(y_valid, model.predict(X_valid))
        best_accuracy = max(best_accuracy, accuracy)
        trial.report(best_accuracy, step)

        if trial.should_prune():
            raise optuna.TrialPruned()

    return best_accuracy


study = optuna.create_study(
    direction="maximize",
    sampler=optuna.samplers.TPESampler(seed=42),
    pruner=optuna.pruners.MedianPruner(n_startup_trials=5, n_warmup_steps=3),
)
study.optimize(objective, n_trials=25)

pruned = [t for t in study.trials if t.state == optuna.trial.TrialState.PRUNED]
print(f"pruned: {len(pruned)} dari {len(study.trials)} trial")
print("best value:", round(study.best_value, 4))
for name, value in optuna.importance.get_param_importances(study).items():
    print(f"  {name}: {value:.2f}")

optuna_plots.plot_optimization_history(study).figure.savefig(
    "public/images/blog/"
    "memahami-bayesian-optimization-dengan-optuna-untuk-hyperparameter-tuning-yang-efisien-output-1.png",
    dpi=120,
    bbox_inches="tight",
)
optuna_plots.plot_param_importances(study).figure.savefig(
    "public/images/blog/"
    "memahami-bayesian-optimization-dengan-optuna-untuk-hyperparameter-tuning-yang-efisien-output-2.png",
    dpi=120,
    bbox_inches="tight",
)
Output:
[I 2026-11-15 18:10:55,164] A new study created in memory with name: no-name-c1418e22-e256-49d2-a903-2f675c0fed86
[I 2026-11-15 18:10:55,988] Trial 0 finished with value: 0.951048951048951 and parameters: {'learning_rate': 0.008468008575248327, 'max_depth': 5, 'subsample': 0.8927975767245621}. Best is trial 0 with value: 0.951048951048951.
[I 2026-11-15 18:10:56,262] Trial 1 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.030405325392865647, 'max_depth': 2, 'subsample': 0.662397808134481}. Best is trial 1 with value: 0.965034965034965.
[I 2026-11-15 18:10:57,042] Trial 2 finished with value: 0.9440559440559441 and parameters: {'learning_rate': 0.0013927723945289009, 'max_depth': 5, 'subsample': 0.8404460046972835}. Best is trial 1 with value: 0.965034965034965.
[I 2026-11-15 18:10:57,434] Trial 3 finished with value: 0.958041958041958 and parameters: {'learning_rate': 0.05675206026988745, 'max_depth': 2, 'subsample': 0.9879639408647978}. Best is trial 1 with value: 0.965034965034965.
[I 2026-11-15 18:10:57,716] Trial 4 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.11536162338241387, 'max_depth': 2, 'subsample': 0.6727299868828402}. Best is trial 1 with value: 0.965034965034965.
...
[I 2026-11-15 18:10:58,824] Trial 12 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.043634968074672265, 'max_depth': 2, 'subsample': 0.7276435350069845}. Best is trial 1 with value: 0.965034965034965.
...
[I 2026-11-15 18:10:58,943] Trial 14 pruned.
[I 2026-11-15 18:10:59,027] Trial 15 pruned.
...
[I 2026-11-15 18:10:59,485] Trial 18 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.1649350538466648, 'max_depth': 3, 'subsample': 0.6306227442571468}. Best is trial 1 with value: 0.965034965034965.
[I 2026-11-15 18:10:59,516] Trial 19 pruned.
...
[I 2026-11-15 18:11:00,868] Trial 22 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.1644740934510564, 'max_depth': 4, 'subsample': 0.6064222862777735}. Best is trial 1 with value: 0.965034965034965.
[I 2026-11-15 18:11:00,949] Trial 23 pruned.
[I 2026-11-15 18:11:01,421] Trial 24 finished with value: 0.965034965034965 and parameters: {'learning_rate': 0.06604981254213334, 'max_depth': 4, 'subsample': 0.6177709662075365}. Best is trial 1 with value: 0.965034965034965.
pruned: 14 dari 25 trial
best value: 0.965
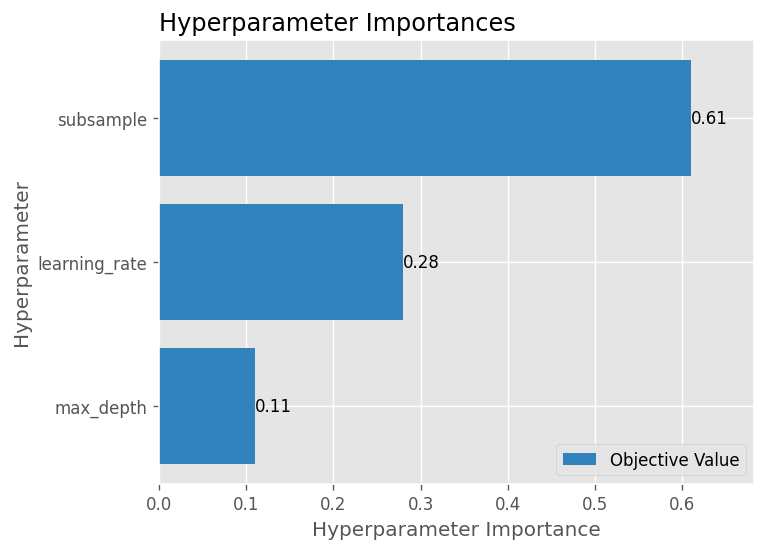
  subsample: 0.61
  learning_rate: 0.28
  max_depth: 0.11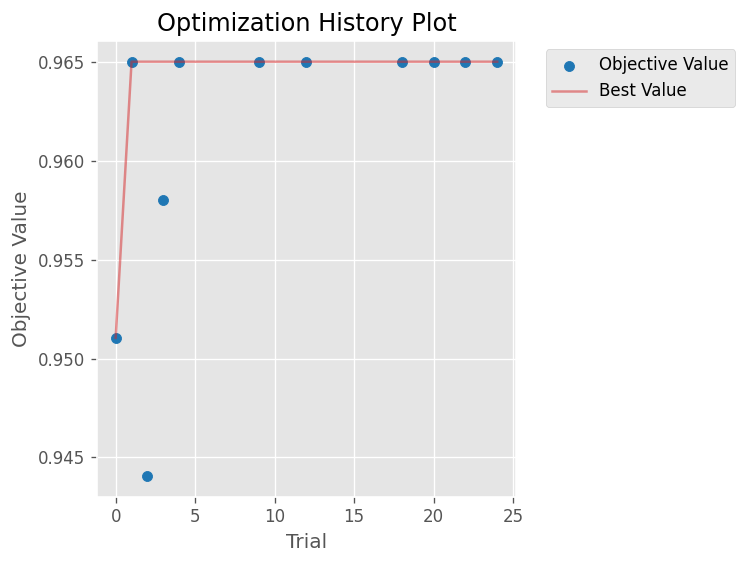
Model dilatih bertahap dengan warm_start=True. Setiap 20 tree, akurasi validasi dilaporkan ke Optuna. Jika trial tertinggal dari median pada step yang sama, eksekusi dihentikan dan sisa tree tidak pernah dilatih. n_startup_trials=5 menahan pruning sampai lima trial selesai, karena median butuh pembanding awal. n_warmup_steps=3 memberi trial baru kesempatan menyelesaikan tiga laporan pertama sebelum dinilai.
Kita juga perlu membedakan n_trials dan n_jobs. n_trials menentukan jumlah trial, sedangkan n_jobs menentukan berapa trial berjalan paralel. Pruning menjadi jauh lebih berguna ketika n_jobs lebih dari satu, karena median pembanding tersedia lebih cepat dan trial buruk berhenti lebih awal.
Setiap helper visualisasi matplotlib di Optuna membuat figure sendiri, dan sejak versi 3 helper tersebut tidak lagi menerima argumen ax. Karena itu kita panggil helper-nya satu per satu, ambil figure dari Axes yang dikembalikan, lalu simpan setiap figure sebagai file terpisah.
plot_optimization_history menampilkan skor per trial beserta nilai terbaik kumulatif. Garis histori yang mendatar menandakan ruang pencarian sudah jenuh, bukan study yang gagal. plot_param_importances mengurutkan hyperparameter berdasarkan kontribusinya terhadap skor. Hyperparameter dengan importance mendekati nol adalah kandidat untuk dihapus dari search space agar trial berikutnya lebih efisien. Pada run di atas, subsample menyumbang 0.61, learning_rate 0.28, dan max_depth 0.11.
Membandingkan Optuna dengan GridSearchCV pada Anggaran Evaluasi yang Sama
Perbandingan baru berarti jika anggaran evaluasi disamakan. Kita bandingkan 30 kombinasi grid dengan 30 trial Optuna, keduanya memakai tiga lipatan cross-validation. Total fit model sama untuk kedua metode, yaitu 90 kali.
!pip install optuna scikit-learn pandas

import time

import optuna
import pandas as pd
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import GridSearchCV, StratifiedKFold, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC

X, y = load_breast_cancer(return_X_y=True)
cv = StratifiedKFold(n_splits=3, shuffle=True, random_state=42)

param_grid = {
    "svc__C": [1, 3, 10, 30, 100, 1000],
    "svc__gamma": [1e-4, 3e-4, 1e-3, 3e-3, 1e-2],
}


def objective(trial):
    C = trial.suggest_float("C", 1e0, 1e3, log=True)
    gamma = trial.suggest_float("gamma", 1e-4, 1e-2, log=True)
    model = Pipeline(
        [
            ("scaler", StandardScaler()),
            ("svc", SVC(C=C, gamma=gamma, random_state=42)),
        ]
    )
    return cross_val_score(model, X, y, cv=cv, scoring="accuracy").mean()


start = time.perf_counter()
grid = GridSearchCV(
    Pipeline(
        [
            ("scaler", StandardScaler()),
            ("svc", SVC(random_state=42)),
        ]
    ),
    param_grid,
    cv=cv,
    scoring="accuracy",
    n_jobs=1,
)
grid.fit(X, y)
grid_seconds = time.perf_counter() - start

start = time.perf_counter()
study = optuna.create_study(
    direction="maximize", sampler=optuna.samplers.TPESampler(seed=42)
)
study.optimize(objective, n_trials=30)
optuna_seconds = time.perf_counter() - start

summary = pd.DataFrame(
    [
        {
            "method": "GridSearchCV",
            "best_score": grid.best_score_,
            "evaluations": len(grid.cv_results_["params"]) * cv.get_n_splits(),
            "seconds": grid_seconds,
        },
        {
            "method": "Optuna TPE",
            "best_score": study.best_value,
            "evaluations": 30 * cv.get_n_splits(),
            "seconds": optuna_seconds,
        },
    ]
)
print(summary.round(4).to_string(index=False))
GridSearchCV dijalankan lebih dulu sebagai baseline dengan param_grid yang setara dengan ruang pencarian Optuna. Kesetaraan itu penting: jika grid menguji nilai di luar rentang yang dijelajah TPE, perbandingan skor tidak lagi sepadan. Kedua estimator dibungkus Pipeline(StandardScaler(), SVC()). Tanpa scaling, SVC dengan gamma besar menerima fitur dengan skala berbeda dan sebagian besar trial jatuh ke akurasi kelas mayoritas 0.6274. Karena parameter berada di dalam pipeline, param_grid memakai prefix svc__. Waktu diukur dengan time.perf_counter agar mencakup seluruh proses, bukan hanya satu fit. DataFrame ringkasan menampilkan tiga kolom: skor terbaik, jumlah evaluasi, dan detik. Keluaran dari run di bawah ini:
[I 2026-11-15 18:12:06,220] A new study created in memory with name: no-name-13d3f689-3a2e-45a6-87ff-53123a83397e
[I 2026-11-15 18:12:06,228] Trial 0 finished with value: 0.978928803490207 and parameters: {'C': 13.292918943162162, 'gamma': 0.007969454818643935}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,235] Trial 1 finished with value: 0.9719205420959808 and parameters: {'C': 157.0297088405538, 'gamma': 0.0015751320499779737}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,247] Trial 2 finished with value: 0.9402673350041771 and parameters: {'C': 2.9380279387035344, 'gamma': 0.00020511104188433984}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,255] Trial 3 finished with value: 0.9648658683746403 and parameters: {'C': 1.4936568554617629, 'gamma': 0.005399484409787433}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,262] Trial 4 finished with value: 0.9701568736656455 and parameters: {'C': 63.583588566762494, 'gamma': 0.0026070247583707684}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,271] Trial 5 finished with value: 0.9666295368049754 and parameters: {'C': 1.1527987128232398, 'gamma': 0.008706020878304856}. Best is trial 0 with value: 0.978928803490207.
[I 2026-11-15 18:12:06,278] Trial 6 finished with value: 0.9736563631300473 and parameters: {'C': 314.2880890840108, 'gamma': 0.00026587543983272726}. Best is trial 0 with value: 0.978928803490207.
...
[I 2026-11-15 18:12:06,456] Trial 26 finished with value: 0.9736656455954701 and parameters: {'C': 127.94846955536872, 'gamma': 0.00011579296622483727}. Best is trial 15 with value: 0.9789288034902071.
[I 2026-11-15 18:12:06,467] Trial 27 finished with value: 0.9490485472941613 and parameters: {'C': 8.930516304800244, 'gamma': 0.00015380810240446573}. Best is trial 15 with value: 0.9789288034902071.
[I 2026-11-15 18:12:06,476] Trial 28 finished with value: 0.9613570964448157 and parameters: {'C': 3.9718487640611255, 'gamma': 0.001118268809571216}. Best is trial 15 with value: 0.9789288034902071.
[I 2026-11-15 18:12:06,484] Trial 29 finished with value: 0.9754200315603825 and parameters: {'C': 14.955487603708244, 'gamma': 0.0020880137574217157}. Best is trial 15 with value: 0.9789288034902071.
      method  best_score  evaluations  seconds
GridSearchCV      0.9789           90   0.2503
  Optuna TPE      0.9789           90   0.2649
Pada run ini kedua metode berhenti di skor yang sama, 0.9789, dengan total evaluasi yang sama dan selisih waktu sekitar 0.01 detik. Selisih sekecil itu belum bisa disebut keunggulan; skor 0.9789 sudah muncul di trial 0 dan tidak ada perbaikan berarti sampai trial 29. Pola tersebut menandakan ruang dua dimensi sudah jenuh, bukan study yang gagal. Keunggulan Optuna baru terasa ketika jumlah hyperparameter bertambah dan biaya per training naik. Grid search tumbuh eksponensial setiap kali satu hyperparameter ditambah, sementara TPE tetap sequential dan memakai histori untuk memilih titik berikutnya.
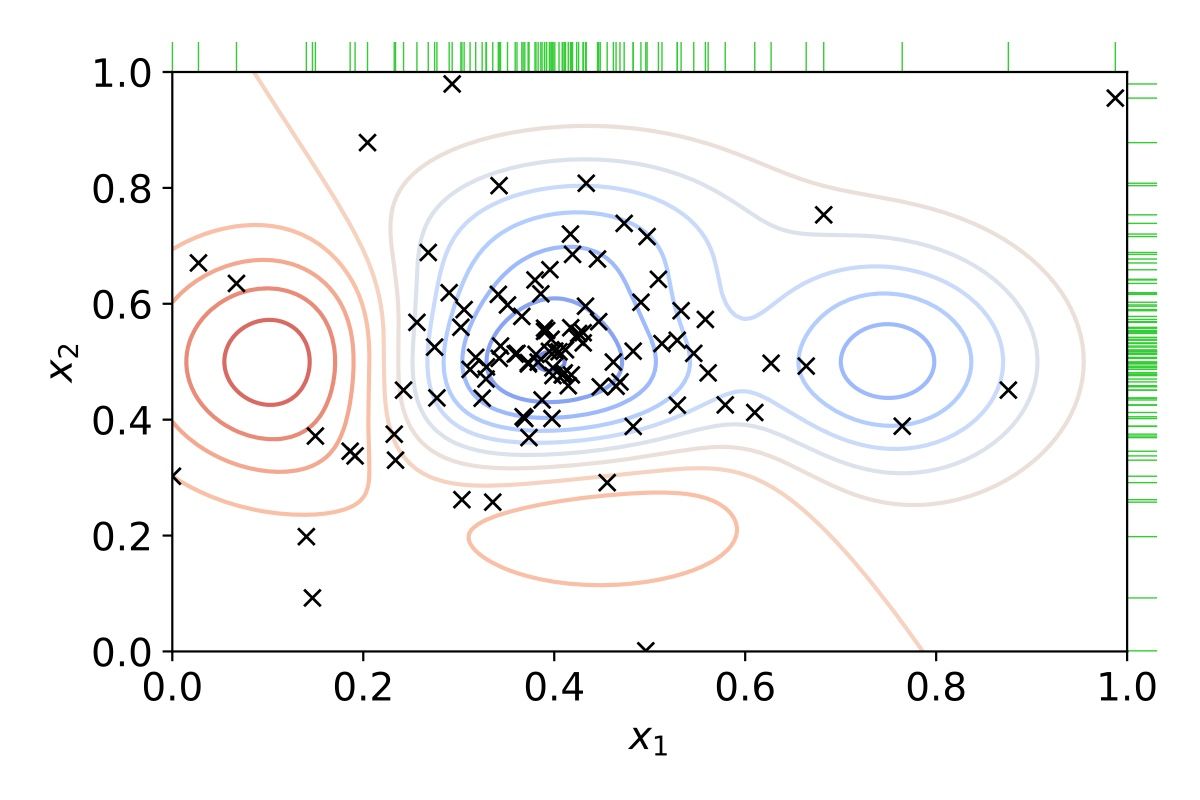
Gambar: Trial TPE mengumpul di area performa tinggi (biru), bukan tersebar merata seperti grid search, sementara garis hijau di tepi menunjukkan distribusi marginal tiap dimensi. Karya Alexander Elvers, CC BY-SA 4.0 — Sumber: Wikimedia Commons
Satu peringatan penting. Pada dataset dengan waktu training di bawah satu detik, overhead Optuna bisa menutupi keuntungannya. Selalu bandingkan terhadap baseline sebelum mengganti tool, karena optimizer otomatis bukan jaminan skor yang lebih baik.
Menyimpan Study, Menjaga Reproducibility, dan Batas Penggunaan Bayesian Optimization
Study bisa dipersistenkan ke SQLite agar optimasi berlanjut lintas sesi. Opsi storage dan load_if_exists=True membuat Optuna memuat histori yang sudah ada, lalu melanjutkan dari trial terakhir. Kita tidak perlu mengulang 30 trial hanya karena notebook ditutup.
!pip install optuna

import optuna

study = optuna.create_study(
    study_name="rf-breast-cancer",
    storage="sqlite:///optuna.db",
    load_if_exists=True,
    direction="maximize",
    sampler=optuna.samplers.TPESampler(seed=42),
)
Output:
[I 2026-11-15 18:02:32,590] A new study created in RDB with name: rf-breast-cancerTPESampler(seed=42) membuat urutan sampling dapat direproduksi, sehingga hasil antar eksperimen bisa dibandingkan. Setelah study selesai, simpan study.best_params ke file YAML atau JSON. Training produksi membaca file itu, bukan menjalankan ulang optimasi.
Bayesian optimization punya batas yang perlu kita sadari. Ruang pencarian tetap didefinisikan manual, dan metode ini tidak akan menemukan hyperparameter di luar batas tersebut. Overhead per trial juga membuatnya kurang tepat untuk model dengan waktu training sangat singkat. Risiko lain adalah overfitting pada validation set ketika trial dijalankan sangat banyak tanpa holdout terpisah.
Random search masih pilihan yang wajar untuk ruang pencarian kecil, dimensi rendah, atau anggaran di bawah 20 trial. Pada kondisi itu, keuntungan informasi historis belum cukup besar untuk menutup biaya surrogate model.
Ingin mempraktikkan alur hyperparameter tuning end-to-end, dari baseline GridSearchCV sampai study Optuna yang tersimpan? Ikuti course dan bootcamp Rumah Coding untuk latihan langsung dengan Python dan Scikit-learn.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.