Memahami Early Stopping dan Model Checkpoint: Strategi Menghentikan Training dengan PyTorch
Mengenali Tanda Model Sudah Melewati Titik Optimal
Training loss mengukur seberapa baik model menghafal data yang dilihatnya. Validation loss mengukur seberapa baik model bekerja pada data yang belum pernah dilihat. Kedua angka bergerak bersama di awal training, lalu berpisah ketika model mulai menghafal noise.
Pola overfitting yang perlu kita kenali: training loss terus turun, sementara validation loss mencapai titik terendah lalu berbalik naik. Pada eksperimen di artikel ini, training loss turun dari 0.5128 di epoch 7 menjadi 0.4698 di epoch 10. Validation loss pada rentang yang sama justru naik dari 0.3737 menjadi 0.3978. Model semakin percaya diri pada data training, tetapi prediksinya pada data validasi memburuk.
Membiarkan training berjalan setelah titik itu memberi dua kerugian. Pertama, biaya komputasi bertambah tanpa peningkatan kualitas. Kedua, bobot yang tersimpan di akhir training bukan bobot terbaik. Early stopping menghentikan proses berdasarkan sinyal generalisasi, sedangkan checkpoint memastikan bobot pada titik terbaik tidak hilang saat proses berhenti.
Kedua mekanisme ini bekerja sebagai satu paket: early stopping menentukan kapan berhenti, checkpoint menentukan bobot yang disimpan.
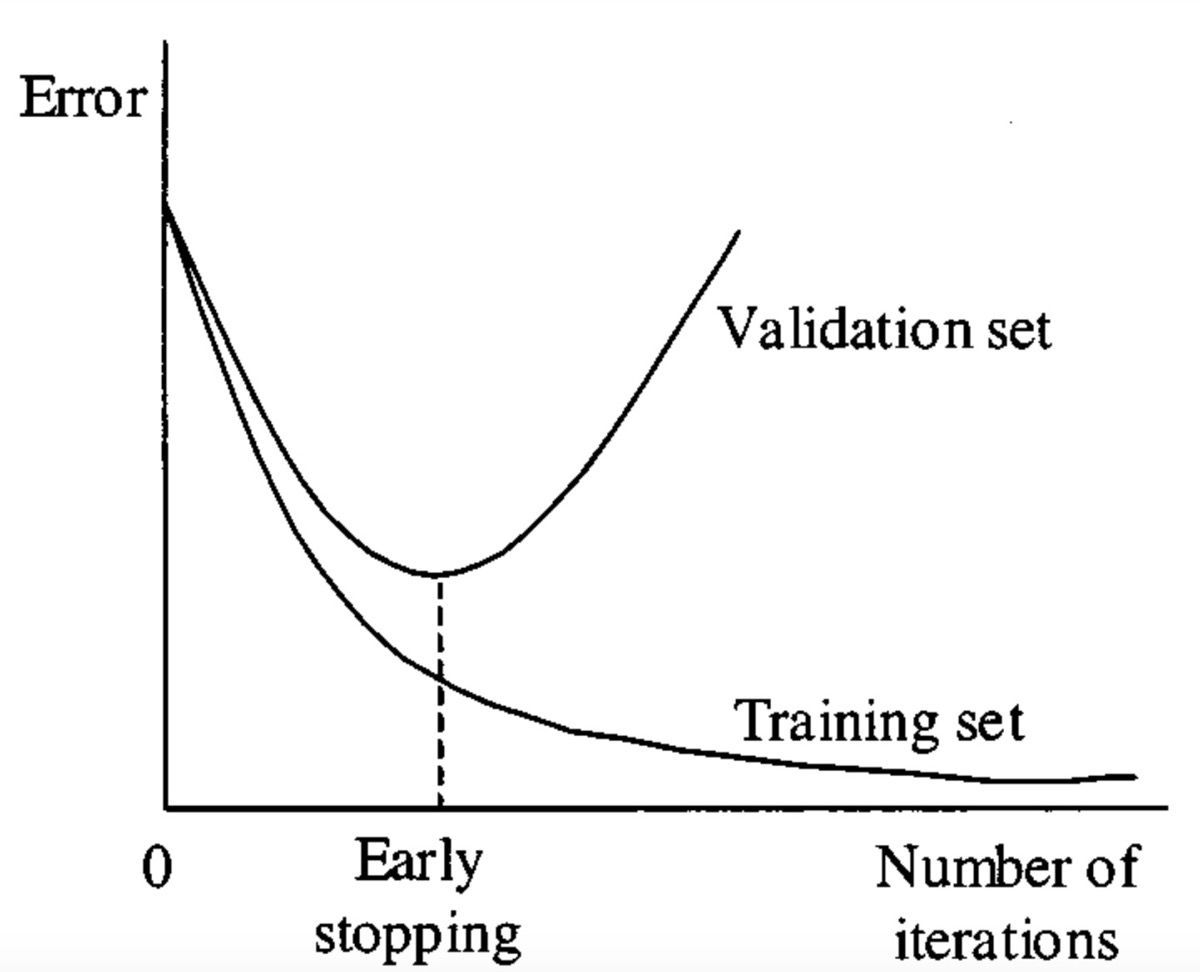
Gambar: Error pada training set terus turun, sedangkan error pada validation set berbalik naik setelah titik minimum. Early stopping memilih titik tersebut — Sumber: Wikimedia Commons, CC BY-SA 2.0, Ramazan Gençay
Logika Early Stopping Melalui Validation Loss, Patience, dan Min Delta
Early stopping bukan fitur bawaan optimizer. Kita menulisnya di dalam loop training, setelah evaluasi validasi. Urutannya: model.eval() mematikan perilaku khusus seperti dropout, torch.no_grad() menghentikan pembentukan computational graph, lalu loss dihitung pada validation set tanpa update bobot.
Aturan keputusannya sederhana. Validation loss dianggap membaik hanya jika nilainya lebih rendah dari best_loss - min_delta. Jika tidak, counter wait bertambah. Training berhenti saat wait mencapai patience. Parameter min_delta menyaring perubahan kecil yang hanya noise, sedangkan patience memberi model kesempatan melewati lembah lokal pada kurva validasi.
Blok berikut mengisolasi logika tersebut tanpa proses training.
val_losses = [0.82, 0.74, 0.68, 0.66, 0.69]
best_loss, patience, min_delta, wait = float("inf"), 2, 1e-3, 0

for epoch, loss in enumerate(val_losses, start=1):
    if loss < best_loss - min_delta:
        best_loss, wait = loss, 0
        print(f"Epoch {epoch}: membaik -> {loss:.2f}")
    else:
        wait += 1
        print(f"Epoch {epoch}: tidak membaik ({wait}/{patience})")

    if wait >= patience:
        print(f"Early stopping di epoch {epoch} | best val loss {best_loss:.2f}")
        break
Output:
Epoch 1: membaik -> 0.82
Epoch 2: membaik -> 0.74
Epoch 3: membaik -> 0.68
Epoch 4: membaik -> 0.66
Epoch 5: tidak membaik (1/2)
Epoch 4 masih dihitung sebagai perbaikan karena penurunan dari 0.68 ke 0.66 melewati min_delta. Epoch 5 berhenti dihitung sebagai perbaikan karena nilainya naik ke 0.69, tetapi wait baru mencapai 1 dari patience 2. Counter kembali ke nol hanya ketika ada penurunan yang melewati min_delta, sehingga satu fluktuasi kecil tidak langsung menghentikan training.
Untuk metric yang semakin besar semakin baik, seperti accuracy atau F1, arah perbandingan dibalik. Framework seperti Keras menyediakan parameter mode untuk itu. Pada implementasi manual, kita cukup mengganti operator perbandingan dan nilai awal best_loss.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Menyimpan Checkpoint dengan state_dict dan Memuatnya Kembali
state_dict adalah mapping dari nama parameter ke tensor. Menyimpan mapping ini lebih aman daripada menyimpan objek model utuh, karena formatnya tidak terikat pada struktur class Python dan bisa dimuat lintas versi kode. Checkpoint yang baik tidak hanya berisi bobot, tetapi juga state optimizer, nomor epoch, dan nilai metric terbaik.
State optimizer penting karena Adam menyimpan momen first dan second untuk setiap parameter. Tanpa itu, resume training memulai ulang estimasi momen dan langkah efektif berubah di awal siklus. Nomor epoch dan best score diperlukan agar log serta keputusan early stopping tetap konsisten setelah proses dimuat kembali.
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(20, 32), nn.ReLU(), nn.Linear(32, 2))
optimizer = torch.optim.Adam(model.parameters(), lr=1e-2)
torch.save(
    {"epoch": 7, "model_state": model.state_dict(),
     "optimizer_state": optimizer.state_dict(), "best_val_loss": 0.3737},
    "checkpoint.pt",
)

restored = nn.Sequential(nn.Linear(20, 32), nn.ReLU(), nn.Linear(32, 2))
state = torch.load("checkpoint.pt", map_location="cpu")
restored.load_state_dict(state["model_state"])

model.eval()
restored.eval()
x = torch.randn(4, 20)
print(f"epoch: {state['epoch']} | best val loss: {state['best_val_loss']}")
print("output identik:", torch.allclose(model(x), restored(x)))
Output:
epoch: 7 | best val loss: 0.3737
output identik: True
map_location="cpu" memastikan checkpoint yang disimpan dari mesin GPU tetap bisa dimuat di lingkungan tanpa GPU. Instance restored harus punya arsitektur yang sama persis dengan model asal. load_state_dict mencocokkan tensor berdasarkan nama, bukan berdasarkan urutan layer.
Implementasi Lengkap Early Stopping dan Checkpoint pada Dataset Sintetis
Sekarang kita gabungkan kedua mekanisme dalam satu skrip yang berjalan di CPU. Dataset dibuat dengan make_classification, lalu 20 persen label pada training set dibalik secara acak. Noise ini memancing model menghafal contoh salah, sehingga validation loss berbalik naik dalam beberapa epoch.
# !pip install torch scikit-learn
import numpy as np
import torch
import torch.nn as nn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split

torch.manual_seed(42)
X, y = make_classification(n_samples=700, n_features=20, n_informative=10,
                           n_redundant=5, flip_y=0.05, random_state=42)
X_train, X_val, y_train, y_val = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42)

rng = np.random.default_rng(0)
noise_idx = rng.choice(len(y_train), size=int(0.2 * len(y_train)), replace=False)
y_train[noise_idx] = 1 - y_train[noise_idx]

X_train = torch.tensor(X_train, dtype=torch.float32)
y_train = torch.tensor(y_train, dtype=torch.long)
X_val = torch.tensor(X_val, dtype=torch.float32)
y_val = torch.tensor(y_val, dtype=torch.long)

model = nn.Sequential(
    nn.Linear(20, 64), nn.ReLU(),
    nn.Linear(64, 32), nn.ReLU(),
    nn.Linear(32, 2),
)
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
criterion = nn.CrossEntropyLoss()
best_loss, patience, min_delta, wait = float("inf"), 3, 1e-3, 0

for epoch in range(1, 16):
    model.train()
    optimizer.zero_grad()
    train_loss = criterion(model(X_train), y_train)
    train_loss.backward()
    optimizer.step()

    model.eval()
    with torch.no_grad():
        val_loss = criterion(model(X_val), y_val).item()

    if val_loss < best_loss - min_delta:
        best_loss, wait = val_loss, 0
        torch.save(model.state_dict(), "best_model.pt")
        status = "checkpoint disimpan"
    else:
        wait += 1
        status = f"tidak membaik ({wait}/{patience})"
    print(f"Epoch {epoch:02d} | train {train_loss.item():.4f} | val {val_loss:.4f} | {status}")

    if wait >= patience:
        print(f"Early stopping di epoch {epoch} | best val loss {best_loss:.4f}")
        break

model.load_state_dict(torch.load("best_model.pt"))
model.eval()
with torch.no_grad():
    val_acc = (model(X_val).argmax(dim=1) == y_val).float().mean().item()
print(f"Bobot terbaik | accuracy {val_acc:.2%}")
Output:
Epoch 01 | train 0.7183 | val 0.6143 | checkpoint disimpan
Epoch 02 | train 0.6357 | val 0.5366 | checkpoint disimpan
Epoch 03 | train 0.5883 | val 0.4699 | checkpoint disimpan
Epoch 04 | train 0.5528 | val 0.4222 | checkpoint disimpan
Epoch 05 | train 0.5366 | val 0.3919 | checkpoint disimpan
Epoch 06 | train 0.5258 | val 0.3775 | checkpoint disimpan
Epoch 07 | train 0.5128 | val 0.3737 | checkpoint disimpan
Epoch 08 | train 0.4961 | val 0.3773 | tidak membaik (1/3)
Epoch 09 | train 0.4812 | val 0.3860 | tidak membaik (2/3)
Epoch 10 | train 0.4698 | val 0.3978 | tidak membaik (3/3)
Early stopping di epoch 10 | best val loss 0.3737
Bobot terbaik | accuracy 85.71%
Perhatikan pemisahan dua peran di dalam loop. Bagian training menghitung loss dan memperbarui bobot; bagian validasi hanya mengukur, tanpa menyentuh optimizer. Checkpoint ditulis di dalam cabang perbaikan, sehingga best_model.pt tidak pernah tertimpa oleh bobot yang lebih buruk.
Pola output di atas menunjukkan overfitting. Training loss turun konsisten dari 0.7183 ke 0.4698, sementara validation loss mencapai minimum 0.3737 di epoch 7 dan naik ke 0.3978 pada epoch 10. Selisih kedua kurva melebar, dan itulah sinyal yang dipakai patience untuk menghentikan proses.
Setelah loop selesai, kita memuat kembali best_model.pt sebelum mengukur accuracy. Langkah ini penting karena bobot di memori adalah bobot epoch terakhir. Dengan bobot epoch 7, validation accuracy mencapai 85.71 persen.
Melanjutkan Training dari Checkpoint Tanpa Kehilangan Progres
Checkpoint terbaik saja tidak cukup. Kita juga perlu checkpoint posisi terakhir, terutama ketika proses berjalan berjam-jam dan berisiko terputus. Prosedurnya: bangun ulang arsitektur model, buat optimizer baru, muat model_state_dict dan optimizer_state_dict, lalu mulai loop dari checkpoint["epoch"]. Nomor epoch harus disimpan agar loop baru melanjutkan dari titik tersebut.
Loss setelah resume melanjutkan tren penurunan, bukan kembali ke nilai awal. Efek ini berasal dari optimizer_state_dict yang memulihkan momen Adam. Tanpa state tersebut, optimizer mulai dari nol dan loss biasanya melonjak karena arah pembaruan kehilangan riwayat.
Untuk training yang memakai learning rate scheduler, simpan juga scheduler.state_dict() dan pulihkan setelah optimizer. Pada implementasi early stopping manual, sertakan best_loss, wait, dan epoch di checkpoint agar keputusan berhenti tetap konsisten. Checkpoint periodik setiap beberapa epoch melindungi proses panjang dari pemutusan.
Praktik Terbaik Menentukan Metric, Mode, dan Retensi Checkpoint
Pilih metric yang selaras dengan tujuan model. Validation loss cocok untuk pemantauan umum karena tidak bergantung pada threshold. Pada dataset tidak seimbang, F1 atau recall lebih informatif karena accuracy bisa tinggi meski model mengabaikan kelas minoritas.
Skala min_delta harus mengikuti skala metric. Perubahan 0.001 berarti besar untuk cross entropy di bawah 0.1, tetapi tidak berarti untuk loss di kisaran 5.0. patience yang umum dipakai berada di rentang 3 sampai 10 epoch. Nilai terlalu kecil menghentikan training sebelum keluar dari plateau, sedangkan nilai terlalu besar membuang komputasi.
Tetapkan max_epochs sebagai batas atas dan early stopping sebagai penghenti sebenarnya. Untuk retensi, simpan checkpoint terbaik dan beberapa checkpoint terakhir dengan nama yang memuat epoch serta nilai metric, misalnya epoch=07-val=0.3737.pt. Pola ini memudahkan audit tanpa menimpa riwayat.
Frekuensi penyimpanan sebaiknya mengikuti durasi training, bukan jumlah epoch. Pada run yang memakan waktu berjam-jam, interval 10 sampai 15 menit lebih aman daripada menyimpan setiap epoch. Ukuran file juga perlu dihitung: satu checkpoint model kecil bisa mencapai puluhan megabyte, sedangkan model besar bisa melewati satu gigabyte. Simpan hanya checkpoint terbaik dan beberapa checkpoint terakhir, lalu hapus sisanya secara berkala. Sebelum menjalankan training panjang, lakukan smoke test dengan memuat ulang satu checkpoint untuk memastikan arsitektur, nama parameter, dan versi library masih cocok.
Terakhir, jangan pernah memakai test set sebagai dasar early stopping. Keputusan berhenti harus berasal dari validation set, dan test set hanya dievaluasi sekali di akhir. Catat kurva training dan validation ke TensorBoard atau Weights & Biases agar setiap keputusan berhenti punya jejak audit.
Early stopping dan checkpoint adalah dua kontrol dasar yang membedakan eksperimen cepat dari pipeline training yang dapat diulang. Di bootcamp Deep Learning Rumah Coding, kita membahas alur training, evaluasi model, dan pengelolaan eksperimen secara terstruktur, mulai dari penyusunan validation set hingga penyimpanan artefak model yang siap dipakai ulang.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.