Memahami Konsep Inferensi Bayesian dan Implementasinya dengan PyMC untuk Estimasi Parameter
Mengapa Estimasi Titik Sering Menyesatkan dan Apa yang Ditawarkan Inferensi Bayesian
Dalam statistika frequentist, parameter populasi dianggap sebagai nilai tetap yang tidak diketahui. Estimasi titik seperti rata-rata sampel berusaha menebak nilai itu, lalu kita melaporkan standard error dan confidence interval sebagai ukuran ketidakpastian. Confidence interval memiliki interpretasi yang sering disalahpahami: jika prosedur sampling diulang banyak kali, 95% interval yang terbentuk akan memuat parameter sebenarnya, bukan probabilitas bahwa parameter berada di dalam interval tertentu.
Inferensi Bayesian mengambil sudut pandang berbeda. Parameter diperlakukan sebagai variabel acak yang memiliki distribusi. Sebelum melihat data, kita menyatakan keyakinan awal melalui prior. Data observasi masuk melalui likelihood. Kombinasi keduanya menghasilkan posterior, yaitu distribusi keyakinan setelah data diperbarui. Hubungan ini dirumuskan oleh teorema Bayes:
P(θ | y) = P(y | θ) × P(θ) / P(y)
Penyebut P(y) hanya konstanta normalisasi, sehingga dalam praktik kita sering menulis posterior sebanding dengan likelihood dikali prior. Output berupa distribusi memberi keuntungan langsung. credible interval 94% berarti terdapat probabilitas 94% bahwa parameter berada dalam rentang tersebut, sesuai dengan pertanyaan yang benar-benar ingin kita jawab.
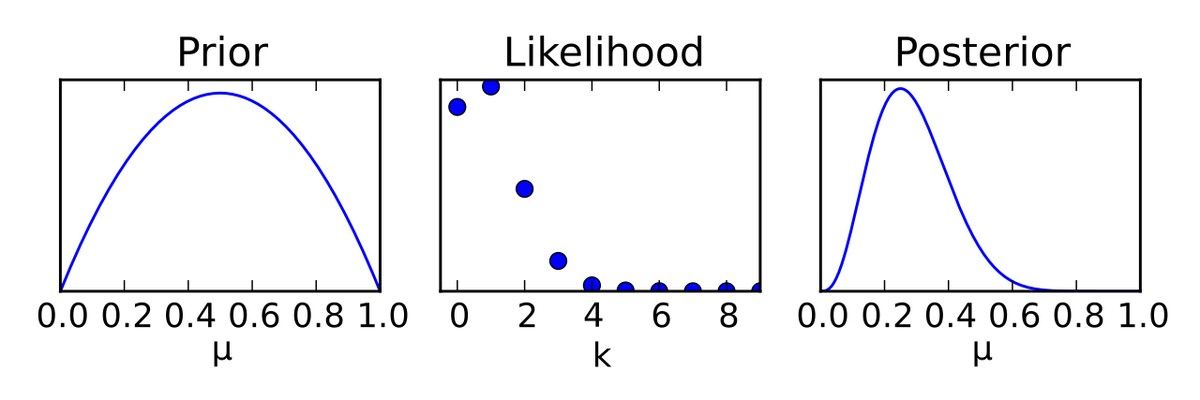
Gambar: Ilustrasi prior, likelihood, dan posterior dalam inferensi Bayesian — Sumber: Wikimedia Commons
Perbedaan filosofis ini juga mengubah cara kita melaporkan hasil. Alih-alih menyebut satu angka sebagai estimasi terbaik, kita menyajikan distribusi lengkap beserta rentang nilai yang plausibel. Ketika stakeholder bertanya seberapa yakin kita pada sebuah keputusan, jawabannya bisa dinyatakan sebagai probabilitas yang dihitung langsung dari posterior. Pendekatan ini paling berguna ketika data terbatas, pengetahuan domain kuat, atau keputusan membutuhkan kuantifikasi ketidakpastian yang eksplisit.
Membangun Model Probabilistik Pertama dengan PyMC
PyMC menyediakan bahasa deklaratif untuk menulis model probabilistik, sementara ArviZ menangani diagnostik dan visualisasi. Instalasi kedua library dilakukan sekali di awal notebook.
!pip install pymc arviz matplotlibStudi kasus yang kita pakai adalah tingkat konversi halaman: dari 1000 kunjungan, 42 berakhir menjadi transaksi. Kita memodelkan probabilitas konversi p dengan prior Beta(2, 20), yang menempatkan sebagian besar massa probabilitas pada nilai rendah. Likelihood-nya adalah Binomial dengan n=1000 dan p dari prior tersebut.
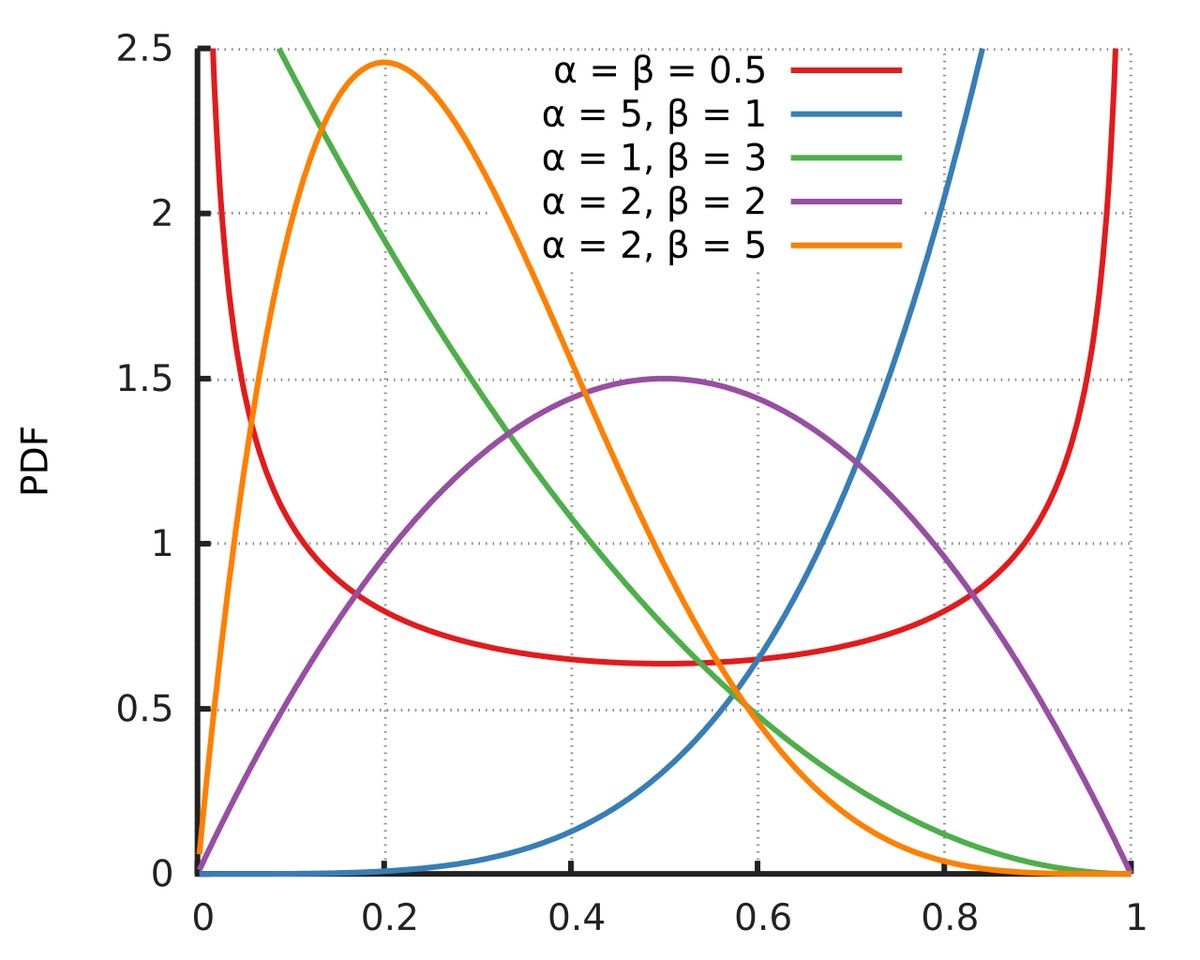
Gambar: Bentuk distribusi Beta untuk berbagai nilai α dan β — Sumber: Wikimedia Commons
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pymc as pm

n_visits = 1000
n_conversions = 42

with pm.Model() as model_konversi:
    p_konversi = pm.Beta("p_konversi", alpha=2, beta=20)
    konversi = pm.Binomial("konversi", n=n_visits, p=p_konversi, observed=n_conversions)
    lift = pm.Deterministic("lift", p_konversi - 0.03)

prior = pm.sample_prior_predictive(draws=1000, random_seed=42, model=model_konversi)
sampel_prior = prior.prior["p_konversi"].values.flatten()

print(f"Rata-rata prior: {sampel_prior.mean():.4f}")
print(f"Interval 94%: {np.percentile(sampel_prior, [3, 97]).round(4)}")

fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(sampel_prior, bins=40, density=True, color="steelblue", alpha=0.8)
ax.set_xlabel("p_konversi")
ax.set_ylabel("Density")
ax.set_title("Distribusi Prior Tingkat Konversi")
Output:
Rata-rata prior: 0.0900
Interval 94%: [0.0137 0.2355]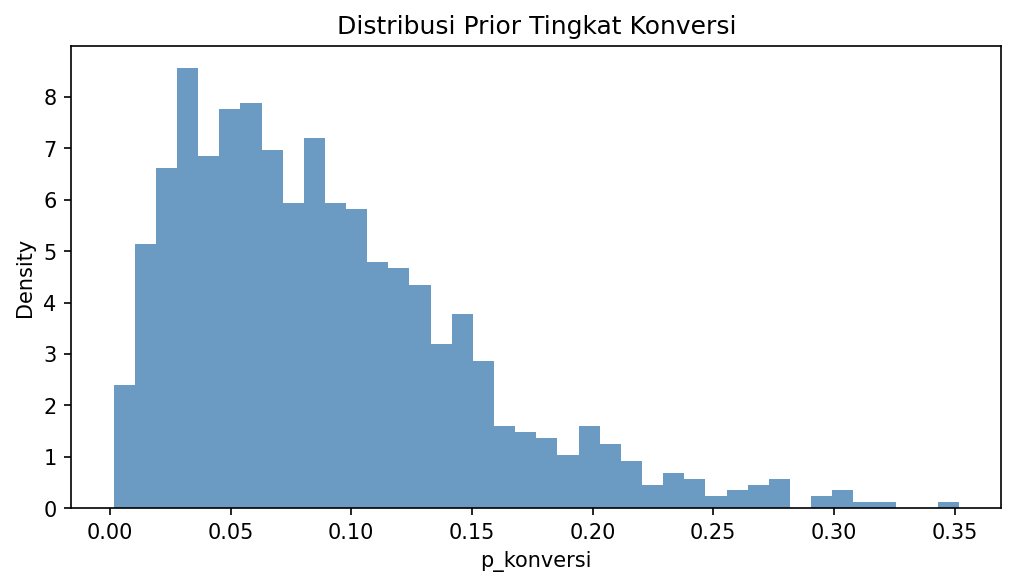
Blok with pm.Model(): adalah wadah graph probabilistik. Setiap variabel acak yang dideklarasikan di dalamnya menjadi node, dan PyMC melacak hubungan antar-node secara otomatis. pm.Deterministic menyimpan transformasi parameter, pada contoh ini lift terhadap baseline 3%, sehingga bisa dianalisis bersama parameter lain.
pm.sample_prior_predictive menarik sampel dari prior sebelum data observasi dipakai. Pemeriksaan ini penting: jika distribusi prior menghasilkan nilai yang tidak masuk akal secara bisnis, misalnya tingkat konversi di atas 80%, asumsi kita perlu direvisi sebelum sampling dijalankan.
Menjalankan Sampling MCMC dan Membaca Diagnostik Konvergensi
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Posterior jarang memiliki solusi analitik tertutup, terutama ketika model melibatkan banyak parameter. Markov Chain Monte Carlo (MCMC) mendekati posterior dengan membangun rantai sampel yang, setelah cukup lama, berdistribusi mendekati posterior target.
import matplotlib.pyplot as plt
import arviz as az
import pymc as pm

with model_konversi:
    trace_konversi = pm.sample(
        draws=1000,
        tune=1000,
        chains=2,
        target_accept=0.9,
        random_seed=42,
        progressbar=False,
    )

ringkasan = az.summary(trace_konversi, var_names=["p_konversi", "lift"], hdi_prob=0.94)
print(ringkasan)

az.plot_trace(trace_konversi, var_names=["p_konversi"])
Output:
             mean     sd  hdi_3%  hdi_97%  mcse_mean  mcse_sd  ess_bulk  ess_tail  r_hat
p_konversi  0.043  0.006   0.031    0.054        0.0      0.0     549.0     716.0    1.0
lift        0.013  0.006   0.001    0.024        0.0      0.0     549.0     716.0    1.0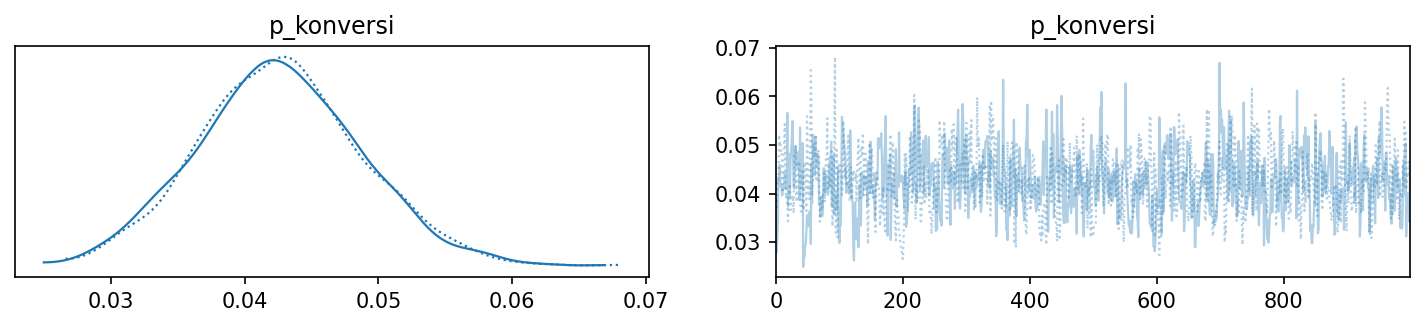
Parameter draws menentukan jumlah sampel yang disimpan per chain, sedangkan tune adalah iterasi pemanasan yang dibuang. Nilai chains=2 menjalankan dua rantai independen, dan perbandingan antar-rantai inilah yang menjadi dasar diagnostik. target_accept=0.9 menaikkan acceptance rate yang diminta sehingga sampler melangkah lebih hati-hati, sementara random_seed=42 menjaga hasil tetap reproduktif.
Tiga diagnostik wajib diperiksa. r_hat mengukur kesamaan antar-rantai dan harus mendekati 1.0, umumnya di bawah 1.01. effective sample size menunjukkan jumlah sampel efektif setelah memperhitungkan autokorelasi; nilai di bawah 400 per parameter menjadi sinyal peringatan. divergences harus nol, karena divergensi menandakan sampler gagal menjelajahi geometri posterior.
az.summary menampilkan mean, standard deviation, hdi_3%, hdi_97%, dan diagnostik di atas. Interval hdi_3% sampai hdi_97% adalah highest density interval 94%: rentang terpendek yang memuat 94% massa posterior. az.plot_trace menampilkan dua panel per parameter — kepadatan posterior di kiri dan jejak sampel per chain di kanan. Rantai yang tercampur baik akan terlihat seperti noise stasioner tanpa tren.
Memvalidasi Model dengan Posterior Predictive Check
Model yang konvergen belum tentu cocok dengan data. Posterior predictive check menguji kecocokan dengan membangkitkan data simulasi dari posterior, lalu membandingkannya dengan observasi asli.
import numpy as np
import matplotlib.pyplot as plt
import pymc as pm

with model_konversi:
    pm.sample_posterior_predictive(trace_konversi, extend_inferencedata=True, random_seed=42)

simulasi = trace_konversi.posterior_predictive["konversi"].values.flatten()
print(f"Rata-rata simulasi: {simulasi.mean():.1f}")
print(f"Observasi: {n_conversions}")

fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(simulasi, bins=30, density=True, color="gray", alpha=0.7, label="Simulasi")
ax.axvline(n_conversions, color="crimson", linestyle="--", linewidth=2, label="Observasi")
ax.set_xlabel("Jumlah konversi per 1000 kunjungan")
ax.set_ylabel("Density")
ax.set_title("Posterior Predictive Check")
ax.legend()
Output:
Rata-rata simulasi: 42.7
Observasi: 42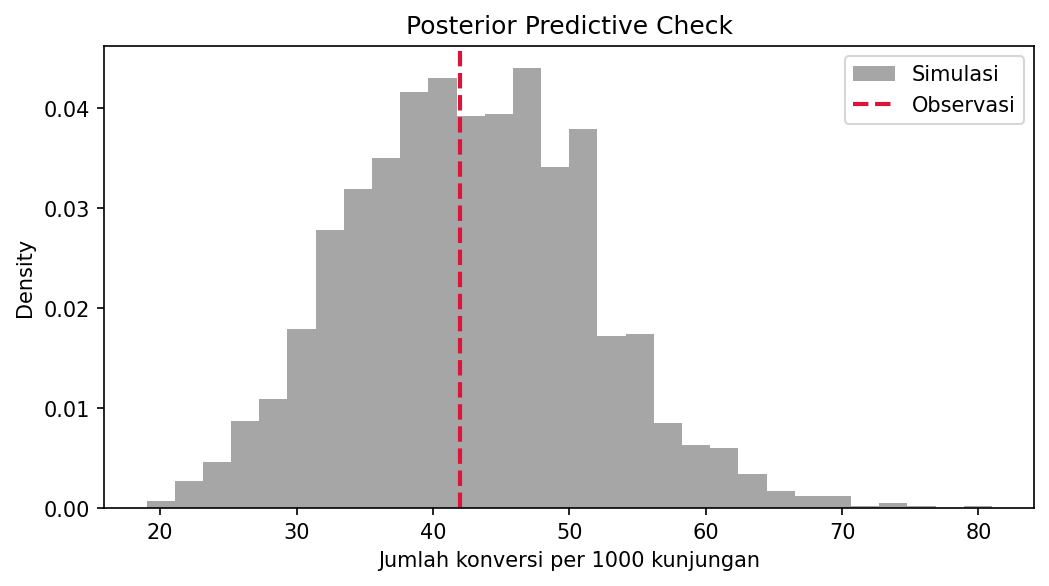
extend_inferencedata=True menyimpan hasil simulasi ke objek trace yang sama, sehingga sampel posterior dan posterior predictive tetap terhubung. Setiap sampel parameter menghasilkan satu set data sintetis, dan kumpulan inilah yang kita bandingkan dengan nilai observasi.
Perlu ditegaskan bahwa pemeriksaan ini tidak membuktikan model benar. Posterior predictive check hanya menunjukkan apakah model cukup mampu mereproduksi pola data yang diamati; model lain dengan likelihood berbeda bisa saja lolos pemeriksaan yang sama.
Pola interpretasinya sederhana. Jika posisi data aktual berada di ekor distribusi simulasi atau sama sekali di luar jangkauannya, likelihood kurang tepat menggambarkan proses yang menghasilkan data. Pada kondisi ini kita merevisi likelihood atau menambah struktur model. Jika data aktual masih berada dalam rentang simulasi namun rentangnya terlalu lebar, masalahnya bukan pada bentuk model melainkan pada jumlah data; menambah observasi akan mempersempit posterior. Untuk model konversi di atas, nilai 42 konversi seharusnya berada dekat pusat distribusi simulasi karena likelihood Binomial memang dibangun dari data tersebut.
Menerapkan Inferensi Bayesian pada Regresi Linear Sederhana
Pola yang sama berlaku untuk regresi. Alih-alih satu intersep dan satu slope, kita menetapkan prior pada alpha, beta, dan sigma, lalu menghubungkan prediktor ke parameter lokasi likelihood Normal.
import numpy as np
import pymc as pm
import arviz as az

rng = np.random.default_rng(42)
x = rng.normal(50, 10, size=200)
y = 3.0 + 0.8 * x + rng.normal(0, 4, size=200)

x_std = (x - x.mean()) / x.std()
y_mean, y_std = y.mean(), y.std()
y_scaled = (y - y_mean) / y_std

with pm.Model() as model_regresi:
    alpha = pm.Normal("alpha", mu=0, sigma=1)
    beta = pm.Normal("beta", mu=0, sigma=1)
    sigma = pm.HalfNormal("sigma", sigma=1)
    mu = alpha + beta * x_std
    y_obs = pm.Normal("y_obs", mu=mu, sigma=sigma, observed=y_scaled)

    trace_regresi = pm.sample(
        draws=1000,
        tune=1000,
        chains=2,
        target_accept=0.9,
        random_seed=42,
        progressbar=False,
    )

print(az.summary(trace_regresi, var_names=["alpha", "beta", "sigma"]))
Output:
        mean     sd  hdi_3%  hdi_97%  mcse_mean  mcse_sd  ess_bulk  ess_tail  r_hat
alpha -0.001  0.038  -0.068    0.072      0.001    0.001    1688.0    1369.0    1.0
beta   0.855  0.038   0.783    0.927      0.001    0.001    2368.0    1264.0    1.0
sigma  0.520  0.027   0.474    0.573      0.001    0.001    1751.0    1114.0    1.0
Standardisasi fitur dan target bukan formalitas. Prior default Normal(0, 1) pada beta menyatakan bahwa perubahan satu standard deviation pada x menggeser y sekitar satu standard deviation, asumsi yang masuk akal pada skala terstandardisasi. Tanpa standardisasi, beta bisa berada pada orde 0.01 atau 1000 tergantung satuan, sehingga prior yang sama menjadi terlalu sempit atau terlalu lebar.
Kita membaca posterior beta sebagai rentang nilai yang plausibel, bukan angka tunggal. Jika hdi_3% dan hdi_97% sama-sama positif, hubungan positif didukung data. Untuk memeriksa konsistensi, bandingkan arah dan skala estimasi dengan statsmodels atau scikit-learn pada data yang sama. Perbedaan kecil pada titik estimasi wajar terjadi; yang perlu sama adalah tanda koefisien dan besaran efek setelah dikembalikan ke skala asli.
Proses pengembalian ke skala asli dilakukan dengan mengalikan beta dengan standard deviation y lalu membaginya dengan standard deviation x. Langkah ini penting ketika kita ingin menyatakan efek dalam satuan pengukuran asli, misalnya perubahan satu unit pada x menggeser y sebesar berapa unit.
Praktik Terbaik dalam Pemodelan Bayesian dengan PyMC
Prior weakly informative adalah titik awal yang aman. Prior seperti Normal(0, 1) pada skala terstandardisasi atau HalfNormal(1) untuk sigma membatasi nilai ekstrem tanpa memaksakan kesimpulan. Hindari prior yang sangat sempit kecuali ada justifikasi dari domain, karena prior semacam itu mendominasi likelihood dan membuat data tidak lagi berpengaruh.
Divergensi ditangani secara bertahap. Naikkan target_accept ke 0.95 atau 0.99 terlebih dahulu, lalu periksa kembali trace. Jika divergensi tetap muncul, reparameterisasi model, misalnya mengganti parameterisasi centered menjadi non-centered pada hierarchical model, atau ubah skala fitur.
Biaya komputasi meningkat seiring jumlah parameter dan kompleksitas likelihood. Mulai dari model kecil, periksa diagnostik, lalu tingkatkan kompleksitas satu langkah setiap iterasi. Model yang gagal konvergen tidak layak diperbesar.
Reproduksibilitas membutuhkan disiplin. Simpan random_seed, versi pymc dan arviz, serta data yang dipakai. Tanpa catatan ini, hasil sampling sulit direproduksi ketika library diperbarui atau data berubah.
Ketika beberapa kandidat model tersedia, bandingkan dengan az.compare yang menghitung expected log pointwise predictive density melalui leave-one-out cross-validation. Perbandingan ini lebih informatif daripada memilih model berdasarkan r_hat saja, karena r_hat hanya menilai kualitas sampling, bukan kualitas prediksi.
Fondasi statistika yang kuat membuat model machine learning lebih mudah dipahami dan dievaluasi. Jika kita ingin mempelajari alur tersebut secara terstruktur, mulai dari probabilitas, inferensi, hingga implementasi di Python, Rumah Coding menyediakan kelas dan bootcamp dengan studi kasus nyata. Kita bisa memulai dari satu model kecil, menjalankan diagnostiknya, lalu membangun pemahaman dari hasil yang nyata.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model