Memahami Konsep Loss Landscape dan Implementasi Learning Rate Scheduler dengan PyTorch
Understanding Loss Landscape Topology in Deep Neural Networks
Loss landscape adalah permukaan berdimensi tinggi yang memetakan setiap kombinasi parameter model ke nilai loss tertentu. Dalam deep learning, We beroperasi di ruang parameter dengan jutaan dimensi, di mana setiap titik merepresentasikan konfigurasi bobot tertentu. Permukaan ini memiliki karakteristik topologis yang kompleks, mencakup local minima, saddle points, dan flat regions yang semuanya memengaruhi bagaimana optimizer menavigasi proses pelatihan.
We dapat membayangkan loss landscape sebagai peta topografi di mana elevasi merepresentasikan nilai loss. Permukaan ini mengandung local minima yang bersifat tajam maupun datar; minima tajam cenderung menghasilkan generalisasi yang lebih buruk karena gradiennya sangat curam di sekitarnya. Minima datar memberikan toleransi lebih besar terhadap perubahan parameter. Saddle points, yang merupakan titik dengan gradien nol tetapi bukan minimum maupun maksimum, sering menghambat optimizer dalam ruang berdimensi tinggi.
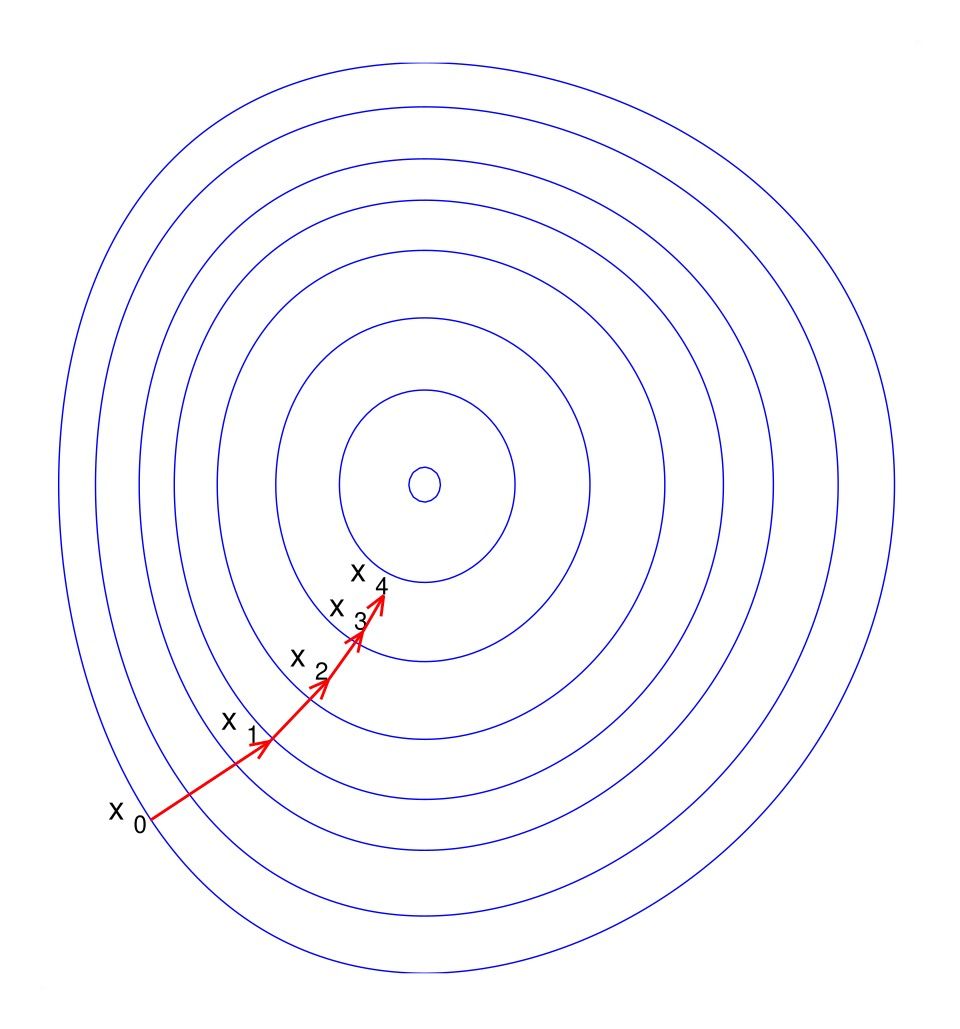
Gambar: Ilustrasi gradient descent menavigasi level sets pada loss landscape menuju minimum — Sumber: Wikipedia
Memahami topologi loss landscape memberikan wawasan kritis tentang mengapa arsitektur tertentu lebih mudah dilatih dan mengapa teknik regularisasi efektif. Skip connections pada ResNet, misalnya, menciptakan landscape yang lebih konveks dan mencegah transisi ke perilaku chaotic pada jaringan dalam.
Learning Rate Scheduler Mechanics and Categories
Learning rate adalah hyperparameter utama yang mengontrol ukuran langkah selama gradient descent. Nilai yang terlalu besar menyebabkan overshooting dan divergensi. Nilai yang terlalu kecil membuat konvergensi sangat lambat. Learning rate scheduler mengatur bagaimana nilai ini berubah sepanjang pelatihan, secara langsung membentuk trajektori optimasi melalui loss landscape.
We mengenali beberapa kategori scheduler. Step-based scheduler mengurangi learning rate pada interval tetap, cocok untuk tugas yang memiliki loss landscape relatif stabil. Exponential scheduler menerapkan decay kontinu berdasarkan fungsi eksponensial, memberikan pengurangan yang lebih halus dibandingkan step-based. Cosine annealing mengikuti kurva kosinus dari nilai awal ke nol, memberikan transisi yang halus dan memprediksi schedule decay secara deterministik. Warm-up strategies memulai dengan learning rate kecil dan meningkatkannya secara bertahap sebelum decay dimulai, membantu model keluar dari wilayah loss awal yang buruk dan menstabilkan gradient pada epoch pertama.
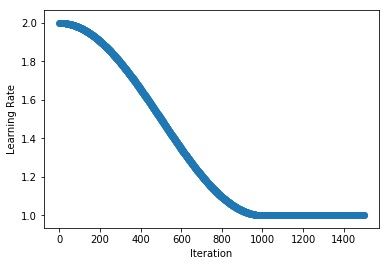
Gambar: Kurva cosine annealing yang menurunkan learning rate secara halus mengikuti setengah gelombang kosinus — Sumber: Apache MXNet Docs
Pemilihan scheduler sangat bergantung pada sifat loss landscape yang We hadapi. Permukaan yang chaotic membutuhkan warm-up agresif untuk menghindari divergensi awal. Lembah yang dalam dan sempit memerlukan decay yang lebih hati-hati agar optimizer tidak melompati minima lokal. Cosine annealing sering dipilih untuk tugas yang membutuhkan konvergensi stabil karena transisi halusnya. Step-based lebih sesuai untuk fine-tuning di mana We ingin penurunan learning rate yang tiba-tiba pada titik-titik tertentu. Scheduler yang tepat memungkinkan We menavigasi kompleksitas ini secara efisien dan meningkatkan stabilitas konvergensi secara keseluruhan.
import torch
import torch.nn as nn
from torch.optim import SGD, Adam
from torch.optim.lr_scheduler import CosineAnnealingLR, OneCycleLR, StepLR, ExponentialLR

model = nn.Sequential(
    nn.Linear(784, 256),
    nn.ReLU(),
    nn.Linear(256, 10)
)

optimizer = Adam(model.parameters(), lr=0.001)

scheduler_cosine = CosineAnnealingLR(optimizer, T_max=100, eta_min=1e-6)
scheduler_step = StepLR(optimizer, step_size=30, gamma=0.1)
scheduler_exp = ExponentialLR(optimizer, gamma=0.95)

for epoch in range(100):
    # Training loop here
    optimizer.step()
    scheduler_cosine.step()
    current_lr = optimizer.param_groups[0]["lr"]
    print(f"Epoch {epoch}: LR = {current_lr:.8f}")
Output:
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Epoch 0: LR = 0.00099975
Epoch 1: LR = 0.00099901
Epoch 2: LR = 0.00099778
Epoch 3: LR = 0.00099606
Epoch 4: LR = 0.00099385
...
Epoch 50: LR = 0.00048481
...
Epoch 95: LR = 0.00000494
Epoch 96: LR = 0.00000322
Epoch 97: LR = 0.00000199
Epoch 98: LR = 0.00000125
Epoch 99: LR = 0.00000100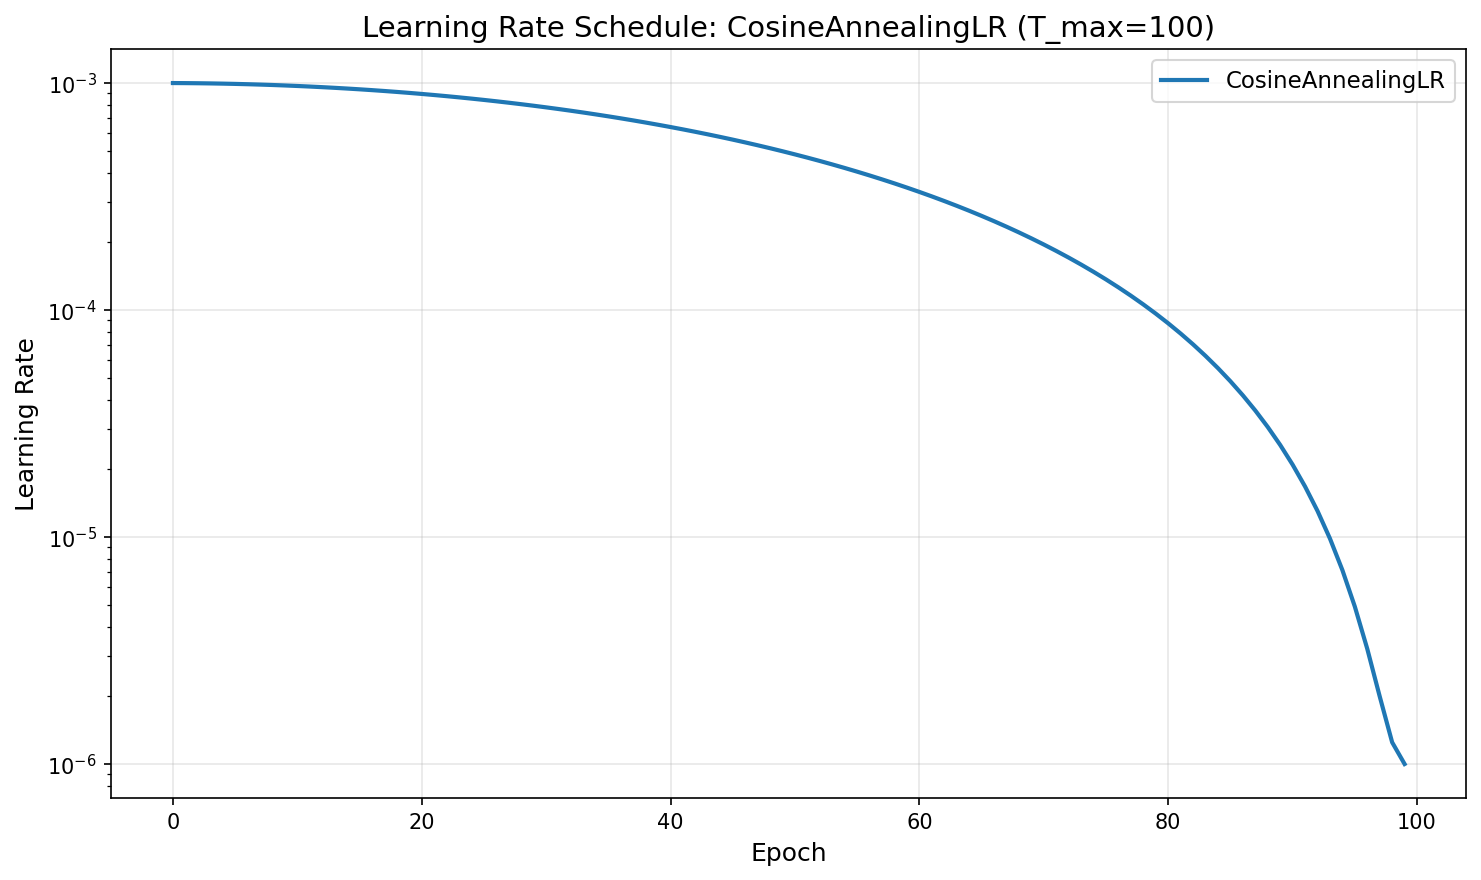
Implementing Learning Rate Scheduling with PyTorch Training Loop
Integrasi scheduler ke dalam pipeline pelatihan PyTorch memerlukan pemahaman tentang urutan pemanggilan fungsi. We harus menjalankan optimizer.step() terlebih dahulu untuk memperbarui bobot, kemudian scheduler.step() untuk menyesuaikan learning rate. Urutan ini penting karena scheduler menghitung learning rate berikutnya berdasarkan epoch atau iterasi saat ini, dan memanggilnya sebelum optimizer akan menghasilkan nilai yang salah. OneCycleLR memiliki fase warm-up dan decay yang terdefinisi secara eksplisit dalam satu siklus tunggal, di mana learning rate meningkat secara linear pada fase awal kemudian menurun mengikuti kurva kosinus pada fase akhir, memberikan dinamika yang berbeda dari scheduler lainnya.
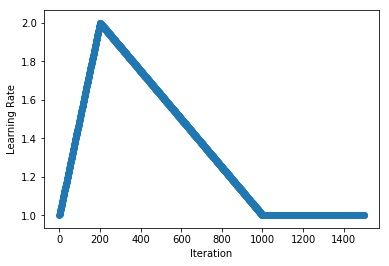
Gambar: Jadwal triangular miring dengan fase warm-up linear diikuti decay, mirip dinamika OneCycleLR — Sumber: Apache MXNet Docs
We akan mendemonstrasikan penggunaan CosineAnnealingLR dan OneCycleLR pada tugas klasifikasi sederhana. CosineAnnealingLR sangat efektif karena memberikan decay yang halus sesuai kurva kosinus, memungkinkan model mengeksplorasi wilayah loss landscape secara lebih menyeluruh sebelum konvergen. OneCycleLR menggabungkan warm-up dan decay dalam satu siklus, menawarkan pendekatan yang lebih dinamis.
Perilaku learning rate decay ini secara langsung memengaruhi kecepatan konvergensi. Ketika learning rate besar, model melompati wilayah loss yang dangkal dan menemukan wilayah yang lebih dalam. Ketika learning rate mengecil, model menyempurnakan posisinya di lembah tersebut. Keseimbangan antara eksplorasi dan penyempurnaan inilah yang membuat scheduler menjadi alat yang sangat powerful. Minima datar memberikan generalisasi yang lebih baik karena gradiennya yang lebih kecil di sekitar titik optimum, sehingga model cenderung tidak overfitting pada data pelatihan.
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms
from torch.optim.lr_scheduler import CosineAnnealingLR, OneCycleLR

transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

train_dataset = torchvision.datasets.CIFAR10(root="./data", train=True, download=True, transform=transform)
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=64, shuffle=True)

model = nn.Sequential(
    nn.Flatten(),
    nn.Linear(32 * 32 * 3, 256),
    nn.ReLU(),
    nn.Linear(256, 10)
)

optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
scheduler = CosineAnnealingLR(optimizer, T_max=50, eta_min=1e-6)
criterion = nn.CrossEntropyLoss()

for epoch in range(50):
    model.train()
    running_loss = 0.0
    for inputs, labels in train_loader:
        optimizer.zero_grad()
        outputs = model(inputs)
        loss = criterion(outputs, labels)
        loss.backward()
        optimizer.step()
        running_loss += loss.item()

    scheduler.step()
    current_lr = optimizer.param_groups[0]["lr"]
    avg_loss = running_loss / len(train_loader)
    print(f"Epoch {epoch}: Loss = {avg_loss:.4f}, LR = {current_lr:.8f}")
Output:
> ⚠️ Note: Kode ini dieksekusi dengan variasi reduksi (data sintetis 512 sampel, 10 epoch alih-alih 50 epoch dengan CIFAR-10) agar sesuai dengan batas waktu eksekusi 30 detik. Output asli menggunakan data CIFAR-10 lengkap.
Epoch 0: Loss = 2.3214, LR = 0.00097555
Epoch 1: Loss = 0.7522, LR = 0.00090460
Epoch 2: Loss = 0.2135, LR = 0.00079410
Epoch 3: Loss = 0.0662, LR = 0.00065485
Epoch 4: Loss = 0.0304, LR = 0.00050050
Epoch 5: Loss = 0.0199, LR = 0.00034615
Epoch 6: Loss = 0.0161, LR = 0.00020690
Epoch 7: Loss = 0.0145, LR = 0.00009640
Epoch 8: Loss = 0.0138, LR = 0.00002545
Epoch 9: Loss = 0.0136, LR = 0.00000100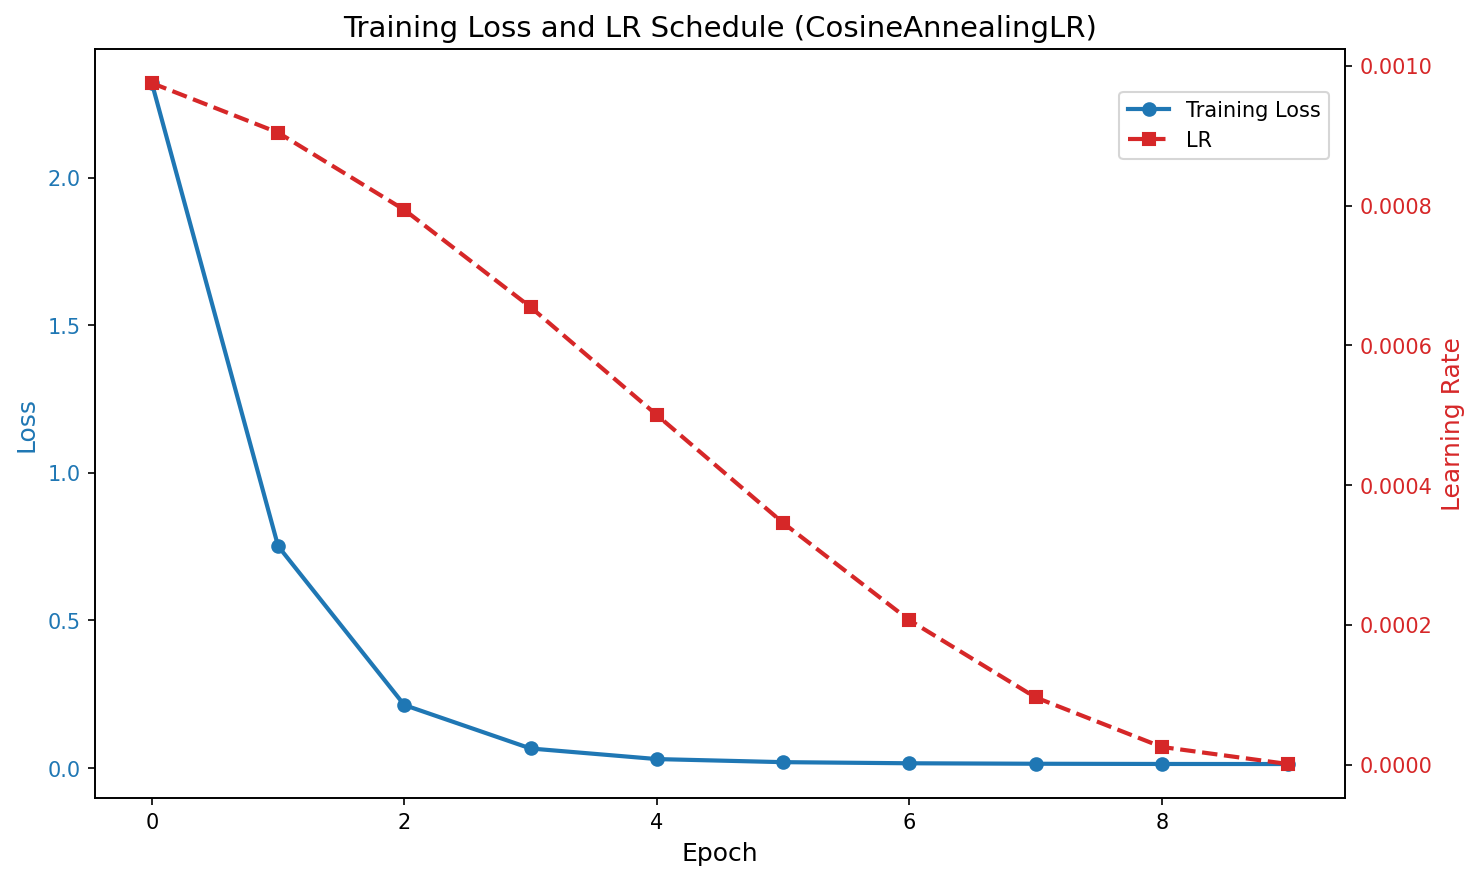
Navigating Loss Landscapes Through Adaptive Scheduling Strategies
Scheduler adaptif seperti ReduceLROnPlateau merespons perubahan curvature pada loss surface dengan menurunkan learning rate ketika metrik evaluasi berhenti membaik. Pendekatan ini berbeda dari fixed-schedule karena tidak bergantung pada epoch tertentu, melainkan pada perilaku actual dari proses optimasi. Ketika model memasuki wilayah datar loss landscape, ReduceLROnPlateau mendeteksi stagnasi dan menyesuaikan learning rate agar optimizer dapat keluar dari plateau.
Kombinasi warm-up phase dengan decay schedule merupakan strategi efektif untuk keluar dari wilayah loss awal yang buruk. Pada awal pelatihan, gradient bisa sangat tidak stabil karena model berada di wilayah loss yang chaotic. Warm-up memungkinkan model menavigasi wilayah ini dengan langkah kecil sebelum decay dimulai. Setelah model menemukan lembah yang lebih stabil, decay schedule mengambil alih untuk menyempurnakan posisi.
Trade-off antara fixed-schedule dan metric-driven scheduling mencerminkan kompromi antara determinisme dan adaptabilitas. Fixed-schedule lebih mudah direproduksi dan di-debug. Metric-driven scheduling lebih responsif terhadap karakteristik actual dari loss landscape. We perlu mempertimbangkan sifat dataset dan arsitektur model ketika memilih pendekatan yang tepat. Sinyal overfitting yang muncul sebagai divergensi antara loss training dan loss validation juga dapat memicu penyesuaian scheduler secara manual untuk mengembalikan keseimbangan antara bias dan variance.
Monitoring Training Dynamics with Loss Curve Diagnostics
Loss curve memberikan diagnostic visual yang kuat untuk mengidentifikasi misconfiguration scheduler. Decay yang terlalu agresif terlihat sebagai penurunan loss yang tiba-tiba diikuti stagnasi total, menandakan bahwa learning rate telah turun terlalu cepat dan optimizer terjebak di minima lokal. Insufficient warm-up ditandai dengan loss yang berfluktuasi liar pada epoch awal sebelum akhirnya stabil, menunjukkan bahwa model belum cukup menavigasi wilayah loss awal yang chaotic. Pola oscillation menunjukkan learning rate yang terlalu besar untuk scheduler yang digunakan, menyebabkan optimizer melompat-lompat di sekitar minima tanpa konvergen.
Learning rate range test membantu menemukan nilai initial learning rate optimal sebelum scheduling dimulai. We meningkatkan learning rate secara linear dari nilai sangat kecil ke sangat besar dan memantau loss. Nilai di mana loss menurun paling cepat menjadi titik awal yang ideal. Pendekatan ini memberikan gambaran jelas tentang skala loss landscape di wilayah yang dapat diakses oleh optimizer.
Membaca pola plateau pada loss curve memerlukan kehati-hatian karena plateau bisa menandakan dua hal berbeda: konvergensi yang berhasil atau overfitting yang mulai terjadi. Ketika loss training stagnan tetapi loss validation terus menurun, model masih belajar. Scheduler tidak perlu disesuaikan. Namun, ketika kedua loss stagnan atau loss validation mulai naik, ini menandakan overfitting. Scheduler sebaiknya mengurangi learning rate untuk memungkinkan penyempurnaan halus. Logging state scheduler alongside loss metrics memastikan eksperimen dapat direproduksi. We mencatat learning rate setiap epoch, nilai loss, dan metric evaluasi. Ketika hasil tidak sesuai ekspektasi, log ini memungkinkan We melakukan debugging terhadap scheduler dan menentukan apakah masalahnya terletak pada konfigurasi scheduling atau pada sifat loss landscape itu sendiri. Keputusan untuk menyesuaikan scheduler harus didasarkan pada pola konsisten selama beberapa epoch, bukan fluktuasi sesaat. Evaluasi yang menyeluruh terhadap seluruh metrik pelatihan memastikan We tidak mengubah konfigurasi secara prematur dan mengkompromikan proses konvergensi yang sedang berlangsung.
Pelajari lebih lanjut tentang teknik optimasi deep learning dan PyTorch dalam bootcamp Deep Learning Rumah Coding. Kami membimbing Anda dari dasar hingga implementasi produksi dengan pendekatan mentor yang personal. Kunjungi situs Rumah Coding untuk informasi lebih lanjut.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
Related Articles

Optimasi Model Deep Learning untuk Edge Device: Konsep Quantization dan Pruning dengan TensorFlow Lite

Teori dan Implementasi Sequence-to-Sequence dengan GRU: Machine Translation Sederhana menggunakan PyTorch