Memahami Konsep Object Detection dengan Faster R-CNN: Teori Region Proposal dan Implementasi dengan PyTorch
Mengapa Deteksi Dua Tahap Masih Dipakai untuk Objek Kecil yang Berdesakan
Model satu tahap seperti YOLO dan SSD memprediksi kotak serta kelas langsung dari feature map dalam satu kali forward pass. Setiap lokasi grid bertanggung jawab atas objek di areanya, sehingga keputusan diambil sekali pada resolusi yang sudah diperkecil beberapa kali.
Faster R-CNN memakai dua tahap. Tahap pertama menghasilkan kandidat kotak melalui _region proposal network_, lalu tahap kedua memeriksa setiap kandidat dengan fitur yang diambil khusus dari area tersebut. Kandidat eksplisit membantu saat objek kecil, saling menutup, dan berada di latar ramai. Anchor multi-skala menjaga sensitivitas pada objek kecil, sementara crop fitur yang terfokus memisahkan objek berdesakan.
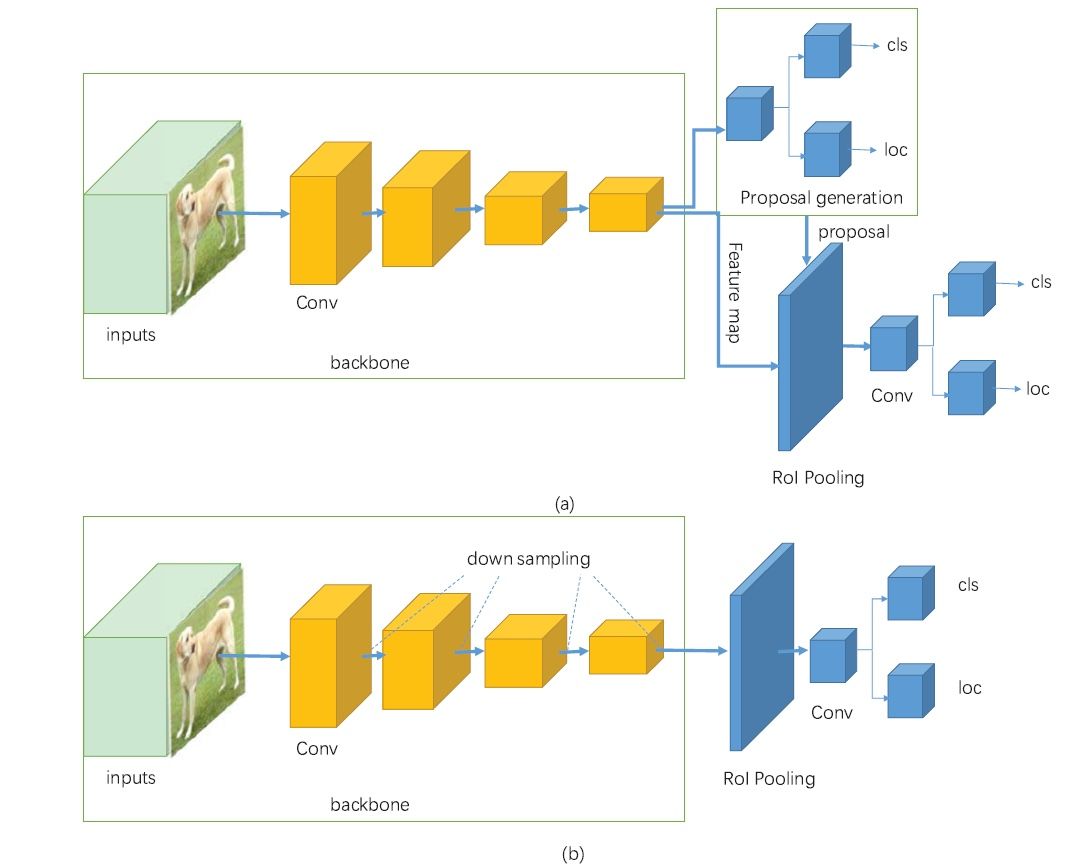
Gambar: Arsitektur detektor dua tahap (a) yang memisahkan proposal generation, RoI Pooling, lalu dua head klasifikasi dan regresi, dibandingkan detektor satu tahap (b) — Sumber: Wikimedia Commons (Licheng Jiao et al., CC BY 4.0)
Biaya yang ditukar juga nyata. Dua tahap berarti dua rangkaian komputasi ditambah sampling fitur per kandidat. Latensi inference naik dan pipeline memanjang, sehingga model satu tahap sering lebih dipilih pada perangkat berdaya terbatas.
Faster R-CNN lahir sebagai pengganti _Selective Search_ pada R-CNN dan Fast R-CNN. Metode lama menghasilkan kandidat dari segmentasi citra berbasis CPU, sekitar dua detik per gambar, dan tidak belajar dari data. RPN memindahkan proses tersebut ke dalam jaringan, sehingga kandidat dihasilkan oleh fitur yang sama dengan yang dipakai klasifikasi dan dilatih bersama seluruh model.
Cara Region Proposal Network Menyaring Kandidat Kotak Objek
Backbone seperti ResNet atau MobileNet memproses gambar menjadi feature map dengan stride 16. Di atas feature map tersebut, RPN menjalankan konvolusi 3x3 lalu bercabang menjadi dua head 1x1. Head pertama memprediksi objectness score, yaitu peluang sebuah anchor berisi objek. Head kedua memprediksi empat delta regresi untuk menggeser dan menskalakan anchor agar mendekati kotak objek sebenarnya.
Setiap lokasi pada feature map memiliki beberapa anchor dengan skala dan rasio aspek berbeda. Kombinasi tiga skala dan tiga rasio menghasilkan sembilan anchor per lokasi, sehingga feature map 10x10 memiliki 900 kandidat awal. Anchor dengan IoU minimal 0.7 terhadap ground truth diberi label positif, di bawah 0.3 negatif, dan sisanya diabaikan.
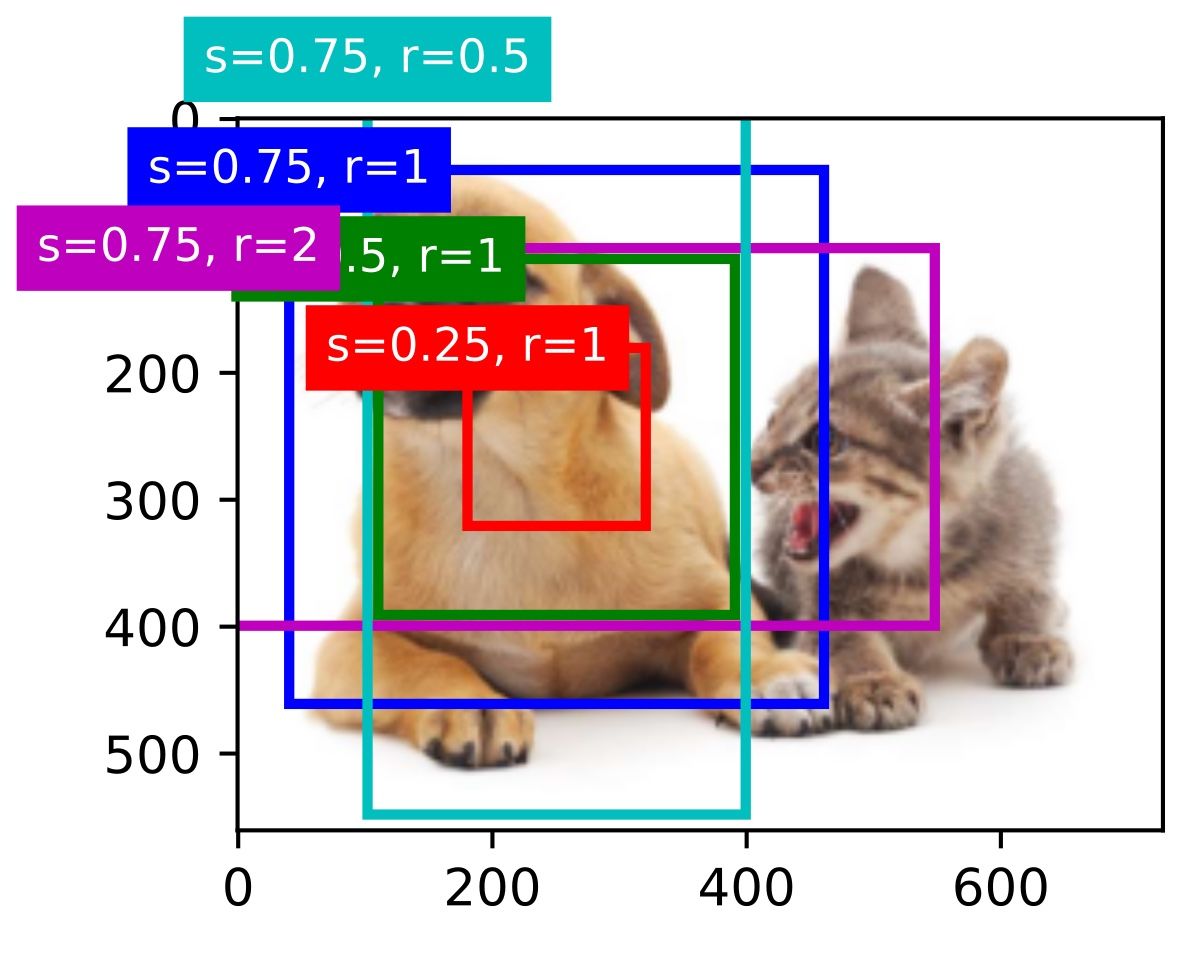
Gambar: Anchor dengan skala (s) dan rasio aspek (r) berbeda di sekitar satu titik pusat, dasar pembentukan kandidat kotak pada RPN — Sumber: Dive into Deep Learning (CC BY-SA 4.0)
Sampling menjaga komposisi batch tetap seimbang. RPN mengambil sekitar 256 sampel per gambar dengan proporsi mendekati 1:1 antara positif dan negatif. Tanpa sampling, anchor negatif yang dominan menenggelamkan sinyal objek.
Loss RPN terdiri dari dua bagian. Klasifikasi biner memakai _cross entropy_ atas objectness score, sedangkan regresi kotak memakai smooth L1 dan hanya dihitung pada anchor positif. Normalisasi dilakukan terhadap jumlah anchor yang dipakai, sehingga skala loss tidak berubah ketika ukuran gambar berubah.
Kandidat yang tumpang tindih kemudian disaring dengan non-maximum suppression. Proposal diurutkan berdasarkan skor, lalu kotak dengan IoU di atas ambang tertentu dibuang. Nilai nms_thresh yang rendah menyisakan sedikit kotak paling meyakinkan, sedangkan nilai tinggi mempertahankan lebih banyak kotak yang saling berdekatan.
!pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu

import torch
from torchvision.ops import box_iou, nms

stride, feat_size = 16, 10
scales, ratios = [64, 128], [0.5, 1.0, 2.0]

centers = torch.arange(feat_size) * stride + stride / 2
grid_y, grid_x = torch.meshgrid(centers, centers, indexing="ij")
anchors = []
for scale in scales:
    for ratio in ratios:
        width = scale * (ratio ** 0.5)
        height = scale / (ratio ** 0.5)
        boxes = torch.stack(
            [grid_x - width / 2, grid_y - height / 2,
             grid_x + width / 2, grid_y + height / 2],
            dim=-1,
        )
        anchors.append(boxes.reshape(-1, 4))
anchors = torch.cat(anchors)
print(f"anchor: {tuple(anchors.shape)}")

gt_boxes = torch.tensor([[20, 30, 90, 110], [60, 40, 140, 150]], dtype=torch.float32)
iou = box_iou(anchors, gt_boxes)
max_iou, _ = iou.max(dim=1)
positive = max_iou >= 0.5
negative = max_iou < 0.3
print(f"positif: {positive.sum().item()} ({positive.float().mean().item():.2%})")
print(f"negatif: {negative.sum().item()}")

keep = nms(anchors, max_iou, iou_threshold=0.3)
print(f"proposal lolos NMS: {keep.numel()}")
for idx in keep[:5]:
    box = anchors[idx].round().tolist()
    print(f"  idx={idx.item():3d} iou={max_iou[idx].item():.3f} box={box}")
Output:
anchor: (600, 4)
positif: 18 (3.00%)
negatif: 412
proposal lolos NMS: 29
  idx=143 iou=0.731 box=[24.0, 40.0, 88.0, 104.0]
  idx=455 iou=0.537 box=[24.0, 24.0, 152.0, 152.0]
  idx= 55 iou=0.465 box=[65.0, 43.0, 111.0, 133.0]
  idx=176 iou=0.444 box=[72.0, 88.0, 136.0, 152.0]
  idx= 57 iou=0.427 box=[97.0, 43.0, 143.0, 133.0]
Kode di atas membangun 600 anchor dari feature map 10x10 dan menghitung matriks IoU berukuran 600x2 terhadap dua ground truth. Ambang 0.5 menghasilkan 18 anchor positif atau sekitar 3 persen. nms dengan ambang 0.3 menyisakan 29 proposal beserta skor dan koordinatnya.
Menyelaraskan Fitur dengan RoI Align Sebelum Kepala Klasifikasi
Setiap proposal memiliki koordinat pecahan pada skala gambar. RoI Pooling membulatkan koordinat ke batas sel terdekat sebelum membagi area menjadi bin dan mengambil nilai maksimum. Pada stride 16 satu sel mewakili 16 piksel, sehingga pergeseran kecil langsung menggeser isi bin secara signifikan.
RoI Align menghindari kuantisasi. Koordinat proposal dipertahankan dalam bentuk pecahan, lalu nilai fitur diambil melalui interpolasi bilinear pada titik sampel di dalam setiap bin. Parameter sampling_ratio menentukan jumlah titik sampel per bin, dan nilai 2 biasanya cukup untuk menjaga akurasi tanpa menambah biaya terlalu besar.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Parameter spatial_scale memetakan koordinat gambar ke koordinat feature map. Untuk backbone dengan stride 16, nilainya 1/16. Kesalahan pada parameter ini membuat seluruh kotak bergeser, sehingga fitur yang diambil berasal dari area yang salah meskipun koordinat proposal benar.
Setelah RoI Align, dua kepala memproses fitur berukuran tetap. Kepala klasifikasi menghasilkan skor untuk setiap kelas ditambah background, sedangkan kepala regresi menghasilkan empat delta per kelas untuk memperbaiki kotak. Delta tersebut diterapkan pada proposal asli, bukan pada kotak hasil pembulatan.
Dampak alignment paling terasa pada objek kecil. Kotak berukuran 32 piksel hanya mencakup dua sel feature map pada stride 16. Kuantisasi setengah sel sudah memindahkan seperempat isi kotak, sehingga informasi tepi objek hilang sebelum kepala klasifikasi melihatnya.
!pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu

import torch
from torchvision.ops import roi_align, roi_pool

feature_map = torch.rand(1, 8, 8, 8)
boxes = torch.tensor([[0.0, 0.0, 0.0, 40.0, 40.0],
                      [0.0, 30.0, 30.0, 140.0, 120.0]])
spatial_scale = 1 / 16

aligned = roi_align(feature_map, boxes, output_size=(4, 4),
                    spatial_scale=spatial_scale, sampling_ratio=2)
pooled = roi_pool(feature_map, boxes, output_size=(4, 4),
                  spatial_scale=spatial_scale)

print("roi_align:", tuple(aligned.shape))
print(aligned.mean(dim=1).round(decimals=2))
print("roi_pool:", tuple(pooled.shape))
print(pooled.mean(dim=1).round(decimals=2))
print("selisih rata-rata:", (aligned - pooled).abs().mean().item())
Output:
roi_align: (2, 8, 4, 4)
tensor([[[0.4900, 0.3900, 0.4200, 0.4400],
         [0.5100, 0.4300, 0.4500, 0.4700],
         [0.6100, 0.4500, 0.4200, 0.4200],
         [0.6400, 0.4600, 0.3800, 0.3900]],

        [[0.4800, 0.4600, 0.4300, 0.2200],
         [0.4900, 0.3800, 0.4200, 0.2500],
         [0.5500, 0.4600, 0.5400, 0.2700],
         [0.4900, 0.5200, 0.4500, 0.1900]]])
roi_pool: (2, 8, 4, 4)
tensor([[[0.5500, 0.3400, 0.4500, 0.2900],
         [0.5400, 0.4200, 0.5100, 0.3900],
         [0.8100, 0.4300, 0.3400, 0.5100],
         [0.4200, 0.4100, 0.4300, 0.5700]],

        [[0.7500, 0.8300, 0.7300, 0.0000],
         [0.8000, 0.7200, 0.8800, 0.0000],
         [0.8700, 0.8200, 0.8800, 0.0000],
         [0.5700, 0.6400, 0.5300, 0.0000]]])
selisih rata-rata: 0.23769107460975647
Kedua operator menghasilkan bentuk yang sama: dua region dengan 8 kanal dan grid 4x4. Perbedaannya terlihat pada nilai per sel. roi_pool menampilkan kolom bernilai 0.00 untuk kotak kedua karena sebagian area berada di luar feature map dan terkena clamping, sementara roi_align tetap menghasilkan nilai hasil interpolasi. Selisih rata-rata sekitar 0.24 menunjukkan kedua operator membaca isi fitur dengan cara berbeda.
Melatih Faster R-CNN di Dataset Kecil dengan Loop Training Manual
Dataset deteksi tidak memakai tensor gambar dan label terpisah seperti klasifikasi. Setiap sampel berisi gambar dan dict target dengan boxes berformat [x0, y0, x1, y1] berskala piksel, labels berupa integer dengan 0 disimpan untuk background, serta image_id. PyTorch tidak menyediakan kelas dataset bawaan untuk format ini, sehingga kita menulis kelas kecil sendiri.
Pada contoh berikut, dataset sintetis berisi empat gambar 128x128 dengan dua persegi berwarna sebagai objek berlabel 1 dan 2. Konversi ke tensor dilakukan eksplisit dengan pil_to_tensor karena versi torchvision terbaru tidak lagi menerima objek PIL langsung di forward model deteksi.
Model dibangun dengan weights=None dan weights_backbone=None. Kedua argumen tersebut mencegah unduhan bobot pretrained, sehingga kode berjalan offline dan hanya memakai inisialisasi acak. Nilai num_classes=3 mencakup background dan dua kelas objek, sedangkan min_size serta max_size diperkecil agar forward dan backward pass tetap cepat di CPU.
Satu langkah training mengikuti urutan tetap. Model diubah ke mode train, gambar dan target dikirim sebagai list, lalu output berupa dict loss. Total loss dihitung dari penjumlahan seluruh komponen, gradien dibersihkan, backward dijalankan, dan optimizer memperbarui bobot.
Bobot pretrained COCO dipakai ketika data terbatas dan kita butuh fitur yang sudah mengenali tepi serta tekstur. Pelatihan dari nol pada data sintetis dipakai untuk memastikan pipeline berjalan, karena tujuannya bukan akurasi melainkan validasi alur data, loss, dan update bobot.
!pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
!pip install pillow

import torch
from PIL import Image, ImageDraw
from torch.utils.data import Dataset
from torchvision.models.detection import fasterrcnn_mobilenet_v3_large_fpn
from torchvision.transforms.functional import pil_to_tensor

class KotakDataset(Dataset):
    def __init__(self, size=128, count=4):
        self.samples = []
        colors = [(220, 80, 60), (60, 120, 220)]
        for i in range(count):
            image = Image.new("RGB", (size, size), (245, 245, 240))
            draw = ImageDraw.Draw(image)
            boxes, labels = [], []
            for j in range(2):
                x0, y0 = 12 + 20 * j + 6 * i, 20 + 24 * j
                x1, y1 = x0 + 36, y0 + 40
                draw.rectangle([x0, y0, x1, y1], fill=colors[j])
                boxes.append([x0, y0, x1, y1])
                labels.append(j + 1)
            self.samples.append((
                image,
                {"boxes": torch.tensor(boxes, dtype=torch.float32),
                 "labels": torch.tensor(labels, dtype=torch.int64),
                 "image_id": torch.tensor([i])},
            ))

    def __len__(self):
        return len(self.samples)

    def __getitem__(self, idx):
        return self.samples[idx]

dataset = KotakDataset()
model = fasterrcnn_mobilenet_v3_large_fpn(
    weights=None, weights_backbone=None, num_classes=3,
    min_size=128, max_size=160,
)
model.train()
optimizer = torch.optim.SGD(
    [p for p in model.parameters() if p.requires_grad], lr=0.005, momentum=0.9
)

image, target = dataset[0]
image_tensor = pil_to_tensor(image).float() / 255.0
loss_dict = model([image_tensor], [target])
total_loss = sum(loss_dict.values())
optimizer.zero_grad()
total_loss.backward()
optimizer.step()

for name, value in loss_dict.items():
    print(f"{name}: {value.item():.4f}")
Output:
loss_classifier: 1.1116
loss_box_reg: 0.0346
loss_objectness: 0.6895
loss_rpn_box_reg: 0.0161
Output yang diharapkan berupa empat nilai loss, yaitu loss_classifier, loss_box_reg, loss_objectness, dan loss_rpn_box_reg. Pada langkah pertama dengan bobot acak, loss_classifier dan loss_objectness berada di sekitar 1.0 dan 0.7, sedangkan dua komponen regresi jauh lebih kecil. Nilai tepatnya berubah setiap kali dijalankan karena inisialisasi bobot dan sampling anchor bersifat acak.
Membaca Output Inference dan Menilai Kualitas Deteksi
Saat model.eval() dipanggil, model mengembalikan list berisi satu dict per gambar. Setiap dict memiliki boxes dengan koordinat piksel absolut, labels berisi indeks kelas, dan scores berisi probabilitas. Tidak ada padding dan tidak ada batch dimensi di dalam tensor, sehingga jumlah baris berbeda untuk setiap gambar.
score_thresh menentukan batas minimum skor agar deteksi ditampilkan, sedangkan nms_thresh menentukan seberapa agresif kotak yang tumpang tindih dihapus. Menurunkan score_thresh menambah jumlah deteksi dan menaikkan recall, tetapi juga menambah false positive. Menaikkan nms_thresh mempertahankan kotak berdekatan, sementara nilai rendah menghapus objek yang berdesakan.
Visualisasi memakai matplotlib dengan backend Agg agar tidak membutuhkan layar. Kotak digambar sebagai Rectangle, label dan skor ditempel di sudut kiri atas, lalu figur disimpan ke file PNG. Penyimpanan ke file penting pada server atau notebook non-interaktif.
Evaluasi kualitas deteksi memakai IoU sebagai dasar pencocokan. precision mengukur proporsi deteksi benar dari seluruh deteksi, recall mengukur proporsi objek yang berhasil ditemukan, dan mAP merangkum keduanya pada beberapa ambang IoU.
!pip install torch torchvision --index-url https://download.pytorch.org/whl/cpu
!pip install pillow matplotlib

import torch
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from PIL import Image, ImageDraw
from torchvision.models.detection import fasterrcnn_mobilenet_v3_large_fpn
from torchvision.transforms.functional import pil_to_tensor

image = Image.new("RGB", (128, 128), (245, 245, 240))
draw = ImageDraw.Draw(image)
draw.rectangle([20, 24, 56, 64], fill=(220, 80, 60))
draw.rectangle([64, 40, 100, 80], fill=(60, 120, 220))

model = fasterrcnn_mobilenet_v3_large_fpn(
    weights=None, weights_backbone=None, num_classes=3,
    min_size=128, max_size=160,
)
model.roi_heads.score_thresh = 0.05
model.roi_heads.nms_thresh = 0.4
model.eval()
with torch.no_grad():
    output = model([pil_to_tensor(image).float() / 255.0])[0]

boxes = output["boxes"][:10]
scores = output["scores"][:10]
labels = output["labels"][:10]
print(f"jumlah deteksi: {output['boxes'].shape[0]}")
print(f"skor tertinggi: {output['scores'].max().item():.4f}")

fig, ax = plt.subplots(figsize=(4, 4))
ax.imshow(image)
for box, score, label in zip(boxes, scores, labels):
    x0, y0, x1, y1 = box.tolist()
    ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0,
                               fill=False, edgecolor="lime", linewidth=2))
    ax.text(x0, y0, f"{label.item()} {score.item():.2f}",
            color="black", fontsize=8,
            bbox={"facecolor": "lime", "alpha": 0.7})
ax.axis("off")
fig.savefig("detection_result.png", dpi=100, bbox_inches="tight")
print("disimpan: detection_result.png")
Output:
jumlah deteksi: 84
skor tertinggi: 0.3398
disimpan: detection_result.png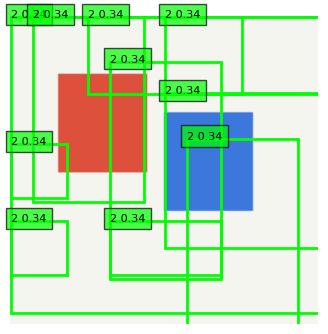
Model dengan bobot acak tetap menghasilkan puluhan kotak dengan skor tertinggi sekitar 0.33. Angka tersebut bukan tanda model bekerja, karena kepala klasifikasi belum dilatih dan skor masih tersebar mendekati acak. Setelah training, distribusi skor bergeser ke atas dan jumlah deteksi di bawah score_thresh berkurang. File detection_result.png menyimpan gambar dengan sepuluh kotak teratas beserta label dan skornya.
Menjaga Trade-off Akurasi dan Latency Saat Model Masuk Production
Pemilihan backbone menentukan batas bawah latency. MobileNet dengan FPN jauh lebih ringan dibanding ResNet-50 FPN, dengan konsekuensi akurasi objek kecil menurun. Resolusi input memberi efek kuadratik terhadap biaya komputasi, sehingga menurunkan sisi terpanjang dari 1333 ke 800 piksel sering memotong latency hampir separuh.
Jumlah proposal dan nms_thresh mengatur throughput. Batas proposal sebelum dan sesudah NMS menentukan berapa banyak region masuk ke tahap kedua. Nilai terlalu besar menambah beban tanpa perbaikan akurasi sepadan, sedangkan nilai terlalu kecil memotong kandidat objek yang saling menutup.
Ekspor ke TorchScript atau ONNX memindahkan model ke runtime lebih ringan. Setelah ekspor, kita memverifikasi tiga hal: hasil inference identik pada input yang sama, operasi NMS dan RoI Align didukung runtime target, serta preprocessing tidak berubah. Perbedaan normalisasi atau urutan kanal sering menjadi sumber selisih.
Monitoring berjalan di dua lapis. Lapis operasional memantau distribusi skor, jumlah deteksi per frame, dan proporsi frame tanpa deteksi. Lapis berkala mengevaluasi mAP pada sampel data baru yang sudah dilabeli. Pergeseran distribusi skor atau penurunan mAP menandakan model perlu dilatih ulang sebelum masalah terlihat pengguna.
Object detection end-to-end lebih mudah dipahami ketika teori dan kode dijalankan bersamaan. Di Rumah Coding, kelas Computer Vision dan bootcamp Deep Learning membahas pipeline Faster R-CNN dari region proposal sampai evaluasi mAP, dengan latihan langsung memakai PyTorch di CPU.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.