Memahami One-Class SVM untuk Deteksi Anomali: Teori dan Implementasi dengan Scikit-learn
Apa Itu Deteksi Anomali dan Mengapa One-Class SVM
Anomali adalah titik data yang menyimpang jauh dari pola mayoritas dalam dataset. Deteksi anomali muncul di banyak konteks nyata. Fraud transaksi kartu kredit, kerusakan mesin industri, intrusi jaringan, hingga kesalahan sensor. Pada situasi tersebut label anomali sering tidak tersedia. Kita tidak tahu di awal mana titik yang normal dan mana yang anomali. Pendekatan unsupervised menjadi pilihan natural.
One-Class SVM adalah algoritma unsupervised yang belajar hanya dari kelas normal. Algoritma ini membangun batas keputusan yang membungkus data normal. Setiap titik yang jatuh di luar batas tersebut ditandai sebagai anomali. Kita tidak memerlukan label anomali untuk melatih model. Kita hanya perlu kumpulan data yang didominasi oleh perilaku normal.
Pemilihan algoritma bergantung pada karakteristik data. Isolation Forest bekerja cepat pada data berdimensi tinggi dan skala besar. Local Outlier Factor sensitif terhadap kepadatan lokal. One-Class SVM unggul ketika kita memiliki data normal yang bersih dan ingin batas keputusan yang halus serta berbasis margin. Algoritma ini juga memanfaatkan kernel trick sehingga mampu menangani data non-linear tanpa transformasi manual.
Dalam praktik, kita sering memulai dengan eksplorasi data sederhana. Kita visualisasikan distribusi fitur dan mencari titik yang jauh dari cluster utama. Jika pola normal terlihat jelas dan dataset tidak terlalu besar, One-Class SVM menjadi kandidat kuat. Jika data mengandung banyak noise atau skala besar, kita mempertimbangkan algoritma lain. Keputusan tersebut harus didasarkan pada eksperimen, bukan asumsi.
Teori Dasar One-Class SVM
One-Class SVM bekerja dengan memetakan data ke ruang fitur berdimensi tinggi. Tujuannya adalah menemukan hyperplane yang memisahkan data normal dari origin dengan margin maksimum. Data normal ditempatkan sejauh mungkin dari origin. Anomali yang tidak pernah dilihat selama training cenderung jatuh lebih dekat ke origin sehingga berada di sisi lain hyperplane.
Parameter nu mengontrol proporsi maksimum outlier yang diizinkan dalam data training dan sekaligus batas bawah jumlah support vector. Nilai nu kecil membuat model ketat dan sedikit titik dianggap normal. Nilai nu besar membuat model lebih longgar. Parameter gamma mengontrol pengaruh jarak antar titik pada kernel RBF. Nilai gamma besar membuat boundary mengikuti bentuk data secara detail. Nilai gamma kecil membuat boundary lebih halus dan umum.
Kernel RBF memungkinkan model menangkap pola non-linear tanpa rekayasa fitur manual. Kernel trick menghitung inner product di ruang fitur tinggi secara implisit. Konsep tersebut abstrak, tetapi cukup kita pahami sebagai cara memperluas kapasitas model tanpa biaya komputasi eksplisit.
Decision function menghasilkan skor signed distance. Nilai positif menandakan titik berada di dalam region normal. Nilai negatif menandakan titik berada di luar region normal. Kita menggunakan skor tersebut untuk ranking anomali. Titik dengan skor paling negatif adalah kandidat anomali terkuat.
Support vector adalah titik-titik data normal yang berada tepat di batas region. Hanya support vector yang menentukan posisi hyperplane. Titik lain tidak berpengaruh setelah training selesai. Jumlah support vector dikontrol oleh nu. Semakin banyak support vector, semakin kompleks boundary yang terbentuk. Kompleksitas tersebut meningkatkan risiko overfitting pada noise kecil dalam data training.
Pada tahap inferensi, kita tidak memerlukan data training lagi. Model menyimpan hyperplane dan support vector. Setiap titik baru dipetakan ke ruang fitur yang sama lalu dihitung signed distance-nya. Proses inferensi relatif cepat karena hanya melibatkan support vector, bukan seluruh dataset. Karakteristik tersebut membuat One-Class SVM cocok untuk deteksi online pada data yang tiba secara streaming dengan volume moderat.

Gambar: Ilustrasi konsep deteksi outlier — titik normal, border, dan noise — Sumber: Wikimedia Commons
Generate Dataset Sintetis dan Visualisasi
Kita mulai dengan membuat data sintetis. Data normal dibangkitkan dari distribusi Gaussian. Beberapa titik acak ditambahkan sebagai anomali. Visualisasi scatter plot membantu kita memahami sebaran sebelum model dilatih.
!pip install numpy matplotlib scikit-learn

import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import OneClassSVM

rng = np.random.RandomState(42)

# Data normal: dua cluster Gaussian
X_normal = 0.3 * rng.randn(200, 2)
X_normal = np.r_[X_normal + [2, 2], X_normal + [-2, -2]]

# Anomali: titik acak di rentang yang lebih luas
X_outliers = rng.uniform(low=-4, high=4, size=(30, 2))

X = np.r_[X_normal, X_outliers]
y_true = np.r_[np.ones(len(X_normal)), -np.ones(len(X_outliers))]

plt.figure(figsize=(6, 5))
plt.scatter(X_normal[:, 0], X_normal[:, 1], c="steelblue", label="Normal", s=20)
plt.scatter(X_outliers[:, 0], X_outliers[:, 1], c="crimson", label="Anomali", s=20)
plt.legend()
plt.title("Dataset Sintetis: Normal vs Anomali")
plt.grid(alpha=0.3)
plt.show()

print("Jumlah normal:", len(X_normal))
print("Jumlah anomali:", len(X_outliers))
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Output:
Jumlah normal: 400
Jumlah anomali: 30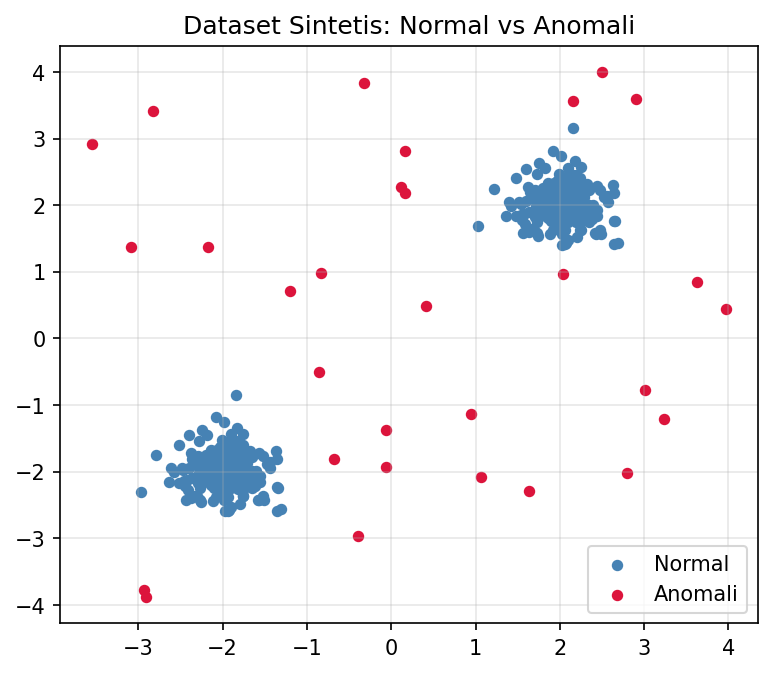
Penjelasan kode berfokus pada workflow pembuatan data. rng.randn menghasilkan titik normal terpusat di dua lokasi. rng.uniform menghasilkan anomali tersebar di rentang luas. Label y_true disimpan hanya untuk evaluasi, tidak dipakai saat training. Output yang diharapkan berupa scatter plot dengan dua cluster biru dan titik merah tersebar.
Training One-Class SVM dan Prediksi
Kita latih model pada seluruh data tanpa label. One-Class SVM mempelajari region normal dari pola mayoritas. Prediksi menghasilkan +1 untuk normal dan -1 untuk anomali. Kita juga hitung confusion matrix untuk melihat performa.
!pip install numpy matplotlib scikit-learn

import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import OneClassSVM
from sklearn.metrics import classification_report, confusion_matrix

rng = np.random.RandomState(42)
X_normal = 0.3 * rng.randn(200, 2)
X_normal = np.r_[X_normal + [2, 2], X_normal + [-2, -2]]
X_outliers = rng.uniform(low=-4, high=4, size=(30, 2))
X = np.r_[X_normal, X_outliers]
y_true = np.r_[np.ones(len(X_normal)), -np.ones(len(X_outliers))]

model = OneClassSVM(kernel="rbf", gamma="auto", nu=0.1)
model.fit(X)

y_pred = model.predict(X)
scores = model.decision_function(X)

print("Confusion matrix (baris: true, kolom: pred):")
print(confusion_matrix(y_true, y_pred, labels=[1, -1]))
print()
print(classification_report(y_true, y_pred, labels=[1, -1], target_names=["Normal", "Anomali"]))

# Visualisasi decision boundary
xx, yy = np.meshgrid(np.linspace(-5, 5, 200), np.linspace(-5, 5, 200))
Z = model.decision_function(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)

plt.figure(figsize=(6, 5))
plt.contourf(xx, yy, Z, levels=np.linspace(Z.min(), 0, 7), cmap=plt.cm.PuBu)
plt.contour(xx, yy, Z, levels=[0], linewidths=2, colors="darkred")
plt.scatter(X_normal[:, 0], X_normal[:, 1], c="steelblue", s=15, label="Normal")
plt.scatter(X_outliers[:, 0], X_outliers[:, 1], c="crimson", s=15, label="Anomali")
plt.legend()
plt.title("Decision Boundary One-Class SVM")
plt.show()
Output:
Confusion matrix (baris: true, kolom: pred):
[[385  15]
 [  1  29]]

              precision    recall  f1-score   support

      Normal       1.00      0.96      0.98       400
     Anomali       0.66      0.97      0.78        30

    accuracy                           0.96       430
   macro avg       0.83      0.96      0.88       430
weighted avg       0.97      0.96      0.97       430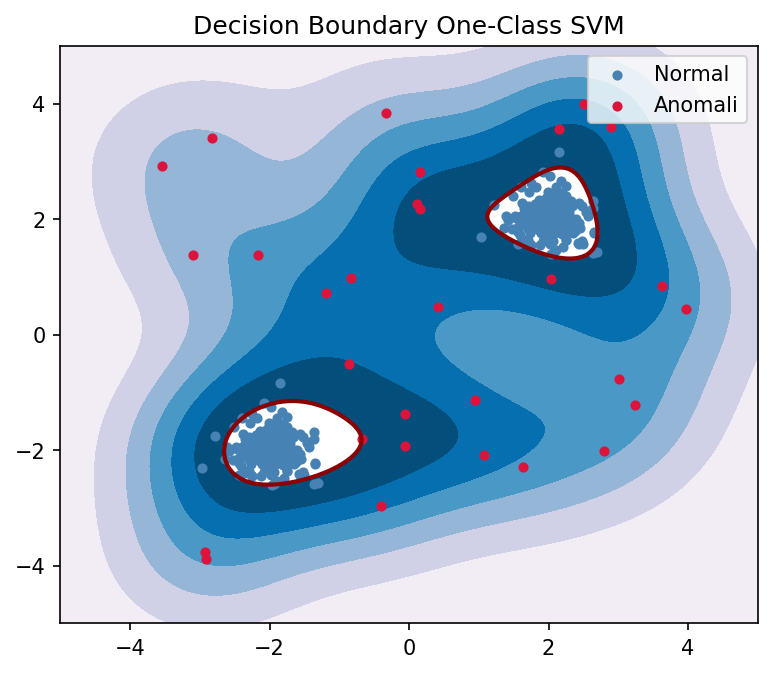
Penjelasan kode berfokus pada workflow training dan evaluasi. Model dilatih dengan nu=0.1 dan gamma="auto". Metode predict menghasilkan label biner. Metode decision_function menghasilkan skor. Plot menampilkan contour region normal dan batas merah. Output yang diharapkan berupa confusion matrix dengan sebagian besar normal terklasifikasi benar dan sebagian besar anomali terdeteksi.
Tuning Parameter nu dan gamma
Parameter nu dan gamma sangat memengaruhi hasil. Kita bandingkan beberapa kombinasi untuk melihat trade-off. Kita hitung jumlah anomali terdeteksi dan visualisasikan boundary.
!pip install numpy matplotlib scikit-learn

import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import OneClassSVM

rng = np.random.RandomState(42)
X_normal = 0.3 * rng.randn(200, 2)
X_normal = np.r_[X_normal + [2, 2], X_normal + [-2, -2]]
X_outliers = rng.uniform(low=-4, high=4, size=(30, 2))
X = np.r_[X_normal, X_outliers]

configs = [(0.05, 0.5), (0.1, 0.5), (0.1, 2.0), (0.2, 0.5)]

fig, axes = plt.subplots(2, 2, figsize=(9, 8))
for ax, (nu, gamma) in zip(axes.ravel(), configs):
    model = OneClassSVM(kernel="rbf", gamma=gamma, nu=nu)
    model.fit(X)
    pred = model.predict(X)
    n_anom = int((pred == -1).sum())

    xx, yy = np.meshgrid(np.linspace(-5, 5, 150), np.linspace(-5, 5, 150))
    Z = model.decision_function(np.c_[xx.ravel(), yy.ravel()]).reshape(xx.shape)
    ax.contourf(xx, yy, Z, levels=np.linspace(Z.min(), 0, 7), cmap=plt.cm.PuBu)
    ax.contour(xx, yy, Z, levels=[0], linewidths=2, colors="darkred")
    ax.scatter(X[:, 0], X[:, 1], c=np.where(pred == 1, "steelblue", "crimson"), s=10)
    ax.set_title(f"nu={nu}, gamma={gamma}\nanomali={n_anom}")

plt.tight_layout()
plt.show()

for nu, gamma in configs:
    m = OneClassSVM(kernel="rbf", gamma=gamma, nu=nu).fit(X)
    print(f"nu={nu}, gamma={gamma} -> anomali terdeteksi: {int((m.predict(X) == -1).sum())}")
Output:
nu=0.05, gamma=0.5 -> anomali terdeteksi: 19
nu=0.1, gamma=0.5 -> anomali terdeteksi: 44
nu=0.1, gamma=2.0 -> anomali terdeteksi: 45
nu=0.2, gamma=0.5 -> anomali terdeteksi: 86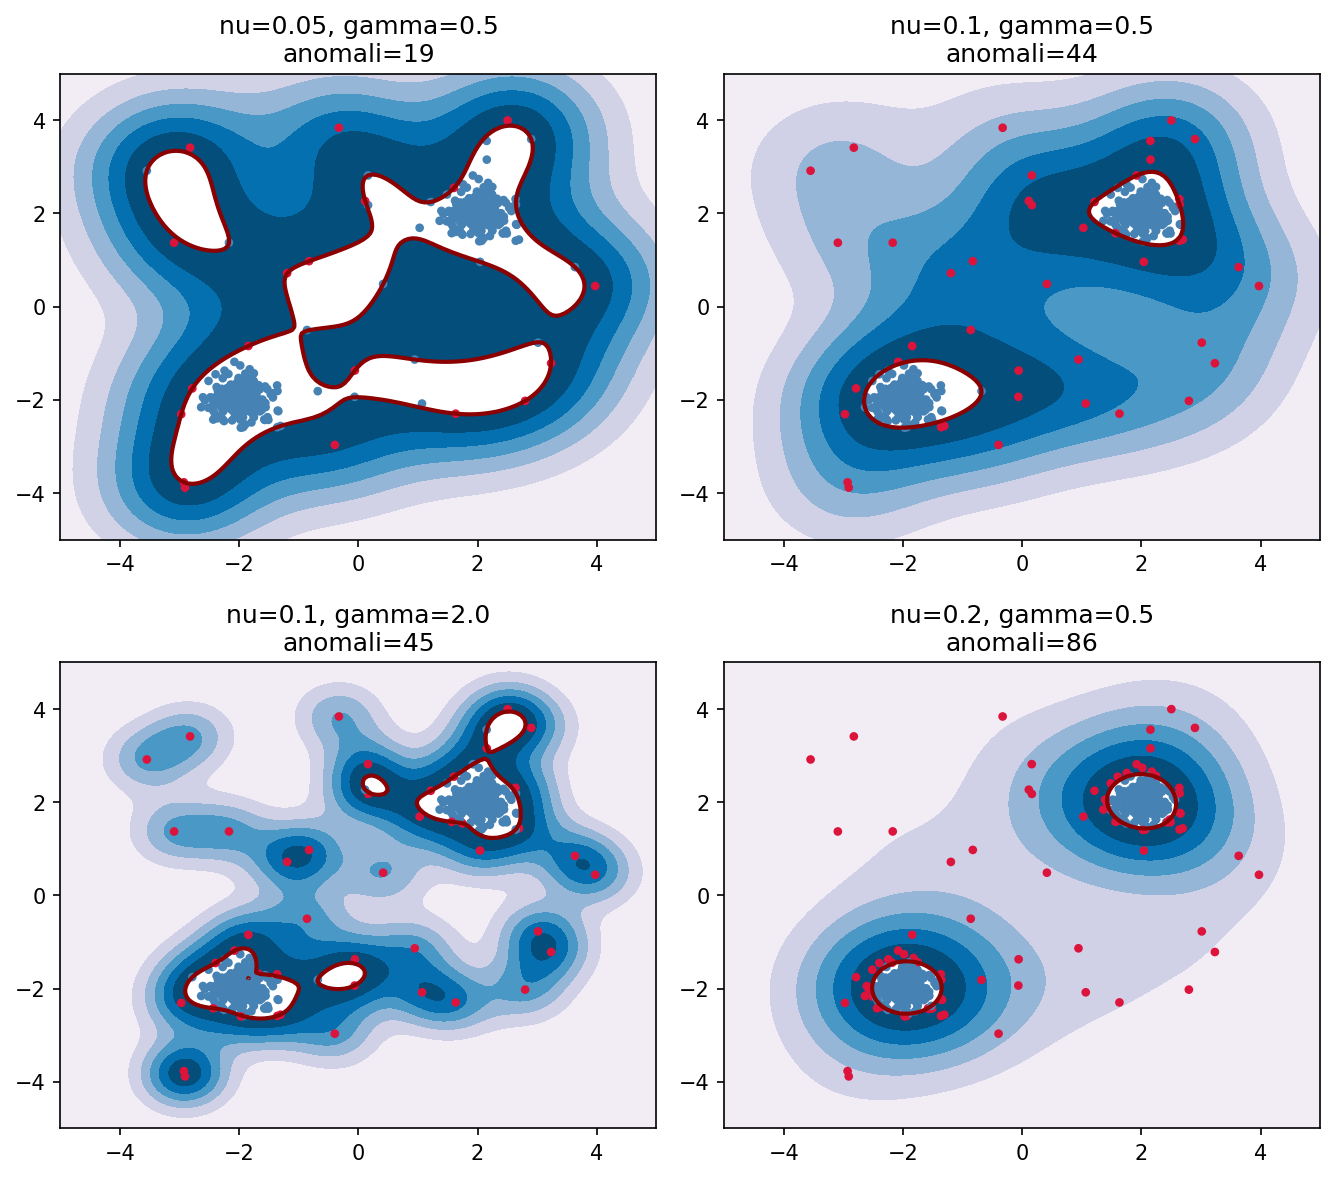
Penjelasan kode berfokus pada interpretasi tuning. Nilai nu kecil mendeteksi lebih sedikit anomali. Nilai gamma besar membuat boundary terlalu ketat dan mendeteksi lebih banyak anomali. Output yang diharapkan berupa grid plot dan daftar jumlah anomali. Kita memilih kombinasi yang sesuai dengan tingkat false positive yang dapat ditoleransi.
Kapan One-Class SVM Tidak Cocok
One-Class SVM memiliki keterbatasan yang perlu kita ketahui. Kompleksitas training berada pada rentang O(n^2) hingga O(n^3). Algoritma ini tidak ideal untuk dataset besar dengan ratusan ribu baris. Untuk skala tersebut, Isolation Forest atau autoencoder lebih efisien.
Sensitivitas terhadap skala fitur menjadi masalah nyata. One-Class SVM mengandalkan jarak, sehingga fitur dengan skala besar mendominasi. Kita wajib melakukan standardisasi dengan StandardScaler sebelum training. Tanpa standardisasi, boundary menjadi bias dan deteksi tidak andal.
Pemilihan alternatif bergantung pada kebutuhan. Isolation Forest cepat dan skalabel untuk data tabular besar. Local Outlier Factor cocok untuk anomali berbasis kepadatan lokal. Autoencoder cocok untuk data gambar atau sekuens. One-Class SVM tetap relevan untuk data tabular berukuran sedang dengan pola normal yang jelas.
Best practice yang kita terapkan: standardisasi fitur, tuning nu melalui validation set, pemantauan false positive rate, dan evaluasi dengan data anomali yang diketahui jika tersedia. Kita menyimpan skor decision function untuk analisis threshold. Kita membandingkan beberapa algoritma sebelum menetapkan solusi final.
Threshold selection menjadi langkah penting setelah model dilatih. Skor decision function dapat kita konversi menjadi ranking. Kita menetapkan threshold berdasarkan kapasitas tim untuk menindaklanjuti alert. Jika kapasitas terbatas, kita menaikkan threshold agar hanya anomali paling kuat yang dilaporkan. Jika risiko bisnis tinggi, kita menurunkan threshold agar lebih sensitif. Pendekatan tersebut lebih fleksibel daripada bergantung pada label biner dari predict.
Monitoring jangka panjang juga penting. Distribusi data normal dapat berubah seiring waktu. Konsep drift membuat boundary yang dipelajari menjadi usang. Kita perlu menjadwalkan retraining berkala dan memantau distribusi skor decision function. Jika distribusi bergeser signifikan, kita meninjau ulang parameter dan data training. Proses tersebut menjaga deteksi tetap relevan dan mengurangi false positive yang tidak perlu.
Ikuti bootcamp Machine Learning di Rumah Coding untuk melatih intuisi deteksi anomali dan evaluasi model melalui proyek terbimbing dengan dataset nyata.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Machine Learning Bootcamp
A beginner-friendly, 7-week project-based bootcamp designed to take you from Python basics to deploying your first Machine Learning model. Through hands-on practice, you will master essential data manipulation, build predictive algorithms, and develop an end-to-end, industry-ready application to kickstart your career in data science.
End-to-End Student Success Predictor
- Automated Data Pipeline: A preprocessing script that automatically cleans missing values, encodes categorical data (like course type or student background), and scales numerical inputs.
- Predictive Engine: A tuned machine learning classification model (e.g., Random Forest) specifically optimized for high Recall, ensuring that "at-risk" students are not missed.
- Interactive Web Dashboard: A user-friendly Streamlit interface featuring a sidebar where instructors can manually input a student's study hours, quiz scores, and login frequency to get an instant pass/fail probability.