Membangun CI/CD Pipeline dengan GitLab CI: Stage, Cache, dan Artifact untuk Aplikasi Python
Pipeline GitLab CI adalah urutan eksekusi yang dijalankan runner setiap kali ada commit baru. Konfigurasinya disimpan dalam satu file .gitlab-ci.yml di root repository, sehingga versi pipeline ikut ter-review bersama kode aplikasi.
Memetakan Alur Eksekusi Pipeline dari Commit sampai Artifact
GitLab CI menyusun eksekusi dalam tiga lapisan objek. pipeline adalah satu kali eksekusi lengkap untuk satu commit. Di dalamnya terdapat stage yang berjalan berurutan, dan di dalam setiap stage terdapat job yang berisi perintah aktual.
Job di dalam stage yang sama berjalan secara paralel. Stage berikutnya baru dimulai setelah semua job di stage sebelumnya selesai tanpa error. Perilaku ini penting karena menentukan di mana kita meletakkan proses yang mahal, misalnya build wheel atau integration test.
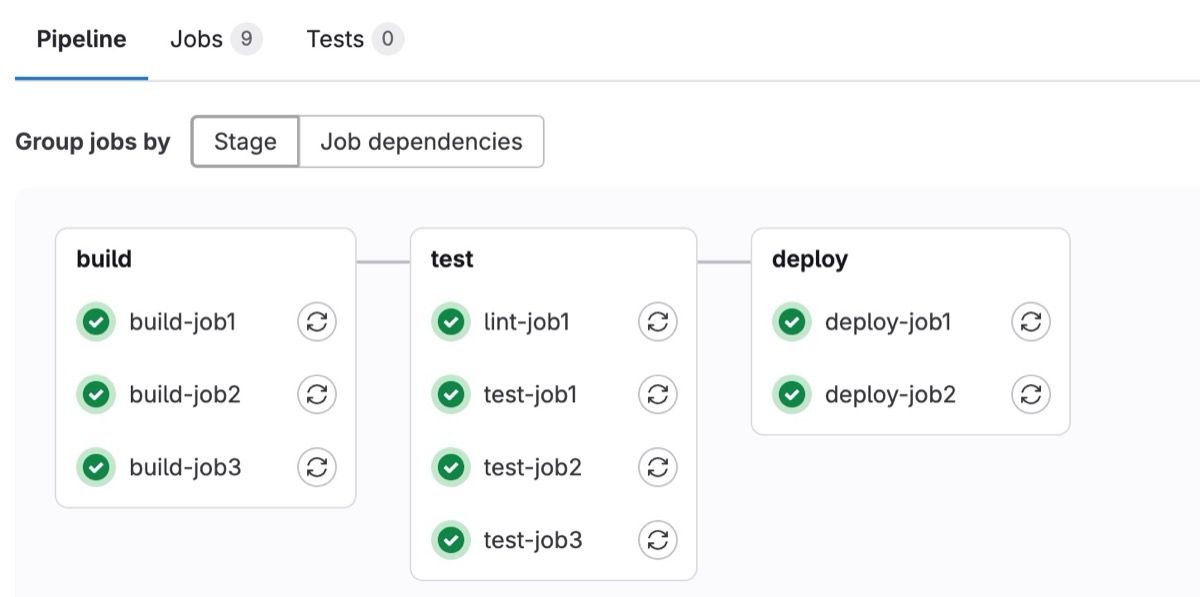
Gambar: Tampilan pipeline GitLab CI yang dikelompokkan per stage — job di dalam stage build, test, dan deploy berjalan paralel, sedangkan stage berikutnya baru dimulai setelah stage sebelumnya selesai — Sumber: GitLab Docs
Setiap job dieksekusi oleh runner, yaitu agent yang bisa berupa container, virtual machine, atau mesin fisik. Keyword image menentukan container image yang dipakai runner Docker executor. Nilai script adalah daftar perintah shell yang dijalankan berurutan, dan exit code non-zero dari perintah mana pun akan menghentikan job.
Setiap job wajib memiliki stage yang terdaftar pada stages dan blok script berisi minimal satu perintah. Keyword image menentukan container yang dipakai runner, sedangkan variabel CI_COMMIT_SHORT_SHA disediakan otomatis oleh GitLab dan berguna untuk menandai log dengan commit yang memicunya.
Output yang kita harapkan dari satu job sederhana adalah log perintah yang dijalankan beserta versi Python dari container. Ketika perintah pertama gagal karena image tidak tersedia, pipeline langsung berstatus failed dan perintah berikutnya tidak dieksekusi. Struktur lengkap dengan tiga stage kita susun pada bagian berikutnya.
Menyusun Stage Build, Test, dan Deploy untuk Aplikasi Python
Pipeline yang berguna biasanya memisahkan pekerjaan menjadi tiga stage: build, test, dan deploy. Pemisahan ini membuat kegagalan terisolasi. Ketika test gagal, kita tidak perlu menunggu job deploy yang memang tidak akan dijalankan.
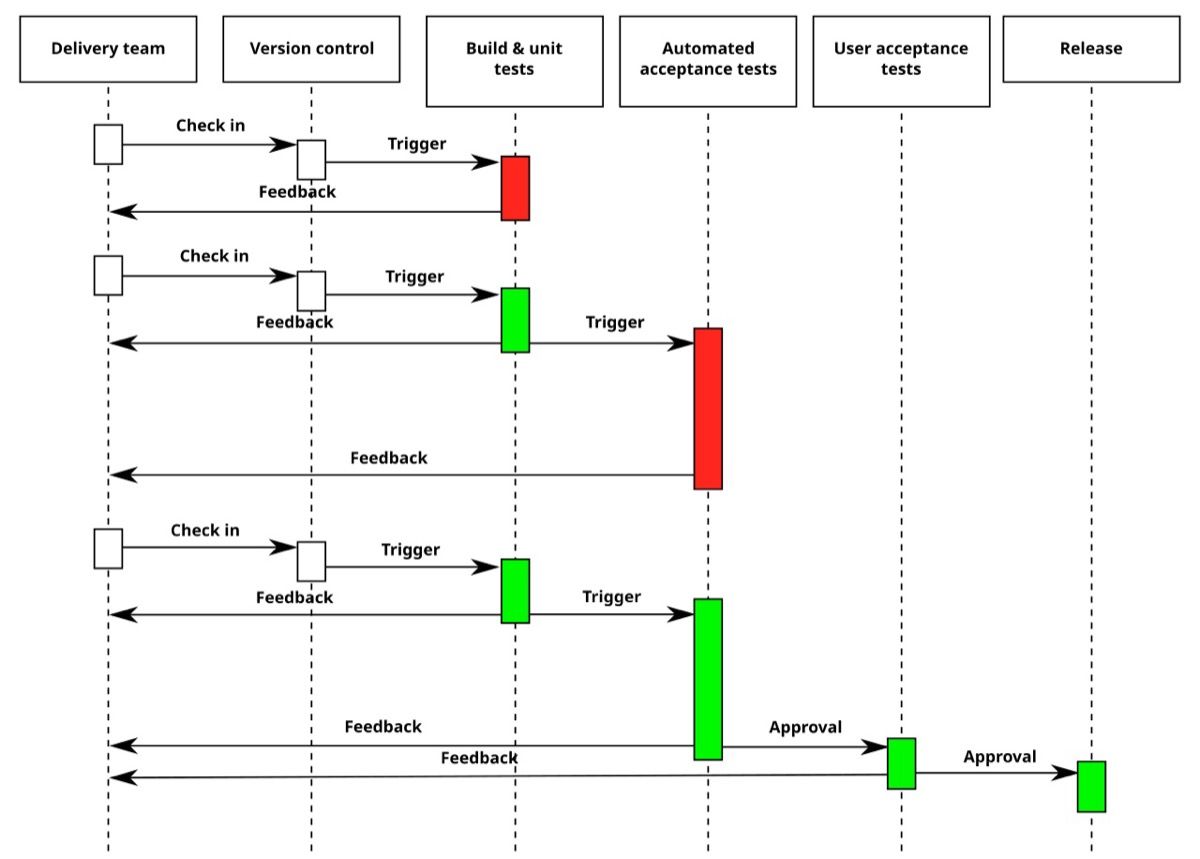
Gambar: Rangkaian stage build, test, dan release beserta jalur feedback ke pengembang — setiap tahap hanya berjalan jika tahap sebelumnya lulus, persis seperti urutan stage pada .gitlab-ci.yml — Sumber: Wikimedia Commons
Keyword default dipakai untuk nilai yang berlaku pada semua job, sehingga image dan before_script tidak perlu diulang. before_script berjalan sebelum script pada setiap job, dan di sinilah dependency dipasang.
stages:
  - build
  - test
  - deploy

default:
  image: python:3.12-slim
  before_script:
    - python -m pip install --upgrade pip
    - pip install -r requirements.txt

build-package:
  stage: build
  script:
    - python -m compileall -q app
    - python -m build --wheel --outdir dist
  artifacts:
    paths:
      - dist/
    expire_in: 1 week

run-tests:
  stage: test
  script:
    - pytest -q

deploy-staging:
  stage: deploy
  script:
    - echo "Deploy versi $CI_COMMIT_SHORT_SHA ke staging"
  environment:
    name: staging
  rules:
    - if: '$CI_COMMIT_BRANCH == "main"'
Job build-package melakukan dua hal: memastikan seluruh modul di direktori app bisa dikompilasi, lalu membangun wheel ke direktori dist. Perintah python -m build membutuhkan package build yang harus tercatat di requirements.txt. Blok artifacts menyimpan isi dist/ agar bisa dipakai job lain, dan expire_in membatasi masa simpannya selama satu minggu.
Job run-tests bergantung pada keberhasilan stage build karena urutan stage. Jika compileall menemukan syntax error, test tidak akan pernah dijalankan. Perilaku ini menghemat waktu runner dan memperjelas sumber masalah.
Job deploy-staging memakai rules untuk membatasi eksekusi hanya pada branch main. Pada merge request, job ini tidak muncul sama sekali di pipeline graph. Keyword environment menautkan job ke environment staging sehingga riwayat deployment tercatat di menu Deployments.
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Menjalankan Unit Test Python di Dalam Job Test
pytest cocok sebagai gerbang kualitas karena hasil eksekusinya diterjemahkan menjadi exit code. Runner tidak membaca isi log untuk menentukan status. Nilai exit code 0 berarti semua test lulus, dan nilai selain 0 menandai job gagal.
Contoh berikut menulis test untuk dua fungsi kalkulasi, termasuk satu kasus input tidak valid. Perintah !pip install di baris pertama memastikan library tersedia di environment eksekusi.
!pip install pytest

import pytest


def rata_rata(nilai):
    return sum(nilai) / len(nilai) if nilai else 0


def parse_angka(teks):
    try:
        return int(teks)
    except ValueError as error:
        raise ValueError(f"Input bukan angka: {teks}") from error


def test_rata_rata_nilai_normal():
    assert rata_rata([10, 20, 30]) == 20


def test_rata_rata_list_kosong():
    assert rata_rata([]) == 0


def test_parse_angka_menolak_input_invalid():
    with pytest.raises(ValueError):
        parse_angka("dua puluh")


if __name__ == "__main__":
    raise SystemExit(pytest.main([__file__, "-q"]))
Output:
...                                                                      [100%]
3 passed in 0.00s
Fungsi rata_rata menangani dua kondisi: list berisi nilai dan list kosong. Pemeriksaan if nilai mencegah pembagian dengan nol, sehingga fungsi mengembalikan 0 untuk input kosong. Fungsi parse_angka mengubah teks menjadi integer dan menerjemahkan ValueError bawaan Python menjadi pesan yang lebih jelas, tanpa menghilangkan traceback asli berkat from error.
Blok if __name__ == "__main__" menjalankan pytest.main ketika file dieksekusi langsung, sehingga hasilnya bisa diverifikasi di luar runner. Output yang diharapkan berbentuk ringkasan seperti 3 passed in 0.05s. Jumlah test yang lulus itulah yang kita bandingkan dengan ekspektasi saat pipeline berjalan.
Di dalam .gitlab-ci.yml, job test cukup memanggil pytest -q. Opsi -q mempersingkat output agar log pipeline mudah dibaca, sementara exit code tetap menjadi penentu status job.
Mempercepat Pipeline dengan Cache Dependency pip
Cache menyimpan direktori antar pipeline, sedangkan artifact berpindah antar job dalam satu pipeline. Perbedaan ini menentukan pilihan keyword. Dependency yang jarang berubah lebih tepat disimpan sebagai cache, bukan artifact.
Kunci cache menentukan kapan isi cache dianggap masih valid. Jika kunci hanya berupa string statis, cache lama tetap dipakai meskipun requirements.txt berubah, dan pipeline bisa memakai versi library yang salah. GitLab menyediakan bentuk key.files yang menghitung hash dari file tertentu.
default:
  image: python:3.12-slim
  variables:
    PIP_CACHE_DIR: "$CI_PROJECT_DIR/.cache/pip"
  cache:
    key:
      files:
        - requirements.txt
    paths:
      - .cache/pip
  before_script:
    - python -m pip install --upgrade pip
    - pip install -r requirements.txt
Direktori .cache/pip berada di dalam working directory job, dan variabel PIP_CACHE_DIR mengarahkan pip ke lokasi tersebut. Nilai paths harus sama dengan direktori yang dipakai pip, karena runner hanya mengarsipkan path yang terdaftar.
Pada eksekusi pertama, log menampilkan Checking cache for ... lalu WARNING: file does not exist ketika cache belum tersedia. Setelah job selesai, runner mengunggah .cache/pip. Eksekusi berikutnya dengan requirements.txt yang sama menampilkan Successfully extracted cache, dan langkah pip install selesai dalam hitungan detik.
Cache tidak menggantikan reproducibility. Isi cache bisa hilang kapan saja, misalnya ketika runner dibersihkan atau kuota storage penuh. Pipeline tetap harus berjalan benar tanpa cache, hanya lebih lambat. Kita juga perlu menghapus cache secara manual ketika ada dependency bermasalah yang sudah terlanjur tersimpan.
Membagikan Hasil Build Antar Job dengan Artifact
Artifact menghubungkan job build dengan job lain yang membutuhkan hasilnya. Job penerima mengunduh artifact secara otomatis ketika berada pada stage berikutnya, atau ketika dideklarasikan lewat needs dan dependencies.
Kesalahan konfigurasi artifact baru terlihat setelah pipeline berjalan, dan setiap percobaan memakan menit runner. Pemeriksaan struktur file secara lokal mempercepat iterasi. Skrip berikut membaca konfigurasi YAML, memastikan setiap job punya script, dan memastikan stage yang dirujuk benar-benar terdaftar.
!pip install pyyaml

import yaml

KONFIGURASI = """
stages: [build, test, deploy]

build-package:
  stage: build
  script:
    - python -m build --wheel --outdir dist
  artifacts:
    paths:
      - dist/
    expire_in: 1 week

run-tests:
  stage: test
  script:
    - pytest -q

deploy-staging:
  stage: deploy
  script:
    - echo "deploy"
"""


def validasi(teks):
    data = yaml.safe_load(teks)
    stages = data.get("stages", [])
    jobs = {nama: isi for nama, isi in data.items() if nama != "stages"}

    for nama, isi in jobs.items():
        if "script" not in isi:
            raise ValueError(f"Job {nama} tidak punya script")
        if isi.get("stage") not in stages:
            raise ValueError(f"Stage job {nama} tidak terdaftar")

    return stages, jobs


stages, jobs = validasi(KONFIGURASI)
print("Urutan stage:", " -> ".join(stages))

for nama, isi in jobs.items():
    artifact = isi.get("artifacts", {}).get("paths", [])
    print(f"{nama:16} stage={isi['stage']:8} artifact={artifact or '-'}")
Output:
Urutan stage: build -> test -> deploy
build-package    stage=build    artifact=['dist/']
run-tests        stage=test     artifact=-
deploy-staging   stage=deploy   artifact=-
Fungsi validasi memisahkan stages dari daftar job, lalu memeriksa dua hal yang paling sering salah: job tanpa script dan job dengan stage yang tidak dideklarasikan. Skrip mengembalikan kedua struktur tersebut agar bisa dicetak.
Output yang diharapkan berisi empat baris ringkasan. Baris pertama menampilkan urutan build -> test -> deploy, diikuti daftar job beserta stage dan path artifact-nya. Job build-package menampilkan artifact=['dist/'], sedangkan dua job lain menampilkan tanda - karena tidak menghasilkan artifact.
Pada pipeline sebenarnya, job deploy-staging memakai needs: ["build-package"] untuk mengunduh artifact tanpa menunggu seluruh stage test selesai. Pengaturan ini mempercepat deployment pada repository besar, tetapi mengurangi jaminan bahwa test sudah lulus. Pilih needs hanya ketika job penerima memang tidak bergantung pada hasil test.
expire_in perlu disesuaikan dengan kebutuhan. Artifact wheel untuk staging cukup disimpan beberapa hari, sementara laporan coverage biasanya disimpan lebih lama agar bisa dibandingkan antar rilis. Menyimpan artifact terlalu lama memperbesar penggunaan storage dan memperlambat pembersihan.
Ingin mempraktikkan pipeline seperti ini pada proyek nyata? Program Docker & DevOps di Rumah Coding membahas GitLab CI, Docker, dan deployment dari konfigurasi awal sampai berjalan di server, dengan pendampingan langsung dari praktisi.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.