Teori dan Implementasi Quantile Regression untuk Prediksi Nilai Ekstrem dengan Scikit-learn
Keterbatasan Regresi Rata-Rata pada Data dengan Nilai Ekstrem
LinearRegression mengoptimalkan mean squared error, sehingga solusi yang dihasilkan adalah conditional mean. Model hanya memberi satu nilai tengah untuk setiap kombinasi fitur, bukan gambaran sebaran target. Ketika residual tersebar tidak merata, satu garis regresi menyembunyikan bagian distribusi yang justru paling menentukan keputusan.
Heteroskedastisitas memperparah kondisi ini. Pada nilai fitur kecil sebaran target mungkin sempit, sedangkan pada nilai fitur besar sebaran melebar beberapa kali lipat. Outlier juga menarik garis OLS karena error dikuadratkan. Prediksi permintaan stok, risiko biaya, dan waktu tunggu layanan termasuk kasus yang tidak cukup dijawab oleh rata-rata. Nilai rata-rata permintaan tidak membantu ketika pertanyaannya adalah seberapa besar stok untuk menutup 90 persen permintaan.
Quantile regression memodelkan conditional quantile secara langsung. Median (p50) memberi estimasi yang lebih tahan outlier, sedangkan p10 dan p90 memberi batas bawah dan batas atas yang bisa diterjemahkan menjadi buffer stok atau skenario biaya. Tiga model memberi ringkasan distribusi, bukan hanya satu titik.
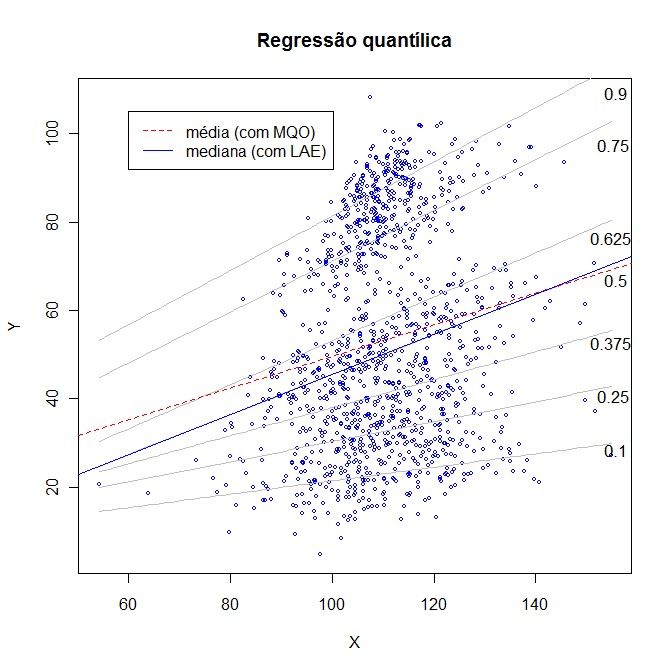
Gambar: Garis kuantil bersarang 0,1 sampai 0,9 dibanding garis rata-rata OLS pada data heteroskedastik — Sumber: Wikimedia Commons, lisensi CC BY 3.0, oleh Usuário:Rbaliq
Contoh keputusan membuat perbedaan ini konkret. Tim gudang memakai p90 permintaan untuk menentukan reorder point, karena kehabisan stok lebih mahal daripada sisa stok. Tim keuangan memakai p90 biaya klaim untuk menyiapkan cadangan kas. Di sisi lain, p10 pendapatan dipakai untuk skenario kas terburuk. Layanan pelanggan memakai p90 waktu tunggu untuk menentukan jumlah agen pada jam sibuk. Ketiga keputusan itu tidak bisa dijawab satu garis rata-rata, karena anggaran dan kapasitas harus disiapkan untuk bagian distribusi yang jarang terjadi.
Pinball Loss sebagai Fungsi Objektif Quantile Regression
Quantile τ didefinisikan sebagai nilai q yang memisahkan τ bagian data di bawahnya, ditulis P(Y ≤ q | X) = τ. τ = 0.5 adalah median, sedangkan 0.1 dan 0.9 menyentuh ekor distribusi.
Pinball loss memberi bobot asimetris pada residual: τ untuk residual positif dan 1 − τ untuk residual negatif. Bentuknya max(tau * r, (tau - 1) * r). Pada τ = 0.5 bobot menjadi simetris dan loss setara mean absolute error. Pada τ = 0.1, prediksi yang terlalu rendah dihukum 0.1, sedangkan prediksi yang terlalu tinggi dihukum 0.9. Model terdorong menurunkan prediksi sampai hanya 10 persen observasi tersisa di bawahnya. Sifat inilah yang membuat titik minimum pinball loss berada di kuantil, bukan di rata-rata.
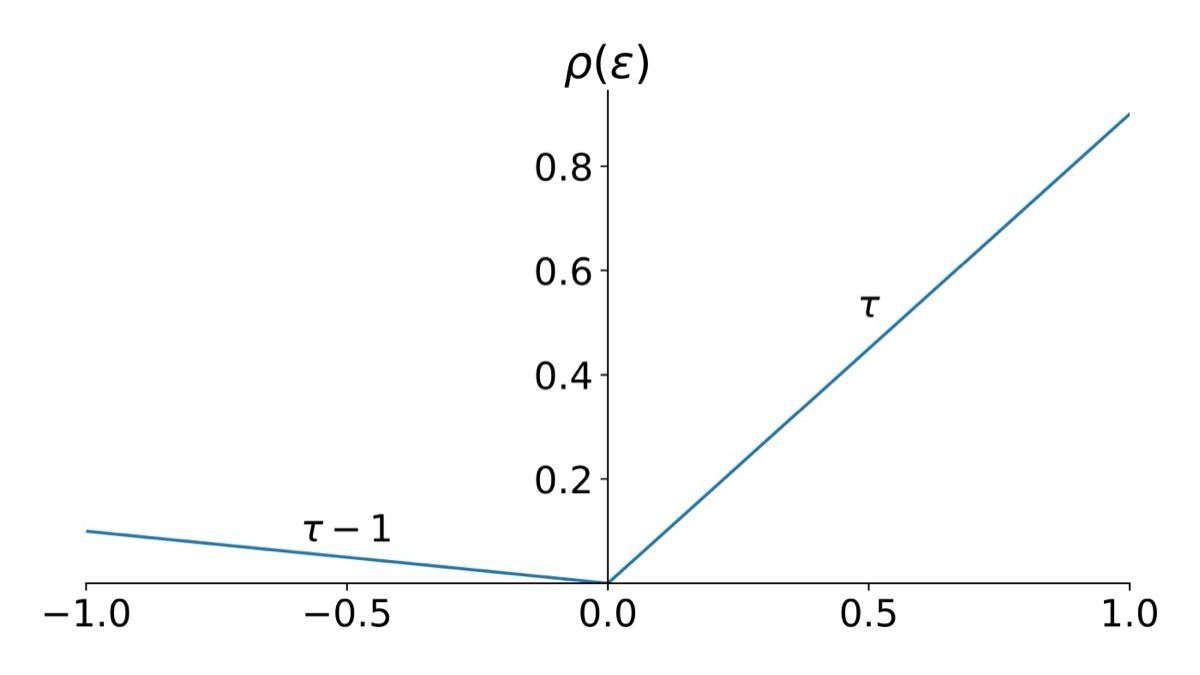
Gambar: Bentuk asimetris pinball loss dengan kemiringan τ untuk residual positif dan τ − 1 untuk residual negatif — Sumber: Wikimedia Commons, lisensi CC BY-SA 4.0, oleh Alexander Elvers
Kode berikut menghitung loss dari nol, lalu membuktikan bahwa prediksi konstan terbaik memang mengikuti kuantil empiris.
!pip install numpy pandas scikit-learn matplotlib

import numpy as np
import pandas as pd

def pinball(residual, tau):
    return np.maximum(tau * residual, (tau - 1) * residual)

residual = np.array([-20, -5, 0, 5, 20])
tabel = [{"tau": tau, **{f"r={v:+d}": round(pinball(v, tau), 1) for v in residual}}
         for tau in (0.1, 0.5, 0.9)]
print(pd.DataFrame(tabel).to_string(index=False))

rng = np.random.default_rng(42)
y = rng.gamma(2.0, 50.0, 2000)
grid = np.linspace(y.min(), y.max(), 400)
for tau in (0.1, 0.5, 0.9):
    loss = [pinball(y - c, tau).mean() for c in grid]
    print(f"tau={tau}: loss minimum {grid[np.argmin(loss)]:.2f} vs kuantil {np.quantile(y, tau):.2f}")
Output:
 tau  r=-20  r=-5  r=+0  r=+5  r=+20
 0.1   18.0   4.5   0.0   0.5    2.0
 0.5   10.0   2.5   0.0   2.5   10.0
 0.9    2.0   0.5   0.0   4.5   18.0
tau=0.1: loss minimum 26.62 vs kuantil 26.94
tau=0.5: loss minimum 86.96 vs kuantil 86.78
tau=0.9: loss minimum 193.80 vs kuantil 194.15
Tabel pertama menunjukkan asimetri bobot: residual −20 dihukum 18.0 pada τ = 0.1, tetapi hanya 2.0 pada τ = 0.9. Bagian kedua menunjukkan prediksi konstan dengan loss terkecil hampir sama dengan np.quantile; selisih kecil muncul karena grid kandidat terbatas.
Melatih Quantile Regression dengan Scikit-learn
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Scikit-learn menyediakan dua jalur. QuantileRegressor memakai model linear dengan penalty L1 opsional melalui parameter alpha, dan cocok ketika hubungan fitur-target relatif lurus. GradientBoostingRegressor(loss="quantile") memakai tree ensemble sehingga mampu menangkap pola non-linear dan interaksi fitur.
Nama parameter target kuantil berbeda: quantile pada QuantileRegressor dan alpha pada GradientBoostingRegressor.
Dataset sintetis memakai noise yang membesar mengikuti x. Skala 0.5 + 0.6 * x membuat sebaran target melebar di sisi kanan sehingga perbedaan antar kuantil terlihat jelas.
import numpy as np
import pandas as pd
from sklearn.linear_model import QuantileRegressor
from sklearn.ensemble import GradientBoostingRegressor

rng = np.random.default_rng(7)
x = rng.uniform(0, 10, 600)
y = 3 + 2 * x + rng.normal(0, 0.5 + 0.6 * x)
X, grid = x.reshape(-1, 1), np.linspace(0, 10, 6).reshape(-1, 1)

tabel = {"x": grid.ravel()}
for tau in (0.1, 0.5, 0.9):
    linear = QuantileRegressor(quantile=tau, alpha=0.0, solver="highs").fit(X, y)
    boost = GradientBoostingRegressor(
        loss="quantile", alpha=tau, n_estimators=300,
        max_depth=2, learning_rate=0.05, random_state=42,
    ).fit(X, y)
    tabel[f"linear p{int(tau * 100)}"] = linear.predict(grid).round(2)
    tabel[f"gb p{int(tau * 100)}"] = boost.predict(grid).round(2)

print(pd.DataFrame(tabel).to_string(index=False))
Output:
   x  linear p10  gb p10  linear p50  gb p50  linear p90  gb p90
 0.0        2.59    3.05        3.02    3.05        3.27    3.88
 2.0        4.98    4.73        6.93    7.31        8.90    9.24
 4.0        7.37    6.72       10.85   11.65       14.54   16.19
 6.0        9.75   10.00       14.77   13.59       20.17   17.68
 8.0       12.14   12.43       18.68   17.59       25.81   24.65
10.0       14.53   11.92       22.60   15.51       31.44   31.00
Alur fit dan predict sama; yang berubah hanya fungsi objektifnya. Jarak p10 ke p90 melebar seiring x, tanda model menangkap heteroskedastisitas. Pada x = 10 prediksi boosting turun karena tree tidak mengekstrapolasi, sedangkan model linear melanjutkan tren.
Membandingkan Garis OLS dengan Pita Prediksi Kuantil
LinearRegression kita pakai sebagai baseline conditional mean. Menumpuk garis OLS, median, dan area p10–p90 pada satu plot memperlihatkan perbedaan perannya.
Pita yang melebar di sisi kanan menunjukkan ketidakpastian prediksi tidak konstan. Garis median dan OLS nyaris berimpit pada data simetris, tetapi berpisah ketika distribusi miring. Lebar pita pada setiap nilai x menjadi estimasi rentang tempat 80 persen observasi berada.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression, QuantileRegressor
from sklearn.ensemble import GradientBoostingRegressor

rng = np.random.default_rng(7)
x = rng.uniform(0, 10, 600)
y = 3 + 2 * x + rng.normal(0, 0.5 + 0.6 * x)
X, grid = x.reshape(-1, 1), np.linspace(0, 10, 200).reshape(-1, 1)

ols = LinearRegression().fit(X, y)
median = QuantileRegressor(quantile=0.5, alpha=0.0, solver="highs").fit(X, y)

band = {}
for tau in (0.1, 0.9):
    model = GradientBoostingRegressor(
        loss="quantile", alpha=tau, n_estimators=300,
        max_depth=2, learning_rate=0.05, random_state=42,
    )
    band[tau] = model.fit(X, y).predict(grid)

fig, ax = plt.subplots(figsize=(9, 5))
ax.scatter(x, y, s=12, alpha=0.35, color="#94a3b8", label="Data observasi")
ax.fill_between(grid.ravel(), band[0.1], band[0.9],
                color="#38bdf8", alpha=0.25, label="Pita p10-p90")
ax.plot(grid, median.predict(grid), color="#0f172a", lw=2, label="Median (p50)")
ax.plot(grid, ols.predict(grid), color="#dc2626", lw=2, ls="--", label="OLS (mean)")
ax.set_xlabel("Fitur x")
ax.set_ylabel("Target y")
ax.set_title("Pita kuantil p10-p90 dibanding garis OLS")
ax.legend(loc="upper left")
plt.savefig("public/images/blog/teori-dan-implementasi-quantile-regression-untuk-prediksi-nilai-ekstrem-dengan-scikit-learn-output-1.png", dpi=120, bbox_inches="tight")
plt.show()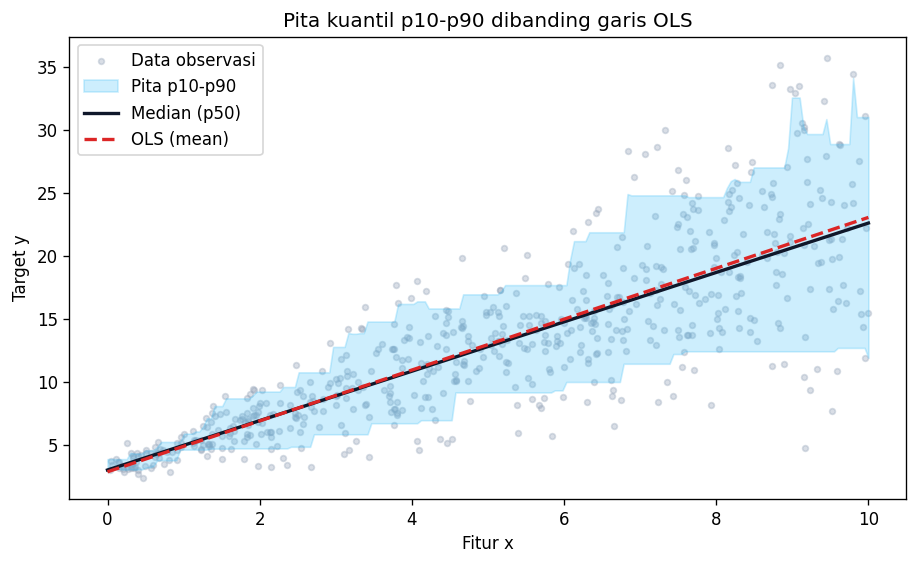
Interval kepercayaan OLS menjawab pertanyaan berbeda: seberapa yakin kita pada nilai rata-rata. Pada data heteroskedastik, interval itu bisa tampak sempit meski sebaran observasi lebar. Pita kuantil lebih informatif saat keputusan butuh batas skenario, misalnya kapasitas gudang untuk permintaan tinggi.
Sebaiknya kita membaca lebar pita sebagai rasio, bukan angka absolut. Bagi selisih p90 dan p10 dengan median pada x yang sama, lalu bandingkan rasio antar segmen data. Rasio yang naik menandakan sebaran relatif melebar, meski skala target berbeda jauh. Interval kepercayaan OLS tidak bisa dibaca dengan cara ini karena lebarnya berasal dari standard error koefisien. Nilai itu mengukur presisi estimasi garis, bukan rentang observasi. Ketika varians residual tidak konstan, asumsi di balik interval OLS juga dilanggar. Akibatnya batas bawah dan atasnya tidak lagi punya makna coverage yang jelas.
Mengevaluasi Model Kuantil dengan Pinball Loss dan Coverage
Metrik evaluasi harus konsisten dengan objektif training. Mean squared error menghukum model kuantil dengan cara yang salah karena tujuannya bukan mendekati rata-rata. Pinball loss per kuantil adalah pilihan yang tepat.
Coverage melengkapi loss. Empirical coverage adalah proporsi observasi aktual di bawah prediksi kuantil τ; untuk p90, nilai idealnya sekitar 0.90. Pita p10–p90 yang baik menangkap sekitar 80 persen data uji. Coverage di bawah target berarti pita terlalu sempit, sedangkan di atas target berarti pita terlalu lebar.
import numpy as np
import pandas as pd
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(7)
x = rng.uniform(0, 10, 600)
y = 3 + 2 * x + rng.normal(0, 0.5 + 0.6 * x)
X_train, X_test, y_train, y_test = train_test_split(
    x.reshape(-1, 1), y, test_size=0.25, random_state=42
)

def pinball(y_true, y_pred, tau):
    residual = y_true - y_pred
    return np.maximum(tau * residual, (tau - 1) * residual).mean()

preds, rows = {}, []
for tau in (0.1, 0.5, 0.9):
    model = GradientBoostingRegressor(
        loss="quantile", alpha=tau, n_estimators=300,
        max_depth=2, learning_rate=0.05, random_state=42,
    ).fit(X_train, y_train)
    preds[tau] = model.predict(X_test)
    rows.append({
        "quantil": tau,
        "pinball_loss": round(pinball(y_test, preds[tau], tau), 3),
        "coverage": round(np.mean(y_test <= preds[tau]), 3),
    })

band = np.mean((y_test >= preds[0.1]) & (y_test <= preds[0.9]))
print(pd.DataFrame(rows).to_string(index=False))
print(f"coverage pita p10-p90: {band:.3f} (target 0.80)")
print(f"quantile crossing: {np.sum(preds[0.9] < preds[0.1])} titik")
Output:
 quantil  pinball_loss  coverage
     0.1         0.636     0.093
     0.5         1.434     0.507
     0.9         0.648     0.873

coverage pita p10-p90: 0.780 (target 0.80)
quantile crossing: 0 titik
Hasil di atas sehat: coverage p10 dan p90 mengapit target, dan pita gabungan menangkap 78 persen data uji. Selisih dari 0.80 wajar karena data uji hanya 150 baris. Nilai loss tidak bisa dibandingkan antar kuantil karena skala penaltinya berbeda, jadi bandingkan loss hanya pada τ yang sama.
Quantile crossing terjadi ketika prediksi p90 lebih kecil dari p10 pada titik yang sama. Deteksinya cukup membandingkan dua vektor prediksi. Jika ditemukan, urutkan prediksi per baris atau latih model gabungan yang memaksa monotonisitas.
Praktik Terbaik dan Jebakan yang Sering Muncul
Kuantil ekstrem menuntut data lebih banyak. Kuantil 0.01 hanya memakai sekitar 1 persen observasi sebagai acuan, sehingga estimasinya mudah goyah pada sampel kecil. Jika data terbatas, gunakan 0.05 dan 0.95 sebagai kompromi, atau perbanyak sampel sebelum menurunkan τ.
Pemilihan kuantil sebaiknya mengikuti keputusan bisnis. Buffer stok permintaan tinggi bisa memakai p90, sementara anggaran risiko memakai p95. Memilih p10 dan p90 hanya karena simetris sering tidak sesuai dengan biaya kesalahan yang asimetris.
Interpretasi koefisien berubah antar kuantil. Fitur yang kuat di median belum tentu berpengaruh di ekor, jadi laporkan koefisien per kuantil.
Jebakan lain adalah menilai model kuantil dengan metrik rata-rata, lalu menyimpulkan model buruk padahal tujuannya berbeda. Evaluasi selalu dengan pinball loss dan coverage pada data uji. Di produksi, pantau coverage secara berkala karena pergeseran distribusi bisa membuat pita yang tadinya tepat menjadi terlalu sempit.
Untuk memantau drift, kita hitung coverage pada jendela bergulir, bukan pada seluruh riwayat. Pada jendela berisi n prediksi dengan target coverage c, simpangan bakunya sekitar akar dari c(1-c)/n. Coverage di luar dua simpangan baku layak diselidiki karena bisa berarti hubungan fitur-target berubah. Ukuran sampel mengikuti kuantil terkecil yang dipakai: p10 butuh sekitar 100 observasi agar ekor terisi, dan lebih aman sepuluh kali lipat. Kuantil 0.01 baru stabil setelah ribuan baris. Dokumentasikan alasan pemilihan kuantil, termasuk biaya kesalahan asimetris yang mendasarinya, agar revisi berikutnya punya jejak.
Ingin membangun alur machine learning end-to-end, dari eksplorasi distribusi sampai evaluasi model di produksi? Ikuti course dan bootcamp Rumah Coding untuk mempraktikkan langsung dengan Python dan Scikit-learn.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.