Memahami Konsep Deep Q-Network (DQN): Teori Reinforcement Learning dan Implementasinya dengan PyTorch dan Gymnasium
Dasar Reinforcement Learning dan Fungsi Nilai Q
Reinforcement learning (RL) melatih sebuah agent untuk mengambil keputusan lewat interaksi langsung dengan environment. Pada setiap langkah, agent menerima observasi state, memilih sebuah action, lalu environment mengembalikan reward dan state berikutnya. Tujuan agent bukan sekadar memaksimalkan reward pada satu langkah, melainkan memaksimalkan total reward dalam jangka panjang.
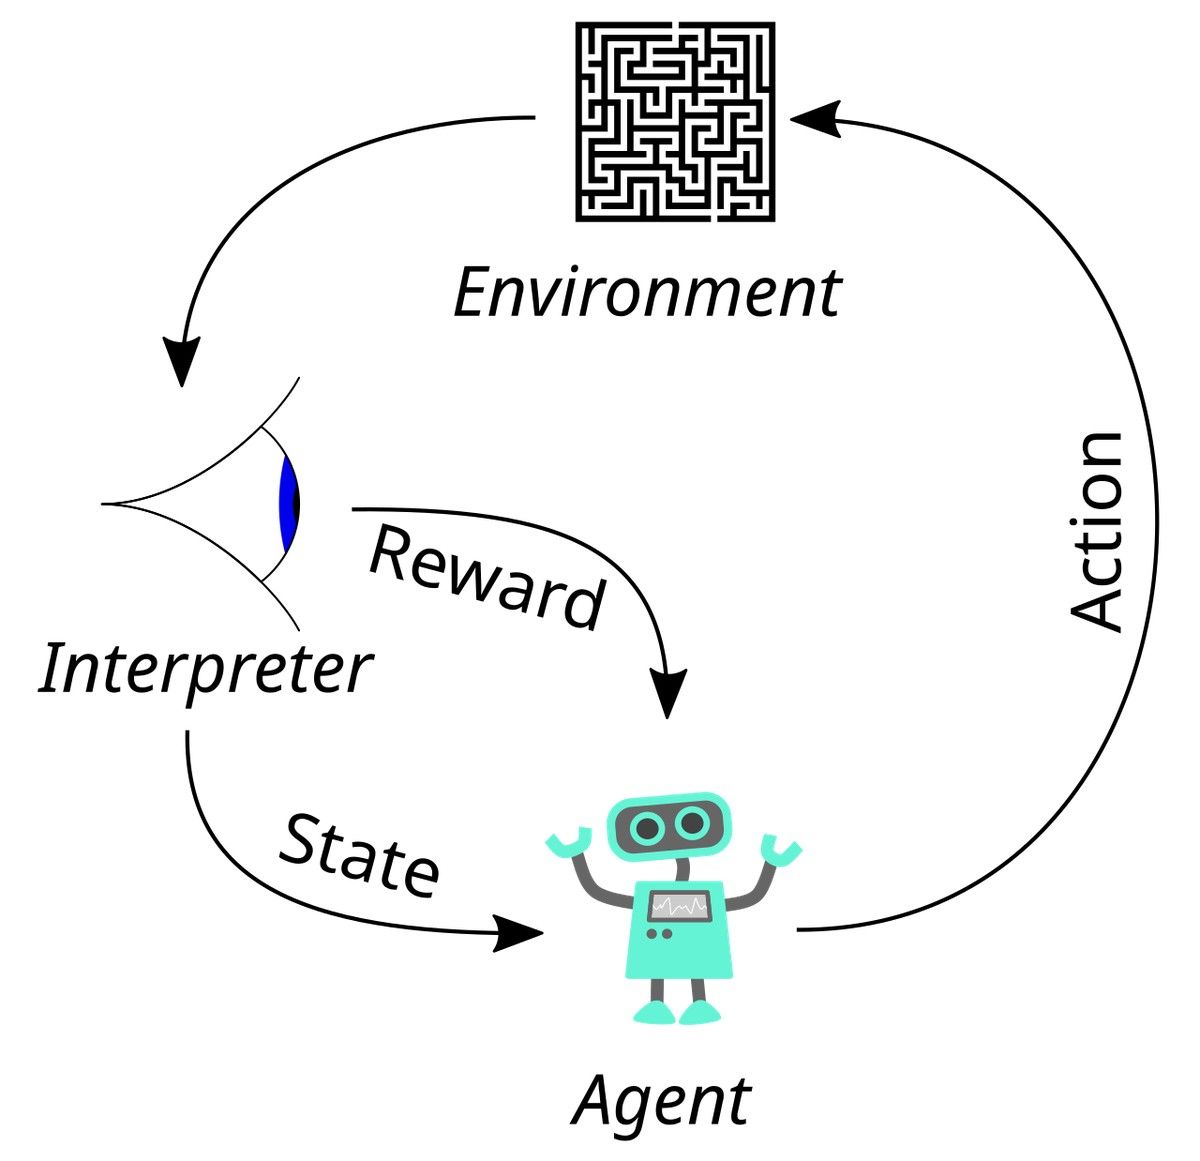
Gambar: Diagram interaksi agent dan environment dalam reinforcement learning — Sumber: Wikimedia Commons
Return adalah jumlah reward terdiskon dari satu titik waktu ke depan. Faktor diskon gamma menurunkan bobot reward yang datang jauh di masa depan. Nilai Q, atau Q-value, menyatakan ekspektasi return ketika agent memulai dari state s, mengambil action a, lalu mengikuti kebijakan optimal setelahnya. Dengan definisi ini, kita dapat membandingkan nilai setiap action pada state yang sama.
Persamaan Bellman menghubungkan nilai Q pada satu pasangan state-action dengan nilai Q pada langkah berikutnya. Relasi rekursif ini menjadi dasar dari seluruh algoritma Q-learning. Agent memperbaiki estimasi Q-value secara bertahap dari pengalaman yang dikumpulkan selama berinteraksi dengan environment.
Kebijakan (policy) menentukan action mana yang diambil agent pada state tertentu. Q-learning bersifat off-policy karena agent belajar nilai action optimal sambil tetap mengeksplorasi action lain. Perbedaan antara belajar dan bertindak ini memberi ruang bagi eksplorasi tanpa mengorbankan target pembelajaran.
Keterbatasan Q-Learning Tabular dan Peran Function Approximation
Q-learning versi tabular menyimpan satu Q-value untuk setiap kombinasi state dan action. Pendekatan ini bekerja baik ketika jumlah state kecil, misalnya grid sederhana atau permainan dengan ruang state terbatas. Namun ketika state space besar atau kontinu, tabel Q-value tumbuh tidak terkendali dan tidak mungkin diisi sepenuhnya. Sebagian besar state juga tidak pernah dikunjungi, sehingga estimasi tetap kosong.
Deep Q-Network (DQN) mengganti tabel dengan sebuah neural network. Jaringan menerima state sebagai input dan menghasilkan Q-value untuk setiap action sekaligus. Function approximation ini memungkinkan generalisasi: state yang mirip menghasilkan Q-value yang mirip, tanpa harus dikunjungi sebelumnya. Kemampuan ini menjadi kunci untuk masalah dengan state berdimensi tinggi.
Dua teknik menjadi kunci stabilitas DQN. Experience replay menyimpan transisi ke dalam buffer lalu mengambil sampel acak saat training, memecah korelasi antar sampel yang berurutan. Target network adalah salinan jaringan utama yang diperbarui secara berkala, sehingga target yang dipakai menghitung loss tidak berubah pada setiap langkah. Kedua mekanisme ini menstabilkan proses optimasi yang semula mudah berosilasi.
Tanpa kedua teknik ini, neural network dalam RL sering gagal konvergen. Sampel berurutan membuat pembaruan menjadi bias, sementara target yang berubah-ubah membuat jaringan mengejar target yang terus bergeser. DQN membuktikan bahwa kombinasi replay buffer dan target network cukup untuk melatih agent memainkan beberapa game Atari hanya dari piksel mentah.
Membangun Arsitektur Jaringan Q dengan PyTorch
Jaringan Q memetakan state ke vektor Q-value. Pada CartPole, state memiliki empat dimensi (posisi, kecepatan, sudut, kecepatan sudut) dan action berjumlah dua (dorong ke kiri atau ke kanan). Jaringan sederhana dengan beberapa lapisan Linear dan aktivasi ReLU sudah cukup untuk menyelesaikan masalah ini.
Kelas QNetwork mewarisi nn.Module dan menyusun lapisan di dalam nn.Sequential. Lapisan pertama menerima dimensi state, sedangkan lapisan terakhir menghasilkan dimensi action. Lapisan terakhir tidak memakai aktivasi karena output adalah Q-value mentah yang boleh bernilai negatif maupun positif. Struktur ini membuat satu forward pass mengembalikan seluruh Q-value untuk state yang diberikan.
Arsitektur kecil dengan satu lapisan tersembunyi sengaja dipilih. Masalah CartPole sederhana sehingga jaringan besar justru memperlambat konvergensi. Ketika state berubah menjadi citra beresolusi tinggi seperti pada game Atari, lapisan konvolusi menggantikan lapisan Linear untuk mengekstrak fitur spasial terlebih dahulu.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Kode berikut mendefinisikan arsitektur ini, lalu kita menjalankan satu forward pass untuk memastikan bentuk output benar.
!pip install torch gymnasium numpy

import torch
import torch.nn as nn


class QNetwork(nn.Module):
    def __init__(self, state_dim, action_dim, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(state_dim, hidden),
            nn.ReLU(),
            nn.Linear(hidden, hidden),
            nn.ReLU(),
            nn.Linear(hidden, action_dim),
        )

    def forward(self, x):
        return self.net(x)


state_dim = 4      # CartPole: posisi, kecepatan, sudut, kecepatan sudut
action_dim = 2     # dorong ke kiri atau ke kanan
q_net = QNetwork(state_dim, action_dim)

sample_state = torch.randn(1, state_dim)
q_values = q_net(sample_state)
print("Bentuk output Q-values:", q_values.shape)
print("Q-values:", q_values.detach().numpy())
Output:
Bentuk output Q-values: torch.Size([1, 2])
Q-values: [[ 0.05844189 -0.00886446]]
Output memperlihatkan bahwa satu state menghasilkan dua Q-value, satu untuk setiap action. Pada tahap inference, agent memilih action dengan Q-value tertinggi. Pada tahap training, jaringan menyesuaikan bobot agar Q-value untuk action yang menguntungkan semakin tinggi.
Membangun Experience Replay dan Target Network
Experience replay menyimpan transisi (state, action, reward, next_state, done) dalam deque berkapasitas tetap. Ketika buffer penuh, transisi terlama digantikan oleh transisi baru. Saat training, agent mengambil batch acak sehingga sampel dalam satu batch tidak saling berkorelasi. Proses ini membuat pembaruan bobot lebih stabil dibandingkan belajar langsung dari urutan transisi.
Target untuk setiap sampel dihitung dari rumus r + gamma * max Q'(next_state). Untuk state terminal dengan done bernilai true, tidak ada langkah berikutnya sehingga target hanya berupa reward. Untuk state non-terminal, target menambahkan estimasi nilai terbaik dari state berikutnya yang dihitung oleh target network, bukan jaringan utama. Pemisahan ini mencegah target bergerak bersamaan dengan bobot yang sedang diperbarui.
Kapasitas buffer dan ukuran batch memengaruhi kualitas pembelajaran. Buffer terlalu kecil membuat sampel tidak beragam, sedangkan batch terlalu besar memperlambat iterasi. Nilai diskon gamma mendekati satu membuat agent menghargai reward jangka panjang, sementara nilai lebih rendah membuat agent fokus pada reward langsung.
Kode berikut mendefinisikan ReplayBuffer dan mengisinya dengan transisi dummy untuk memverifikasi proses sampling.
import random
from collections import deque


class ReplayBuffer:
    def __init__(self, capacity=10000):
        self.buffer = deque(maxlen=capacity)

    def push(self, state, action, reward, next_state, done):
        self.buffer.append((state, action, reward, next_state, done))

    def sample(self, batch_size):
        batch = random.sample(self.buffer, batch_size)
        states, actions, rewards, next_states, dones = zip(*batch)
        return (torch.tensor(states, dtype=torch.float32),
                torch.tensor(actions, dtype=torch.long),
                torch.tensor(rewards, dtype=torch.float32),
                torch.tensor(next_states, dtype=torch.float32),
                torch.tensor(dones, dtype=torch.float32))

    def __len__(self):
        return len(self.buffer)


gamma = 0.99
replay = ReplayBuffer()

for _ in range(2000):
    s = [random.uniform(-1, 1) for _ in range(4)]
    a = random.randint(0, 1)
    r = random.uniform(0, 1)
    ns = [random.uniform(-1, 1) for _ in range(4)]
    d = random.choice([True, False])
    replay.push(s, a, r, ns, d)

print("Ukuran buffer:", len(replay))
states, actions, rewards, next_states, dones = replay.sample(64)
print("Batch states:", states.shape, "| Batch actions:", actions.shape)
Output:
Ukuran buffer: 2000
Batch states: torch.Size([64, 4]) | Batch actions: torch.Size([64])
Output menunjukkan buffer menyimpan 2000 transisi dan sampling menghasilkan batch dengan bentuk yang tepat. Tensor states berbentuk 64x4 untuk 64 state berdimensi empat, sementara actions berbentuk 64 untuk 64 action terpilih. Bentuk ini sesuai dengan kebutuhan lapisan jaringan pada bagian sebelumnya.
Training Loop di CartPole dan Evaluasi Hasil
Proses training berjalan per episode. Setiap episode dimulai dari state awal lalu agent berinteraksi sampai episode berakhir, baik karena cart jatuh maupun mencapai batas langkah. Kebijakan epsilon-greedy menyeimbangkan eksplorasi dan eksploitasi: dengan probabilitas epsilon, agent memilih action acak, sedangkan sisanya memilih action dengan Q-value tertinggi. Nilai epsilon menurun sepanjang training agar agent semakin mengandalkan pembelajaran.
Setelah buffer terisi minimal sebesar batch size, agent menjalankan satu langkah optimasi pada setiap timestep. Loss dihitung sebagai selisih kuadrat antara Q-value saat ini dan target. Optimizer Adam memperbarui bobot jaringan utama. Target network diperbarui setiap beberapa episode dengan menyalin bobot jaringan utama, menjaga target tetap stabil selama training berlangsung.
Kode berikut menjalankan training selama 200 episode dan memplot skor per episode.
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
import torch.optim as optim

env = gym.make("CartPole-v1")
state_dim = env.observation_space.shape[0]
action_dim = env.action_space.n

q_net = QNetwork(state_dim, action_dim)
target_net = QNetwork(state_dim, action_dim)
target_net.load_state_dict(q_net.state_dict())
target_net.eval()

optimizer = optim.Adam(q_net.parameters(), lr=1e-3)
replay = ReplayBuffer(capacity=10000)

epsilon = 1.0
epsilon_min = 0.01
epsilon_decay = 0.995
batch_size = 64
target_update = 10

episode_rewards = []

for episode in range(200):
    state, _ = env.reset()
    total_reward = 0
    done = False

    while not done:
        if np.random.rand() < epsilon:
            action = env.action_space.sample()
        else:
            with torch.no_grad():
                q_vals = q_net(torch.tensor(state, dtype=torch.float32).unsqueeze(0))
            action = int(q_vals.argmax().item())

        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated

        replay.push(state, action, reward, next_state, done)
        state = next_state
        total_reward += reward

        if len(replay) >= batch_size:
            states, actions, rewards, next_states, dones = replay.sample(batch_size)
            with torch.no_grad():
                next_q = target_net(next_states).max(dim=1).values
                target = rewards + gamma * next_q * (1 - dones)
            current_q = q_net(states).gather(1, actions.unsqueeze(1)).squeeze(1)
            loss = nn.MSELoss()(current_q, target)

            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

    episode_rewards.append(total_reward)

    if episode % target_update == 0:
        target_net.load_state_dict(q_net.state_dict())

    epsilon = max(epsilon_min, epsilon * epsilon_decay)

    if (episode + 1) % 40 == 0:
        avg = np.mean(episode_rewards[-40:])
        print(f"Episode {episode+1}: rata-rata reward = {avg:.1f}, epsilon = {epsilon:.3f}")

env.close()

plt.plot(episode_rewards)
plt.xlabel("Episode")
plt.ylabel("Total Reward")
plt.title("Skor CartPole per Episode")
plt.show()
Output:
Episode 40: rata-rata reward = 22.7, epsilon = 0.818
Episode 80: rata-rata reward = 36.5, epsilon = 0.670
Episode 120: rata-rata reward = 66.8, epsilon = 0.548
Episode 160: rata-rata reward = 94.6, epsilon = 0.448
Episode 200: rata-rata reward = 79.8, epsilon = 0.367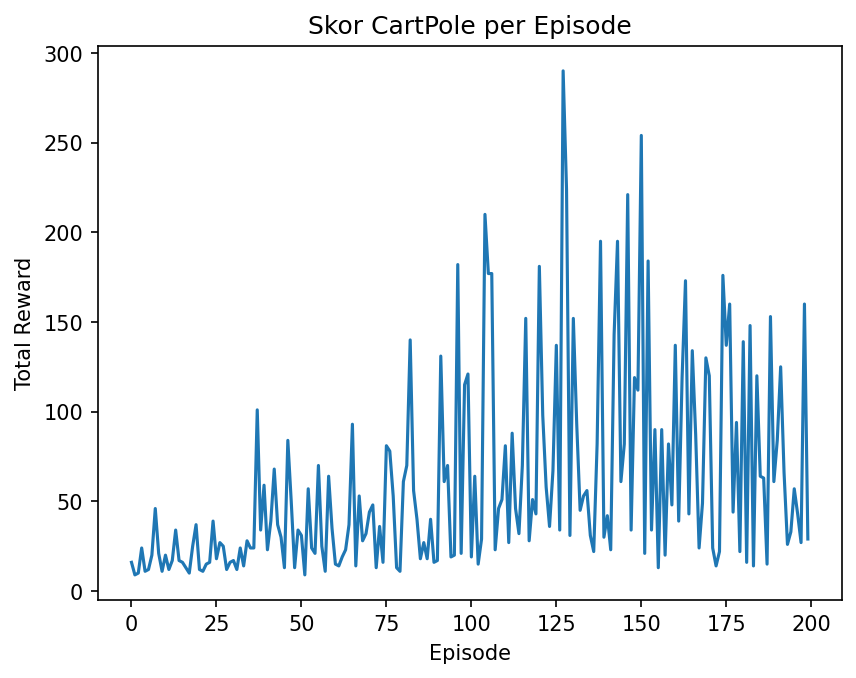
Grafik menunjukkan skor total per episode yang meningkat seiring berjalannya training. Pada episode awal, agent hampir selalu gagal karena masih mengeksplorasi action secara acak. Seiring epsilon menurun, agent semakin sering memilih action yang sudah dipelajari dan mampu menyeimbangkan cart lebih lama. Peningkatan rata-rata reward menandakan jaringan Q berhasil menangkap hubungan antara state dan nilai action.
Model sederhana ini masih menyisakan keterbatasan. Q-learning rentan terhadap overestimation karena operasi max memilih estimasi yang terlalu optimis. Varian seperti Double DQN mengatasi masalah ini dengan memisahkan pemilihan dan evaluasi action. Memahami bias ini penting sebelum berpindah ke algoritma yang lebih kompleks seperti DDPG atau PPO.
Tertarik mendalami reinforcement learning dan deep learning secara terstruktur? Bootcamp Deep Learning di Rumah Coding membimbing dari teori hingga membangun model nyata dengan proyek terbimbing dan mentorship langsung.
Kursus Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.