Memahami Konsep Loss Function: Teori Cross-Entropy dan MSE dengan Implementasi NumPy dari Nol

Mengapa Loss Function Menentukan Arah Training Model
Setiap model supervised learning membutuhkan satu angka yang menjawab pertanyaan sederhana. Seberapa jauh prediksi model dari label yang benar. Angka tersebut dihitung oleh loss function. Kita menggunakan nilai loss untuk memutuskan apakah weights perlu diperbarui dan seberapa besar langkah perbaikannya.
Proses training pada dasarnya adalah optimasi. Kita menghitung loss pada satu batch data. Kita menghitung gradien loss terhadap setiap parameter dengan backpropagation. Kita menggeser parameter ke arah yang menurunkan loss menggunakan gradient descent. Tanpa loss yang tepat, gradien tidak memberikan sinyal yang benar dan model berhenti belajar meskipun akurasi masih rendah.
Pemilihan loss mengikuti jenis target. Masalah regresi memprediksi nilai kontinu seperti harga atau suhu. Masalah klasifikasi memprediksi distribusi probabilitas atas kelas diskret. Kesalahan memilih loss membuat training lambat atau tidak stabil. Loss yang tepat memberi skala gradien yang konsisten di setiap batch. Skala yang konsisten membuat tuning learning rate lebih mudah dan evaluasi antar eksperimen lebih adil. Bagian berikut membahas dua loss yang paling sering kita temui. Kita mulai dari regresi dengan MSE.
Cara Kerja Mean Squared Error untuk Masalah Regresi
Mean Squared Error menghitung rata-rata dari kuadrat selisih antara prediksi dan target. Formula untuk n sampel adalah MSE = (1/n) * sum((y_pred - y_true)^2). Operasi kuadrat memberi penalti lebih besar pada error besar. Operasi rata-rata membuat nilai loss tidak bergantung pada ukuran batch.
Efek kuadrat mudah kita lihat pada contoh kecil. Selisih 0.1 memberi kontribusi 0.01 pada loss. Selisih 1.0 memberi kontribusi 1.0. Model mendapat insentif kuat untuk memperbaiki prediksi yang meleset jauh terlebih dahulu. Sifat tersebut membantu konvergensi ketika data relatif bersih. Sifat yang sama membuat MSE sensitif terhadap outlier karena satu sampel ekstrem dapat mendominasi total loss.
Kita memakai MSE ketika error berdistribusi mendekati Gaussian dan outlier sudah ditangani. Kita menghindari MSE murni ketika dataset mengandung banyak outlier tanpa preprocessing. Alternatif seperti MAE atau Huber loss memberi penalti linear dan lebih robust. Kode berikut menghitung MSE manual dan menunjukkan efek outlier.
!pip install numpy

import numpy as np

def mse(y_true, y_pred):
    y_true = np.array(y_true, dtype=float)
    y_pred = np.array(y_pred, dtype=float)
    return np.mean((y_pred - y_true) ** 2)

y_true = np.array([2.0, 3.0, 4.0, 5.0])
y_clean = np.array([2.1, 2.9, 4.2, 4.8])
y_outlier = np.array([2.1, 2.9, 4.2, 9.0])

print("MSE tanpa outlier:", mse(y_true, y_clean))
print("MSE dengan outlier:", mse(y_true, y_outlier))
Output:
MSE tanpa outlier: 0.025000000000000043
MSE dengan outlier: 4.015
Penjelasan kode berfokus pada workflow perhitungan. Fungsi mse mengubah input menjadi array numpy lalu menghitung rata-rata kuadrat selisih. Array pertama mensimulasikan prediksi yang dekat dengan target. Array kedua menyisipkan satu outlier pada sampel terakhir. Output yang diharapkan menunjukkan lonjakan loss yang besar akibat satu nilai ekstrem.
Cara Kerja Cross-Entropy untuk Masalah Klasifikasi
Cross-Entropy mengukur jarak antara distribusi target dan distribusi prediksi. Formula binary cross-entropy untuk satu sampel adalah BCE = -(y log(p) + (1 - y) log(1 - p)). Formula categorical cross-entropy untuk C kelas adalah CCE = -sum(y_c * log(p_c)). Nilai loss membesar ketika model memberi probabilitas kecil pada kelas yang benar.
Fungsi aktivasi mengubah skor mentah menjadi probabilitas sebelum loss dihitung. Fungsi sigmoid memetakan satu logit ke rentang [0, 1] untuk klasifikasi biner. Fungsi softmax menormalisasi vektor logit menjadi distribusi yang jumlahnya satu untuk multikelas. Kombinasi softmax dan CCE atau sigmoid dan BCE menghasilkan gradien yang sederhana dan stabil selama training.
Penalti logaritmik memberi perilaku yang berbeda dari kuadrat. Prediksi yang salah dengan keyakinan tinggi mendapat hukuman sangat besar. Prediksi yang ragu-ragu mendapat hukuman moderat. Sifat tersebut mendorong model untuk kalibrasi probabilitas, bukan sekadar menebak kelas. Kode berikut mengimplementasikan aktivasi dan loss dari nol.
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
!pip install numpy

import numpy as np

def sigmoid(z):
    return 1.0 / (1.0 + np.exp(-z))

def softmax(logits):
    logits = np.array(logits, dtype=float)
    shifted = logits - np.max(logits)
    exp_vals = np.exp(shifted)
    return exp_vals / np.sum(exp_vals)

def binary_cross_entropy(y_true, y_prob, eps=1e-12):
    y_prob = np.clip(y_prob, eps, 1.0 - eps)
    return -(y_true * np.log(y_prob) + (1 - y_true) * np.log(1 - y_prob))

def categorical_cross_entropy(y_true_onehot, y_prob, eps=1e-12):
    y_prob = np.clip(y_prob, eps, 1.0 - eps)
    return -np.sum(np.array(y_true_onehot) * np.log(y_prob))

print("Sigmoid(0):", sigmoid(0.0))
print("Softmax:", softmax([2.0, 1.0, 0.1]))
print("BCE yakin benar:", binary_cross_entropy(1, 0.9))
print("BCE yakin salah:", binary_cross_entropy(1, 0.1))
print("CCE benar:", categorical_cross_entropy([0, 1, 0], [0.1, 0.8, 0.1]))
Output:
Sigmoid(0): 0.5
Softmax: [0.65900114 0.24243297 0.09856589]
BCE yakin benar: 0.10536051565782628
BCE yakin salah: 2.3025850929940455
CCE benar: 0.2231435513142097
Penjelasan kode berfokus pada logika probabilitas. Fungsi sigmoid dan softmax mengubah logit menjadi probabilitas yang valid. Fungsi binary_cross_entropy dan categorical_cross_entropy memakai clip dengan epsilon untuk menghindari log(0). Output yang diharapkan menunjukkan loss kecil untuk prediksi yang tepat dan loss besar untuk prediksi yang salah dengan keyakinan tinggi.
Gambar: Dashboard monitoring metrik training yang menampilkan kurva loss dan akurasi untuk evaluasi perilaku model — Sumber: Unsplash
Mengimplementasikan MSE dan Cross-Entropy dari Nol dengan NumPy
Implementasi dari nol membantu kita memahami stabilitas numerik dan bentuk batch. Kita menulis tiga fungsi murni dengan numpy tanpa framework deep learning. Kita menambahkan clip pada setiap probabilitas. Kita memakai operasi vektor agar kode bekerja untuk satu sampel maupun satu batch.
Verifikasi dilakukan dengan data sintetis kecil. Kita membandingkan hasil fungsi dengan perhitungan manual untuk dua atau tiga sampel. Kita memeriksa bahwa loss menurun ketika prediksi mendekati target. Kita memeriksa bahwa gradien numerik mengarah ke koreksi yang benar. Praktik verifikasi sederhana tersebut mencegah bug yang sulit dilacak pada training loop yang lebih besar.
!pip install numpy matplotlib

import numpy as np
import matplotlib.pyplot as plt

def mse_loss(y_true, y_pred):
    return np.mean((np.asarray(y_pred) - np.asarray(y_true)) ** 2)

def bce_loss(y_true, y_prob, eps=1e-12):
    p = np.clip(np.asarray(y_prob, dtype=float), eps, 1 - eps)
    y = np.asarray(y_true, dtype=float)
    return np.mean(-(y * np.log(p) + (1 - y) * np.log(1 - p)))

y_true = np.array([0.0, 1.0, 1.0, 0.0])
y_pred_reg = np.array([0.1, 0.9, 0.8, 0.2])
y_prob = np.array([0.15, 0.85, 0.7, 0.3])

print("MSE:", mse_loss(y_true, y_pred_reg))
print("BCE:", bce_loss(y_true, y_prob))

probs = np.linspace(0.01, 0.99, 100)
losses = [-np.log(p) for p in probs]

plt.figure()
plt.plot(probs, losses)
plt.xlabel("Predicted probability for true class")
plt.ylabel("Loss")
plt.title("Kurva Binary Cross-Entropy untuk label 1")
plt.grid(alpha=0.3)
plt.show()
Output:
MSE: 0.024999999999999994
BCE: 0.2595969367182537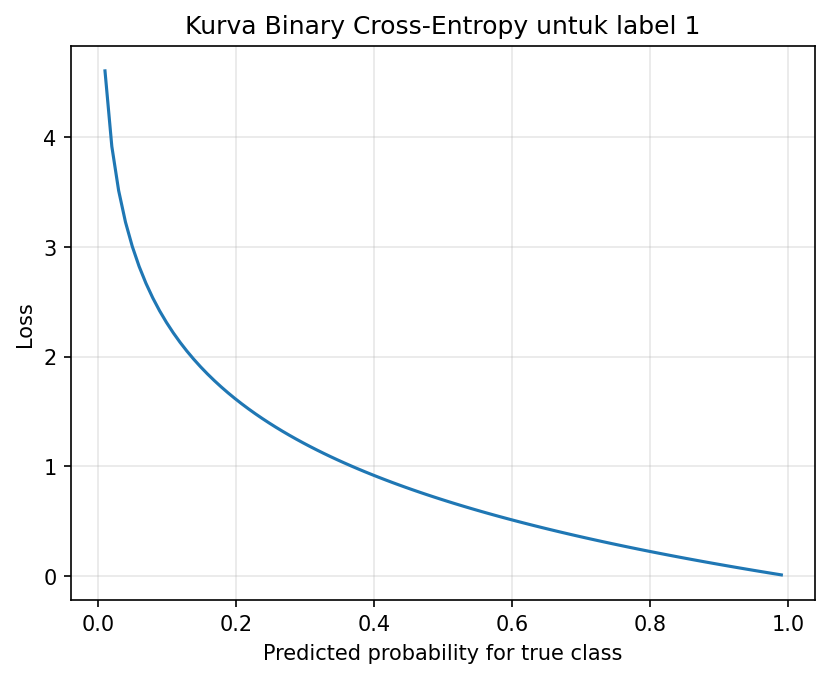
Penjelasan kode berfokus pada workflow verifikasi. Dua fungsi loss menerima array numpy dan mengembalikan satu nilai rata-rata. Array sintetis mensimulasikan empat sampel biner dengan prediksi yang cukup baik. Plot kurva menunjukkan loss mendekati nol saat probabilitas mendekati satu dan melonjak saat probabilitas mendekati nol. Output yang diharapkan berupa dua angka loss kecil plus satu grafik kurva monoton turun.
Membandingkan Perilaku Gradien dan Memilih Loss yang Tepat
Gradien menentukan kecepatan dan stabilitas belajar. Gradien MSE terhadap prediksi adalah (2/n) * (y_pred - y_true). Bentuk tersebut linear dan mudah dihitung. Gradien BCE dengan sigmoid terhadap logit adalah (p - y). Bentuk tersebut juga sederhana, tetapi skala gradien tetap besar ketika model salah dengan keyakinan tinggi. Perbedaan tersebut menjelaskan mengapa klasifikasi dengan MSE sering berlatih lebih lambat pada output sigmoid yang jenuh.
Gambar: Formulasi matematis yang mendasari loss function dan optimasi gradien pada model machine learning — Sumber: Unsplash
Tabel keputusan membantu kita memilih dengan cepat. Tugas regresi memakai MSE ketika outlier terkendali dan memakai MAE atau Huber ketika outlier banyak. Klasifikasi biner memakai BCE dengan satu output sigmoid. Klasifikasi multikelas memakai CCE dengan output softmax. Klasifikasi multilabel memakai BCE per kelas dengan beberapa output sigmoid independen.
Praktik monitoring melengkapi pemilihan loss. Kurva training yang turun mulus menandakan konfigurasi yang sehat. Kurva validasi yang naik sementara kurva training terus turun menandakan overfitting. Nilai loss yang NaN atau melonjak tiba-tiba menandakan learning rate terlalu besar atau probabilitas tidak di-clip. Kita menyimpan checkpoint saat validation loss terbaik tercapai. Kita membandingkan beberapa run dengan seed berbeda sebelum menarik kesimpulan. Kode berikut membandingkan bentuk kurva MSE dan BCE secara visual.
!pip install numpy matplotlib

import numpy as np
import matplotlib.pyplot as plt

target = 1.0
preds = np.linspace(0.0, 1.0, 200)
mse_curve = (preds - target) ** 2
eps = 1e-12
p = np.clip(preds, eps, 1 - eps)
bce_curve = -(target * np.log(p) + (1 - target) * np.log(1 - p))
bce_curve = np.clip(bce_curve, 0, 8)

plt.figure()
plt.plot(preds, mse_curve, label="MSE")
plt.plot(preds, bce_curve, label="BCE")
plt.xlabel("Prediksi")
plt.ylabel("Loss")
plt.title("Perbandingan Kurva MSE dan BCE untuk target 1")
plt.legend()
plt.grid(alpha=0.3)
plt.show()

print("MSE pada 0.1:", (0.1 - 1.0) ** 2)
print("BCE pada 0.1:", -(np.log(0.1)))
Output:
MSE pada 0.1: 0.81
BCE pada 0.1: 2.3025850929940455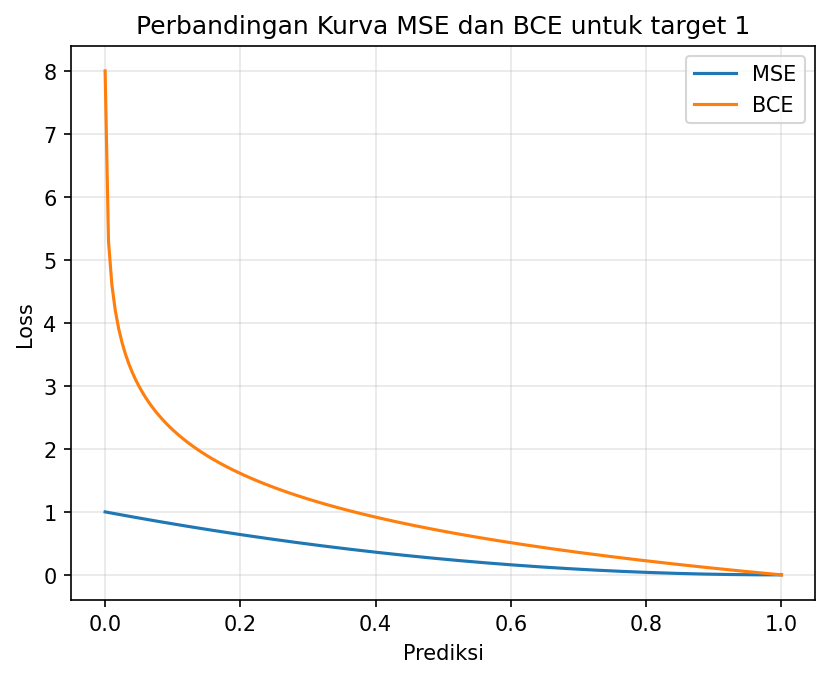
Penjelasan kode berfokus pada interpretasi visual. Array preds menggeser prediksi dari nol ke satu sementara target tetap satu. Kurva MSE berbentuk parabola dengan penalti terbatas. Kurva BCE berbentuk logaritmik dengan penalti yang melonjak tajam saat prediksi mendekati nol. Output yang diharapkan berupa grafik dua kurva plus dua angka yang menunjukkan BCE menghukum kesalahan yakin jauh lebih berat daripada MSE.
Ikuti bootcamp Machine Learning di Rumah Coding untuk melatih intuisi loss, gradien, dan evaluasi model melalui proyek terbimbing dengan dataset nyata.
Kursus Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Machine Learning Bootcamp
A beginner-friendly, 7-week project-based bootcamp designed to take you from Python basics to deploying your first Machine Learning model. Through hands-on practice, you will master essential data manipulation, build predictive algorithms, and develop an end-to-end, industry-ready application to kickstart your career in data science.
End-to-End Student Success Predictor
- Automated Data Pipeline: A preprocessing script that automatically cleans missing values, encodes categorical data (like course type or student background), and scales numerical inputs.
- Predictive Engine: A tuned machine learning classification model (e.g., Random Forest) specifically optimized for high Recall, ensuring that "at-risk" students are not missed.
- Interactive Web Dashboard: A user-friendly Streamlit interface featuring a sidebar where instructors can manually input a student's study hours, quiz scores, and login frequency to get an instant pass/fail probability.