Memahami Layer Normalization dan Implementasinya dengan PyTorch untuk Training yang Stabil
Mengenali Pergeseran Distribusi Aktivasi di Setiap Layer
Output sebuah layer bergantung pada bobot yang sedang dipakai. Ketika optimizer memperbarui bobot tersebut, distribusi aktivasi yang diterima layer berikutnya ikut bergeser. Layer berikutnya lalu harus beradaptasi dengan target yang bergerak, dan proses adaptasi itu memakan kapasitas representasi yang seharusnya dipakai untuk mempelajari pola data.
Geseran ini tidak terlihat langsung pada loss. Yang kita amati adalah gejala di tingkat optimasi: gradient antar layer memiliki skala yang berbeda jauh, sebagian layer belajar cepat sementara layer lain hampir tidak bergerak, dan satu learning rate yang sama bekerja baik di satu layer tetapi merusak layer lain. Memilih learning rate menjadi kompromi, bukan keputusan berdasarkan analisis.
Penting untuk membedakan masalah ini dari overfitting. Overfitting adalah persoalan generalisasi, terlihat dari validation loss yang naik sementara training loss turun. Pergeseran distribusi aktivasi adalah persoalan optimasi, dan gejalanya muncul bahkan ketika model belum sempat menghafal data.
Normalisasi menjawab masalah tersebut dengan menstabilkan skala aktivasi sebelum masuk ke layer berikutnya. Setiap layer menerima input dengan skala yang konsisten, sehingga gradient antar layer tidak lagi berbeda beberapa orde besaran.
Efek sampingnya juga terasa pada pemilihan optimizer. Ketika skala aktivasi seragam, satu nilai learning rate menghasilkan langkah yang sebanding di seluruh parameter, dan kebutuhan akan learning rate warmup yang panjang berkurang. Kita tidak perlu lagi menebak nilai awal yang aman untuk setiap arsitektur.
Menormalkan Aktivasi per Sampel, Bukan per Batch
Layer Normalization menghitung mean dan variance sepanjang dimensi fitur untuk setiap sampel. Untuk tensor dengan bentuk (batch, fitur), statistik dihitung pada sumbu fitur. Untuk tensor sekuens dengan bentuk (batch, token, fitur), statistik dihitung pada sumbu fitur untuk setiap pasangan batch dan token.
Rumusnya terdiri dari dua tahap. Tahap pertama menormalkan setiap nilai dengan statistik sampel tersebut:
Tahap kedua menskalakan hasil normalisasi dengan parameter learnable gamma dan beta:
Parameter gamma dan beta berukuran sama dengan dimensi fitur dan diinisialisasi ke satu dan nol. Dengan inisialisasi ini, layer normalization di awal training bersifat identitas setelah normalisasi, lalu model bebas mempelajari skala dan offset yang paling sesuai. Nilai epsilon kecil mencegah pembagian dengan nol ketika variance mendekati nol.
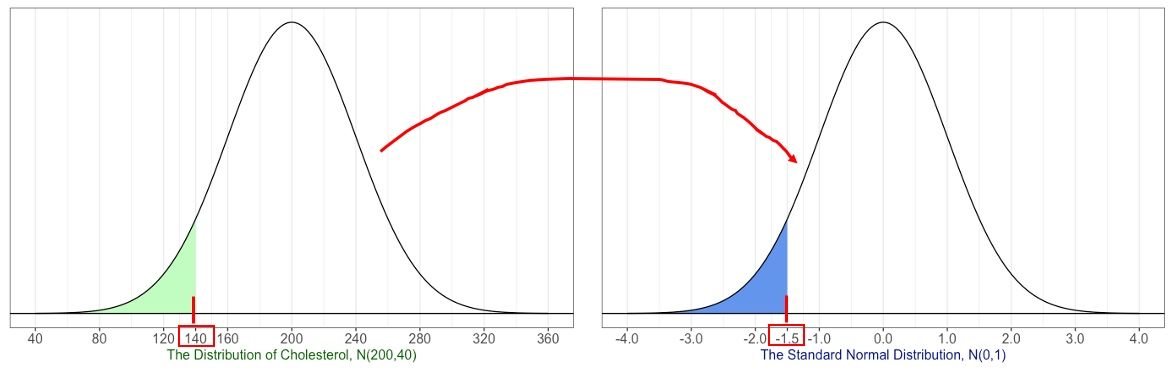
Gambar: Standardisasi distribusi N(200, 40) menjadi N(0, 1) — Sumber: Wikimedia Commons, oleh ASpiegler, CC BY-SA 4.0.
Perbedaan mendasar dengan Batch Normalization terletak pada sumbu perhitungan. Batch Normalization memakai statistik lintas sampel dalam satu batch, sehingga hasilnya bergantung pada batch size dan bermasalah ketika batch hanya berisi satu sampel. Layer Normalization tidak memiliki ketergantungan itu. Setiap sampel dinormalkan secara mandiri, dan properti ini yang membuat layer normalization menjadi pilihan default untuk arsitektur sekuens seperti RNN dan Transformer.
Membangun Layer Normalization dari Nol dengan PyTorch
Implementasi manual membantu kita memastikan tidak ada detail yang tertutup oleh abstraksi library. Tiga keputusan penting ada di dalam fungsi forward: perhitungan mean dan var dengan keepdim=True agar bentuk tensor tetap bisa di-broadcast, pemakaian unbiased=False agar variance dihitung sebagai variance populasi seperti di nn.LayerNorm, dan penambahan epsilon di dalam akar.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
!pip install torch

import torch
import torch.nn as nn


class ManualLayerNorm(nn.Module):
    def __init__(self, dim, eps=1e-5):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(dim))
        self.bias = nn.Parameter(torch.zeros(dim))

    def forward(self, x):
        mean = x.mean(dim=-1, keepdim=True)
        var = x.var(dim=-1, unbiased=False, keepdim=True)
        normalized = (x - mean) / torch.sqrt(var + self.eps)
        return normalized * self.weight + self.bias


torch.manual_seed(0)
x = torch.randn(8, 16) * 5 + 3

manual = ManualLayerNorm(16)
reference = nn.LayerNorm(16)

out_manual = manual(x)
out_reference = reference(x)

print("shape:", tuple(out_manual.shape))
print("max diff:", (out_manual - out_reference).abs().max().item())
print("max |mean|:", out_manual.mean(dim=-1).abs().max().item())
print("min std:", out_manual.std(dim=-1, unbiased=False).min().item())
Output:
shape: (8, 16)
max diff: 2.384185791015625e-07
max |mean|: 8.940696716308594e-08
min std: 0.9999997019767761
Input sengaja dibuat dengan skala besar dan offset tiga agar efek normalisasi terlihat. Setelah dijalankan, selisih maksimum terhadap nn.LayerNorm berada di kisaran 2.4e-07, yang seluruhnya berasal dari error pembulatan floating point. Nilai mean per baris mendekati nol dan standar deviasi per baris mendekati satu, tepat seperti yang diharapkan dari definisi.
Menguji Dampak Normalisasi pada Training Model Kecil
Klaim tentang stabilitas perlu dibuktikan dengan eksperimen. Kita menyiapkan dataset regresi sintetis dengan enam belas fitur yang skalanya membentang dari satu hingga seratus, lalu melatih dua MLP identik. Satu model memakai nn.LayerNorm setelah setiap linear layer, satu model lagi memakai nn.Identity sebagai pembanding.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

torch.manual_seed(42)

n_samples, n_features = 512, 16
X = torch.randn(n_samples, n_features) * torch.logspace(0, 2, n_features)
true_w = torch.randn(n_features, 1)
y = X @ true_w + 0.1 * torch.randn(n_samples, 1)
y = (y - y.mean()) / y.std()


class MLP(nn.Module):
    def __init__(self, use_norm):
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(n_features, 64),
            nn.LayerNorm(64) if use_norm else nn.Identity(),
            nn.ReLU(),
            nn.Linear(64, 64),
            nn.LayerNorm(64) if use_norm else nn.Identity(),
            nn.ReLU(),
            nn.Linear(64, 1),
        )

    def forward(self, x):
        return self.layers(x)


def train(use_norm, steps=200, lr=0.005):
    torch.manual_seed(7)
    model = MLP(use_norm)
    optimizer = torch.optim.SGD(model.parameters(), lr=lr)
    loss_fn = nn.MSELoss()
    history = []
    for _ in range(steps):
        optimizer.zero_grad()
        loss = loss_fn(model(X), y)
        loss.backward()
        optimizer.step()
        history.append(loss.item())
    return history


loss_plain = train(use_norm=False)
loss_norm = train(use_norm=True)

print(f"loss akhir tanpa LayerNorm : {loss_plain[-1]:.4f}")
print(f"loss akhir dengan LayerNorm: {loss_norm[-1]:.4f}")
print(f"loss minimum tanpa LayerNorm : {min(loss_plain):.4f}")

plt.figure(figsize=(8, 4.5))
plt.plot(loss_plain, label="tanpa LayerNorm")
plt.plot(loss_norm, label="dengan LayerNorm")
plt.yscale("log")
plt.xlabel("step")
plt.ylabel("MSE loss (log scale)")
plt.title("Kurva training pada fitur dengan skala tidak seragam")
plt.legend()
plt.tight_layout()
Output:
loss akhir tanpa LayerNorm : 3473.3005
loss akhir dengan LayerNorm: 0.1021
loss minimum tanpa LayerNorm : 14.1253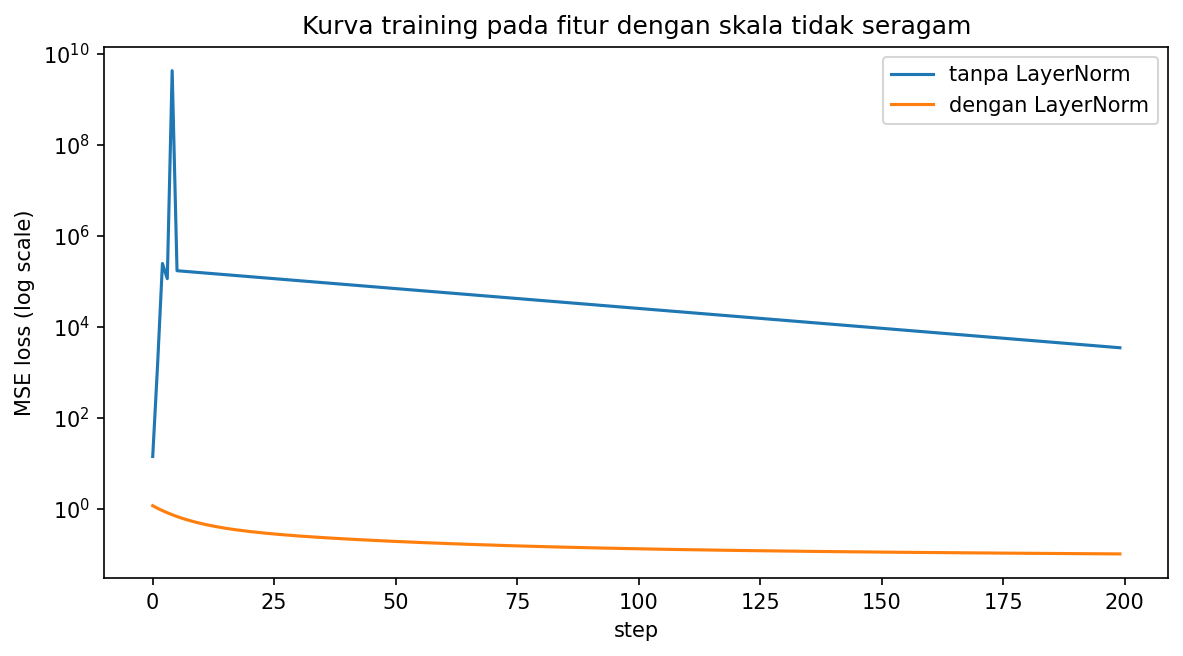
Dengan learning rate 0.005, model tanpa normalisasi tidak stabil dan loss akhirnya melonjak ke kisaran 3473. Model dengan normalisasi turun mulus dan berhenti di sekitar 0.1021. Penyebabnya ada pada gradient: fitur berskala besar mendominasi gradient bobot pertama, sehingga satu learning rate menghasilkan langkah yang terlalu besar untuk sebagian parameter dan terlalu kecil untuk parameter lain. Layer Normalization menyetarakan skala aktivasi, sehingga langkah optimizer memiliki dampak yang sebanding di seluruh layer.
Perlu dicatat bahwa normalisasi bukan jaminan loss akhir yang selalu lebih rendah. Pada learning rate yang sangat kecil, kedua model sama-sama konvergen. Yang berubah adalah lebar rentang learning rate yang aman. Tanpa normalisasi, rentang itu sempit dan mudah terlewati; dengan normalisasi, rentang tersebut melebar sehingga tuning menjadi lebih toleran.
Menempatkan Layer Normalization di Blok Transformer
Pada blok Transformer, posisi normalisasi menentukan perilaku gradient. Pre-LN menempatkan nn.LayerNorm sebelum attention dan feed-forward, lalu menambahkan hasilnya ke residual stream. Post-LN menempatkan normalisasi setelah penjumlahan residual, sehingga output setiap blok selalu berskala satu.
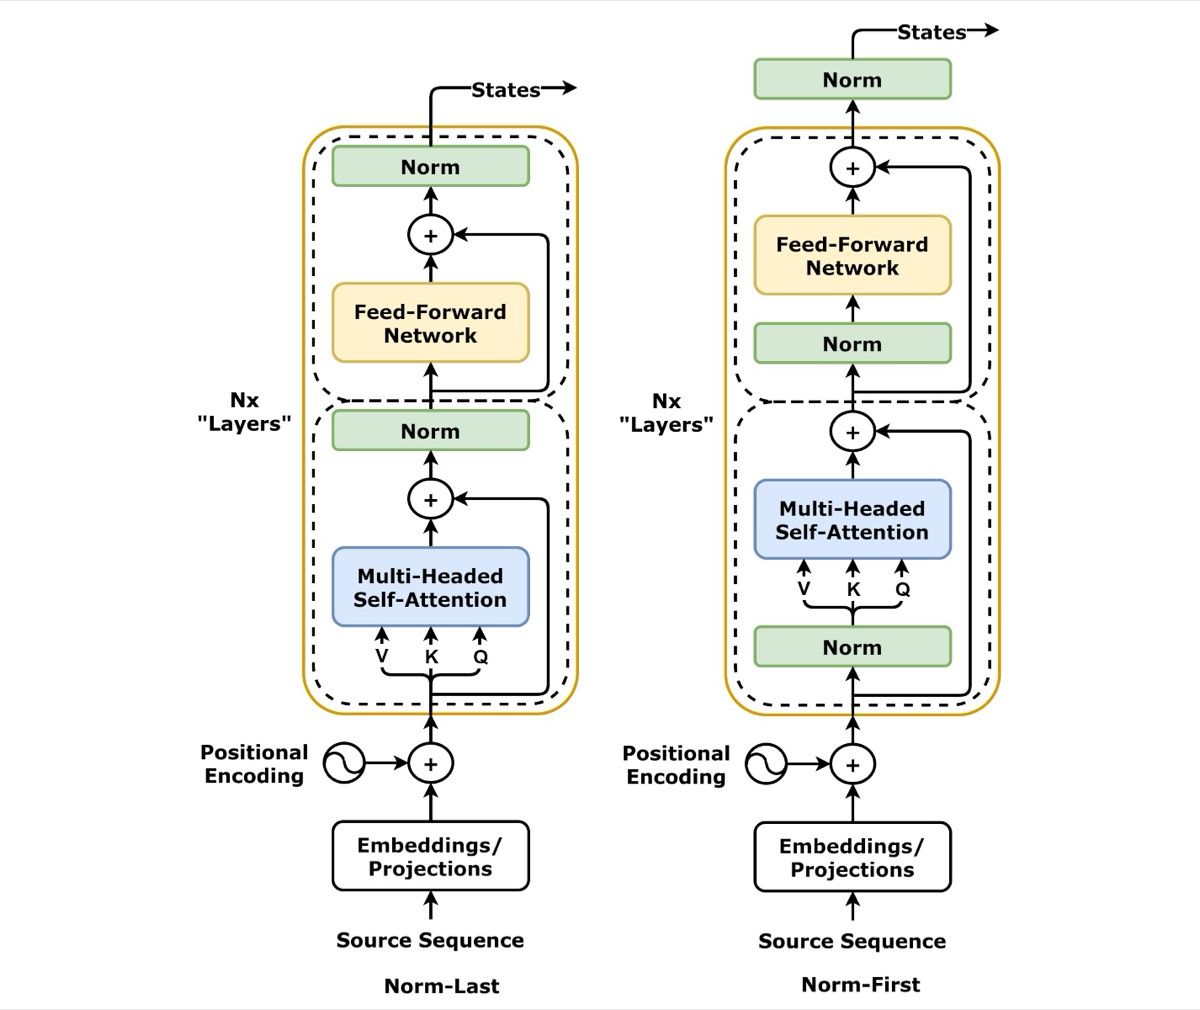
Gambar: Perbandingan penempatan normalisasi pada encoder Transformer, Norm-Last di kiri dan Norm-First di kanan — Sumber: Wikimedia Commons, oleh dvgodoy, CC BY 4.0.
class TransformerBlock(nn.Module):
    def __init__(self, dim=64, heads=4, pre_ln=True):
        super().__init__()
        self.pre_ln = pre_ln
        self.norm1 = nn.LayerNorm(dim)
        self.norm2 = nn.LayerNorm(dim)
        self.attn = nn.MultiheadAttention(dim, heads, batch_first=True)
        self.ff = nn.Sequential(
            nn.Linear(dim, 4 * dim),
            nn.GELU(),
            nn.Linear(4 * dim, dim),
        )

    def forward(self, x):
        if self.pre_ln:
            h = self.norm1(x)
            x = x + self.attn(h, h, h, need_weights=False)[0]
            x = x + self.ff(self.norm2(x))
        else:
            x = self.norm1(x + self.attn(x, x, x, need_weights=False)[0])
            x = self.norm2(x + self.ff(x))
        return x


for pre_ln in (True, False):
    torch.manual_seed(1)
    stack = nn.Sequential(*[TransformerBlock(pre_ln=pre_ln) for _ in range(6)])
    tokens = (torch.randn(2, 12, 64) * 6).requires_grad_(True)

    out = stack(tokens)
    out.pow(2).mean().backward()

    grad_first = stack[0].ff[0].weight.grad.norm().item()
    grad_last = stack[-1].ff[0].weight.grad.norm().item()

    label = "Pre-LN " if pre_ln else "Post-LN"
    print(f"{label} std output={out.std().item():.4f} "
          f"grad blok-1={grad_first:.3e} grad blok-6={grad_last:.3e}")
Output:
Pre-LN  std output=5.9956 grad blok-1=9.763e-01 grad blok-6=9.395e-01
Post-LN std output=1.0003 grad blok-1=4.725e-07 grad blok-6=1.624e-06
Eksperimen ini memakai input dengan standar deviasi enam untuk meniru embedding yang belum stabil. Pada Pre-LN, norma gradient di blok pertama dan blok terakhir berada di orde yang sama, yaitu sekitar 9.8e-01 dan 9.4e-01. Pada Post-LN, keduanya turun ke orde 1e-07. Normalisasi berulang di akhir setiap blok meredam sinyal gradient yang menjalar ke belakang, dan inilah alasan Post-LN membutuhkan learning rate warmup yang panjang.
Pre-LN menjaga residual stream tetap apa adanya. Normalisasi hanya diterapkan pada cabang attention dan feed-forward, sehingga jalur gradient dari loss menuju layer awal tidak melewati banyak operasi penskalaan. Konsekuensinya, output akhir blok terakhir perlu dinormalisasi sekali lagi sebelum masuk ke classification head.
Praktik Terbaik Memilih Epsilon dan Varian Normalisasi
Nilai default eps=1e-5 bekerja untuk sebagian besar kasus training presisi 32-bit. Ketika memakai mixed precision, variance pada float16 bisa kehilangan presisi di sekitar nilai kecil, sehingga eps di kisaran 1e-3 sampai 1e-6 perlu diuji. Menjalankan layer normalization di dalam blok torch.autocast dengan dtype float32 adalah pilihan yang lebih aman.
Parameter elementwise_affine=False menghapus weight dan bias. Pilihan ini menghemat parameter dan terkadang berguna pada model sangat besar, tetapi kita kehilangan kemampuan memulihkan skala representasi. Untuk model yang lebih kecil, biarkan affine tetap aktif.
RMSNorm membuang perhitungan mean dan hanya membagi dengan root mean square. Hasilnya lebih murah secara komputasi dan banyak dipakai pada model bahasa modern, dengan perilaku yang cukup dekat pada layer normalization. Jika arsitektur sudah memakai RMSNorm, menambahkan LayerNorm di tempat yang sama hanya menggandakan normalisasi tanpa manfaat.
Tiga kesalahan yang sering muncul: menerapkan normalisasi pada sumbu batch padahal maksudnya per sampel, menormalkan output sebelum residual connection pada Pre-LN sehingga jalur residual ikut teredam, dan menganggap normalisasi dapat menggantikan inisialisasi bobot yang baik. Normalisasi menstabilkan skala, bukan menggantikan disiplin inisialisasi dan pemilihan learning rate.
Layer Normalization adalah komponen kecil dengan dampak besar pada stabilitas training. Di bootcamp Deep Learning Rumah Coding, kita membedah alur training dari implementasi layer, pengukuran gradient, sampai evaluasi model secara terstruktur agar setiap keputusan arsitektur punya dasar eksperimen.
Kursus Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.