Memahami Memoization dan Caching di Python: Implementasi functools.lru_cache dan cachetools
Fungsi yang dipanggil berulang dengan argumen yang sama tetap menjalankan seluruh komputasi dari awal. Pada fungsi rekursif, pengulangan ini tumbuh secara eksponensial dan menghabiskan waktu CPU untuk subproblem yang sebenarnya sudah pernah diselesaikan. _Memoization_ menyimpan hasil fungsi berdasarkan argumennya, sedangkan caching menyimpan hasil pada layer yang lebih luas seperti query database atau response HTTP. Keduanya berbagi prinsip yang sama: hindari pekerjaan yang sudah pernah dilakukan.
Mengenali Biaya Komputasi Berulang pada Fungsi Python
Perhatikan implementasi fibonacci rekursif tanpa penyimpanan hasil. Setiap pemanggilan fibonacci(n) memecah masalah menjadi dua cabang yang saling tumpang tindih. Cabang-cabang ini menghitung ulang nilai yang sama berkali-kali, sehingga jumlah pemanggilan fungsi membengkak jauh melampaui jumlah nilai unik yang dibutuhkan.
Kita dapat membuktikan pemborosan tersebut dengan penghitung sederhana dan pengukuran waktu menggunakan time.perf_counter.
import time

call_count = 0

def fibonacci(n):
    global call_count
    call_count += 1
    if n < 2:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

start = time.perf_counter()
result = fibonacci(30)
elapsed = time.perf_counter() - start

print(f"fibonacci(30) = {result}")
print(f"jumlah pemanggilan fungsi: {call_count:,}")
print(f"durasi eksekusi: {elapsed:.4f} detik")
Output:
fibonacci(30) = 832040
jumlah pemanggilan fungsi: 2,692,537
durasi eksekusi: 0.2733 detik
Untuk n=30, fungsi ini dipanggil lebih dari satu juta kali padahal hanya ada 31 nilai unik yang perlu dihitung. Angka ini menjelaskan mengapa pendekatan naif tidak layak dipakai pada input yang lebih besar. Output di atas menjadi baseline sebelum optimasi diterapkan.
Cara Kerja functools.lru_cache dan Informasi Cache yang Disediakan
functools.lru_cache membungkus fungsi dan menyimpan hasil berdasarkan hash dari argumen. Saat fungsi dipanggil dengan argumen yang sudah pernah masuk cache, Python mengembalikan nilai tersimpan tanpa mengeksekusi body fungsi. Parameter maxsize menentukan batas jumlah entri, dan saat batas tercapai, entri yang paling lama tidak digunakan akan dibuang sesuai kebijakan _Least Recently Used_.
Nilai maxsize=None membuat cache tanpa batas. Pilihan ini cepat tetapi berisiko menghabiskan memori pada fungsi dengan variasi argumen yang besar. Setelah dekorator aktif, kita dapat membaca statistik melalui cache_info() untuk melihat jumlah hits, misses, dan ukuran cache saat ini.
from functools import lru_cache
import time

@lru_cache(maxsize=128)
def fibonacci_cached(n):
    if n < 2:
        return n
    return fibonacci_cached(n - 1) + fibonacci_cached(n - 2)

start = time.perf_counter()
result = fibonacci_cached(30)
elapsed = time.perf_counter() - start

print(f"fibonacci_cached(30) = {result}")
print(f"durasi eksekusi: {elapsed:.6f} detik")
print(f"cache_info: {fibonacci_cached.cache_info()}")
Output:
fibonacci_cached(30) = 832040
durasi eksekusi: 0.000006 detik
cache_info: CacheInfo(hits=28, misses=31, maxsize=128, currsize=31)
Hasilnya memperlihatkan lompatan performa yang besar. Setiap nilai fibonacci hanya dihitung satu kali, lalu permintaan berikutnya dilayani dari dictionary internal cache. Perhatikan bahwa misses hanya bertambah 31 kali, sejumlah nilai unik yang benar-benar dibutuhkan.
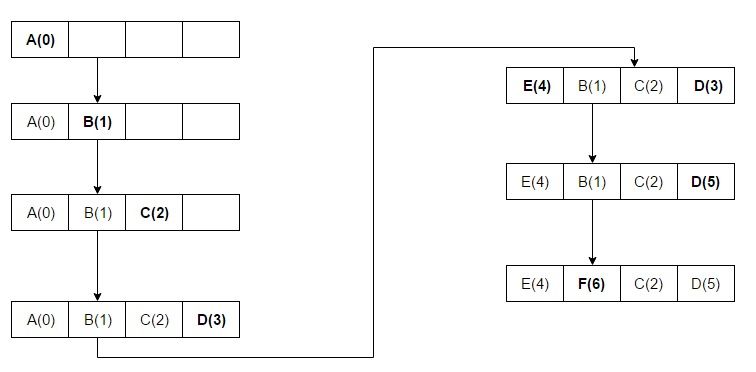
Gambar: Urutan eviction pada LRU cache ketika kapasitas penuh — Sumber: Wikimedia Commons
Menerapkan cachetools untuk TTL dan Kebijakan Eviction Lain
Java Fundamental
A hands-on, project-based introduction to Java programming designed for complete...
lru_cache tidak memiliki konsep kedaluwarsa berbasis waktu. Ketika sumber data berubah, hasil lama tetap tersimpan sampai kita membersihkannya secara manual. Library cachetools menutup celah ini dengan menyediakan TTLCache, LRUCache, dan LFUCache yang dapat dikombinasikan dengan dekorator cached.
TTLCache menyimpan entri selama durasi tertentu. Setelah ttl detik berlalu, entri dianggap kedaluwarsa dan permintaan berikutnya akan menghitung ulang nilai. Pola ini cocok untuk data yang berubah perlahan, seperti harga saham ringkas atau konfigurasi aplikasi.
!pip install cachetools
import time
from cachetools import TTLCache, cached

cache = TTLCache(maxsize=100, ttl=2)

@cached(cache=cache)
def ambil_harga(symbol):
    print(f"menghitung harga untuk {symbol}")
    return 15000

print(ambil_harga("BBCA"))
print(ambil_harga("BBCA"))
time.sleep(2.2)
print(ambil_harga("BBCA"))
print(f"jumlah entri cache: {len(cache)}")
Output:
menghitung harga untuk BBCA
15000
15000
menghitung harga untuk BBCA
15000
jumlah entri cache: 1
Pemanggilan kedua tidak mencetak pesan menghitung harga, tanda bahwa hasil diambil dari cache. Setelah time.sleep(2.2) melewati batas TTL, fungsi dieksekusi kembali dan mencetak pesan yang sama. Output ini memperlihatkan siklus hidup entri cache secara langsung.
Menangani Argumen yang Tidak Hashable dan Mutability
Cache berbasis dictionary memerlukan key yang hashable. Argumen bertipe list atau dict tidak memenuhi syarat ini, sehingga lru_cache melempar TypeError sebelum fungsi sempat berjalan. Kesalahan ini sering muncul ketika fungsi menerima koleksi data langsung dari pemanggil.
Solusinya adalah mengubah argumen menjadi representasi immutable seperti tuple, atau menyusun cache key eksplisit di fungsi pembungkus. Perlu diperhatikan juga bahwa objek mutable yang berubah setelah disimpan dapat menghasilkan hasil cache yang tidak sesuai. Konversi ke tuple memaksa pemanggil memberikan data yang stabil selama proses caching.
from functools import lru_cache

@lru_cache(maxsize=32)
def total_nilai(data):
    return sum(data)

try:
    print(total_nilai([1, 2, 3, 4]))
except TypeError as error:
    print(f"error: {error}")

@lru_cache(maxsize=32)
def total_nilai_aman(data):
    return sum(data)

print(total_nilai_aman((1, 2, 3, 4)))
print(total_nilai_aman((1, 2, 3, 4)))
print(total_nilai_aman.cache_info())
Output:
error: unhashable type: 'list'
10
10
CacheInfo(hits=1, misses=1, maxsize=32, currsize=1)
Pemanggilan pertama gagal karena list tidak dapat di-hash. Versi kedua bekerja normal karena menerima tuple. Statistik cache menunjukkan satu miss dan satu hit, bukti bahwa hasil kedua benar-benar diambil dari penyimpanan.
Mengukur Efektivitas Cache dengan Benchmark Sederhana
Cache tidak otomatis membuat aplikasi lebih cepat. Jika pola akses hampir selalu menghasilkan argumen baru, setiap panggilan tetap berakhir sebagai miss dan kita hanya menambah overhead lookup. Karena itu, ukur rasio hits / (hits + misses) pada pola akses yang menyerupai produksi, bukan pada satu panggilan tunggal.
Ukuran maxsize juga memengaruhi hasil. Cache yang terlalu kecil sering membuang entri sebelum sempat dipakai ulang, sedangkan cache yang terlalu besar menahan memori tanpa manfaat tambahan. Benchmark berikut menggunakan fungsi dengan komputasi buatan dan pola akses berulang untuk melihat perbedaannya.
from functools import lru_cache
import time

def hitung_skor(angka):
    total = 0
    for i in range(50_000):
        total += i % (angka + 1)
    return total

def jalankan_benchmark(maxsize):
    @lru_cache(maxsize=maxsize)
    def hitung_skor_cached(angka):
        return hitung_skor(angka)

    pola_akses = [i % 50 for i in range(300)]
    start = time.perf_counter()
    for nilai in pola_akses:
        hitung_skor_cached(nilai)
    elapsed = time.perf_counter() - start

    info = hitung_skor_cached.cache_info()
    hit_rate = info.hits / (info.hits + info.misses) * 100
    return elapsed, hit_rate, info

pola_akses = [i % 50 for i in range(300)]
start = time.perf_counter()
for nilai in pola_akses:
    hitung_skor(nilai)
baseline = time.perf_counter() - start
print(f"tanpa cache: {baseline:.4f} detik")

for ukuran in (10, 64):
    elapsed, hit_rate, info = jalankan_benchmark(ukuran)
    print(f"maxsize={ukuran}: {elapsed:.4f} detik, hit rate {hit_rate:.1f}%, {info}")
Output:
tanpa cache: 0.5803 detik
maxsize=10: 0.5824 detik, hit rate 0.0%, CacheInfo(hits=0, misses=300, maxsize=10, currsize=10)
maxsize=64: 0.0974 detik, hit rate 83.3%, CacheInfo(hits=250, misses=50, maxsize=64, currsize=50)
Hasil benchmark memperlihatkan dua kondisi yang berbeda. Dengan maxsize=10, pola akses sekuensial membuang setiap entri sebelum sempat dipakai ulang, sehingga hit rate berada di 0% dan waktu eksekusi setara tanpa cache. Setelah ukuran dinaikkan menjadi maxsize=64, seluruh 50 nilai muat di cache dan hit rate melonjak ke 83.3% dengan waktu eksekusi yang jauh lebih singkat. Angka ini menjadi dasar untuk menentukan ukuran cache berdasarkan jumlah nilai unik pada pola akses nyata.
Praktik Aman untuk Invalidasi Cache dan Penggunaan Memori
Invalidasi adalah bagian yang paling sering terlewat. Setelah data sumber berubah, panggil cache_clear() pada fungsi yang terdampak, atau gunakan TTLCache agar entri kedaluwarsa secara otomatis. Untuk endpoint yang bergantung pada banyak sumber, dokumentasikan kapan cache harus dibersihkan agar perilaku aplikasi tetap dapat diprediksi.
Hindari maxsize=None pada fungsi yang menerima ID unik dalam jumlah besar. Setiap ID baru menambah entri permanen, dan memori akan terus tumbuh selama proses berjalan. Pada layanan dengan banyak worker, cache in-memory juga tidak dibagi antar proses, sehingga setiap worker menyimpan salinan sendiri.
Untuk skala produksi, pertimbangkan cache eksternal seperti Redis yang dapat diakses bersama oleh beberapa instance. Selain itu, lindungi pemanggilan fungsi mahal dengan mekanisme _single-flight_ agar lonjakan permintaan bersamaan tidak memicu banyak komputasi identik atau _cache stampede_.
Tetapkan batas waktu dan ukuran cache secara eksplisit. Nilai default yang terlalu longgar membuat perilaku cache sulit diprediksi saat trafik berubah. Pantau cache_info() atau metrik hit rate dari Redis secara berkala, lalu bandingkan dengan latensi endpoint. Ketika hit rate turun drastis, periksa apakah bentuk cache key berubah akibat parameter baru.
Untuk fungsi murni tanpa argumen mutable, functools.cache pada Python 3.9 ke atas menjadi pilihan paling ringkas karena setara dengan lru_cache(maxsize=None). Keputusan akhir tetap bergantung pada pola akses. Cache yang tidak pernah dipantau hanya memindahkan beban dari CPU ke memori tanpa jaminan perbaikan.
Memoization dan caching adalah optimasi yang murah diterapkan, tetapi tetap memerlukan pengukuran dan strategi invalidasi yang jelas. Jika Anda ingin memperdalam pola optimasi Python seperti profiling, concurrency, dan desain layanan yang siap produksi, Rumah Coding menyediakan kelas dan bootcamp yang membahas praktik tersebut secara langsung.
Kursus Terkait
Java Fundamental
A hands-on, project-based introduction to Java programming designed for complete beginners. Instead of merely memorizing syntax, you will learn to code by building real-world applications from day one. By the end of this course, you will master core programming logic, data structures, object-oriented principles, and debugging techniques, culminating in the development of a fully functional command-line system.
JavaCine: Terminal-Based Movie Ticketing System
- Object-Oriented Movie Catalog: Utilizes a Movie class to encapsulate details like title, genre, duration, and ticket price. The system displays a dynamic list of currently showing films.
- Dynamic Seat Visualization (2D Arrays): Uses a 2D Array to generate a visual seating grid (e.g., 5x5) in the terminal. Available seats are marked as [ O ] and booked seats are marked as [ X ].
- Interactive Booking Engine: A loop-driven menu that allows users to select a movie, choose a specific seat by row and column, and validates the choice. It prevents double-booking if a seat is already taken.
Python Fundamentals
Master the fundamentals of Python through hands-on, real-world projects. Designed for absolute beginners, this course takes you from writing your first line of code to building a fully functional application. By the end of this course, you will have a solid grasp of core programming concepts, data structures, and file management, laying a strong foundation for future studies in Data Science, Web Development, or Automation.
Personal Finance Tracker & Analyzer (CLI)
- Interactive Main Menu: A continuous loop menu allowing users to choose between adding records, viewing summaries, or exiting the app.
- Transaction Logging: Users can input transaction types (Income/Expense), amounts, categories (e.g., Food, Salary, Transport), and descriptions.
- Robust Input Validation: Utilizes try-except blocks to prevent the program from crashing if a user accidentally types letters instead of numbers for financial amounts.