Teori dan Implementasi Arsitektur U-Net dengan PyTorch untuk Image Segmentation
Bentuk U dan Peran Setiap Bagian Arsitektur U-Net
Segmentasi gambar menghasilkan prediksi untuk setiap piksel, bukan satu label untuk seluruh gambar. Pada kasus biner, output model berukuran sama dengan input dengan dua channel: objek dan latar. Arsitektur U-Net menyusun dua jalur simetris. Contracting path menurunkan resolusi spasial sambil menaikkan jumlah channel, sedangkan expansive path mengembalikan resolusi hingga ke ukuran asli. Nama U-Net berasal dari bentuk alur tensor pada diagram arsitektur.
Jalur turun berfungsi mengekstrak konteks. Setiap level menangkap pola dengan receptive field yang makin lebar. Informasi semantik seperti area objek tersedia di bottleneck, tetapi detail batas objek sudah hilang akibat pooling berulang.
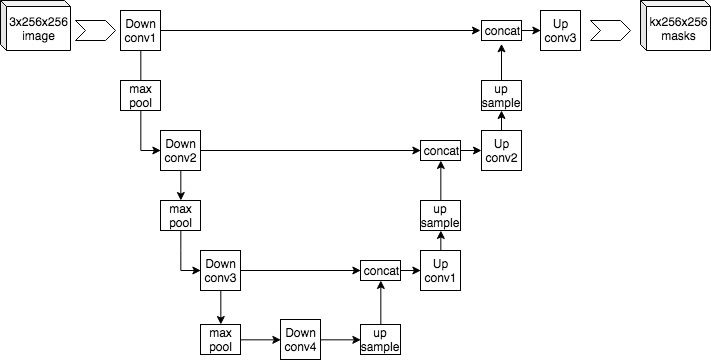
Gambar: Diagram arsitektur U-Net dengan contracting path, bottleneck, dan expansive path — Sumber: Wikimedia Commons
Koneksi skip menyelesaikan masalah tersebut. Feature map dari encoder dikirim langsung ke decoder pada level resolusi yang sama. Decoder menerima dua sumber: hasil upsampling yang kaya konteks dan detail spasial dari encoder. Kombinasi ini membuat U-Net akurat pada objek kecil dengan batas tipis, misalnya pembuluh darah pada citra retina.
Layer terakhir adalah konvolusi 1x1 yang memetakan setiap vektor fitur ke jumlah kelas. Untuk satu objek dan satu latar, gunakan dua channel dengan CrossEntropyLoss. Untuk beberapa kelas yang saling eksklusif, tambahkan softmax. Beberapa objek yang dapat tumpang tindih lebih tepat memakai sigmoid per channel.
U-Net populer pada dataset medis yang berukuran kecil. Arsitektur ini memanfaatkan augmentasi masif dan fitur multi-skala, sehingga tidak menuntut jutaan citra berlabel. Evaluasi tetap memakai split pasien yang berbeda agar model tidak menghafal pola dari citra yang sama.
Membangun Contracting Path dengan Blok Konvolusi Ganda
Setiap level encoder dibangun dari blok konvolusi ganda. Dua operasi Conv2d berukuran 3x3 dengan padding=1 menjaga resolusi spasial tetap sama. BatchNorm2d menstabilkan distribusi aktivasi, lalu ReLU menambahkan non-linearitas. Pola ini diulang sebelum lapisan pooling menurunkan resolusi.
MaxPool2d(2) membagi dua ukuran spasial dan menggandakan jumlah channel pada blok berikutnya. Feature map sebelum pooling disimpan karena akan dipakai decoder. Penyimpanan ini bukan optimasi tambahan, melainkan bagian inti arsitektur yang menentukan kualitas batas objek.
Kode berikut mendefinisikan dua kelas dasar dan mencetak bentuk tensor pada setiap level. Kita memakai input 256x256 dengan satu channel untuk menyimulasikan citra grayscale.
!pip install torch numpy

import torch
import torch.nn as nn


class DoubleConv(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.block = nn.Sequential(
            nn.Conv2d(in_channels, out_channels, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1, bias=False),
            nn.BatchNorm2d(out_channels),
            nn.ReLU(inplace=True),
        )

    def forward(self, x):
        return self.block(x)


class ContractingBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        self.conv = DoubleConv(in_channels, out_channels)
        self.pool = nn.MaxPool2d(kernel_size=2)

    def forward(self, x):
        features = self.conv(x)
        return features, self.pool(features)


x = torch.randn(1, 1, 256, 256)
for in_ch, out_ch in [(1, 64), (64, 128), (128, 256), (256, 512)]:
    features, pooled = ContractingBlock(in_ch, out_ch)(x)
    print(f"{in_ch}->{out_ch}: features {tuple(features.shape)} | pooled {tuple(pooled.shape)}")
    x = pooled
Output:
1->64: features (1, 64, 256, 256) | pooled (1, 64, 128, 128)
64->128: features (1, 128, 128, 128) | pooled (1, 128, 64, 64)
128->256: features (1, 256, 64, 64) | pooled (1, 256, 32, 32)
256->512: features (1, 512, 32, 32) | pooled (1, 512, 16, 16)
Output program menunjukkan resolusi menyusut dari 256 ke 32, sementara channel naik dari 64 ke 512. Angka ini menjadi acuan saat menyusun decoder. Jika dimensi input tidak habis dibagi 16, proses konkatenasi pada tahap berikutnya akan gagal.
Menyambungkan Skip Connection ke Expansive Path
Decoder memakai ConvTranspose2d dengan stride=2 untuk menggandakan resolusi. Hasilnya dikonkatenasi dengan feature map encoder yang disimpan sebelumnya. Operasi torch.cat berjalan pada dimensi channel, sehingga jumlah channel setelah konkatenasi menjadi dua kali lipat.
Setelah konkatenasi, blok konvolusi ganda memadukan dua jenis informasi. Konteks semantik dari jalur bawah bertemu dengan detail tepi dari jalur atas. Tanpa langkah ini, model cenderung menghasilkan mask yang halus tetapi meleset pada objek berukuran kecil.
Layer output Conv2d 1x1 memetakan 64 channel menjadi jumlah kelas. Untuk input 1x256x256 dan dua kelas, bentuk output adalah (1, 2, 256, 256). Jumlah channel output harus sama dengan jumlah kelas, bukan jumlah objek.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Ketika ukuran feature map encoder dan hasil upsampling tidak identik, lakukan crop pada bagian tengah sebelum konkatenasi. Selisih muncul karena pembulatan saat pooling pada resolusi ganjil.
class UNet(nn.Module):
    def __init__(self, in_channels=1, num_classes=2):
        super().__init__()
        self.enc1 = DoubleConv(in_channels, 64)
        self.enc2 = DoubleConv(64, 128)
        self.enc3 = DoubleConv(128, 256)
        self.enc4 = DoubleConv(256, 512)
        self.pool = nn.MaxPool2d(2)
        self.bottleneck = DoubleConv(512, 1024)
        self.up4 = nn.ConvTranspose2d(1024, 512, kernel_size=2, stride=2)
        self.dec4 = DoubleConv(1024, 512)
        self.up3 = nn.ConvTranspose2d(512, 256, kernel_size=2, stride=2)
        self.dec3 = DoubleConv(512, 256)
        self.up2 = nn.ConvTranspose2d(256, 128, kernel_size=2, stride=2)
        self.dec2 = DoubleConv(256, 128)
        self.up1 = nn.ConvTranspose2d(128, 64, kernel_size=2, stride=2)
        self.dec1 = DoubleConv(128, 64)
        self.head = nn.Conv2d(64, num_classes, kernel_size=1)

    def forward(self, x):
        c1 = self.enc1(x)
        c2 = self.enc2(self.pool(c1))
        c3 = self.enc3(self.pool(c2))
        c4 = self.enc4(self.pool(c3))
        b = self.bottleneck(self.pool(c4))
        d4 = self.dec4(torch.cat([self.up4(b), c4], dim=1))
        d3 = self.dec3(torch.cat([self.up3(d4), c3], dim=1))
        d2 = self.dec2(torch.cat([self.up2(d3), c2], dim=1))
        d1 = self.dec1(torch.cat([self.up1(d2), c1], dim=1))
        return self.head(d1)


model = UNet(in_channels=1, num_classes=2)
sample = torch.randn(1, 1, 256, 256)
print("output:", tuple(model(sample).shape))
print("parameters:", sum(p.numel() for p in model.parameters()))
Output:
output: (1, 2, 256, 256)
parameters: 31036546
Model ini memiliki sekitar 31 juta parameter, dan sebagian besar berada pada bottleneck. Jika memori terbatas, turunkan channel dasar dari 64 ke 32 lalu sesuaikan semua level. Rasio penggandaan channel tetap sama agar arsitektur konsisten.
Menyiapkan Dataset Segmentasi dan Memilih Loss yang Tepat
Mask disimpan sebagai tensor integer dengan nilai 0 dan 1. CrossEntropyLoss menerima logit berukuran (batch, kelas, H, W) dan target berukuran (batch, H, W) bertipe long. Normalisasi citra ke rentang 0 sampai 1 membantu konvergensi pada input grayscale.
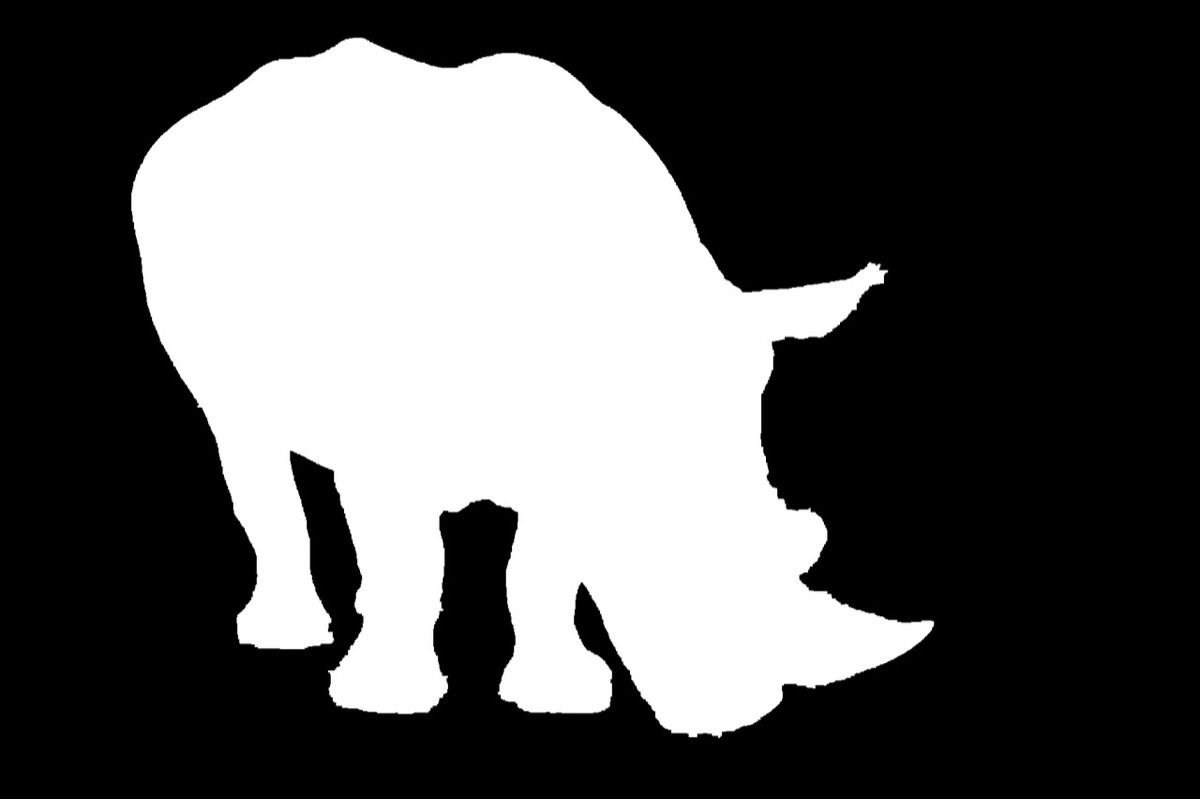
Gambar: Contoh mask segmentasi biner dengan objek berwarna putih dan latar hitam — Sumber: Wikimedia Commons
Masalah utama segmentasi adalah ketidakseimbangan kelas. Piksel latar biasanya mendominasi, sehingga model dapat mencapai akurasi tinggi dengan memprediksi latar seluruhnya. Loss yang hanya menghitung rata-rata per piksel tidak menghukum kesalahan ini dengan cukup.
Dice loss mengukur tumpang tindih antara prediksi dan target. Kombinasi CrossEntropyLoss dan DiceLoss memberi sinyal gradien yang lebih seimbang untuk objek kecil. Bobot yang sama untuk kedua loss adalah titik awal yang aman.
Augmentasi menggantikan kebutuhan dataset besar. Flip horizontal, rotasi kecil, dan perubahan kecerahan diterapkan pada citra dan mask secara bersamaan. Mask memakai interpolasi nearest agar nilai label tidak berubah menjadi kelas yang tidak valid.
import numpy as np
from torch.utils.data import Dataset, DataLoader


class SegmentationDataset(Dataset):
    def __init__(self, images, masks):
        self.images = images
        self.masks = masks

    def __len__(self):
        return len(self.images)

    def __getitem__(self, index):
        image = torch.as_tensor(self.images[index], dtype=torch.float32).unsqueeze(0) / 255.0
        mask = torch.as_tensor(self.masks[index], dtype=torch.long)
        return image, mask


class DiceLoss(nn.Module):
    def __init__(self, smooth=1.0):
        super().__init__()
        self.smooth = smooth

    def forward(self, logits, target):
        probs = torch.softmax(logits, dim=1)[:, 1]
        target = target.float()
        intersection = (probs * target).sum()
        return 1 - (2 * intersection + self.smooth) / (probs.sum() + target.sum() + self.smooth)


images = np.random.randint(0, 256, size=(4, 64, 64))
masks = np.random.randint(0, 2, size=(4, 64, 64))
loader = DataLoader(SegmentationDataset(images, masks), batch_size=2, shuffle=True)
batch_images, batch_masks = next(iter(loader))
print("input:", tuple(batch_images.shape), "| target:", tuple(batch_masks.shape), "| dtype:", batch_masks.dtype)
print("dice loss:", round(DiceLoss()(torch.randn(2, 2, 64, 64), batch_masks).item(), 4))
Output:
input: (2, 1, 64, 64) | target: (2, 64, 64) | dtype: torch.int64
dice loss: 0.4985
Pada contoh di atas, kita memakai data acak agar fokus pada alur, bukan pada isi dataset. Pada proyek nyata, ganti array acak dengan pembacaan file citra dan mask. Pastikan pasangan citra-mask tetap sinkron setelah augmentasi.
Melatih Model dan Mengukur Kualitas Mask dengan IoU
Loop training mengikuti pola standar: forward pass, hitung loss, backward pass, lalu perbarui bobot. optimizer.zero_grad() dipanggil sebelum backward() untuk mencegah akumulasi gradien dari iterasi sebelumnya. Learning rate 1e-3 dengan Adam adalah titik awal yang stabil untuk U-Net kecil.
ReduceLROnPlateau menurunkan learning rate ketika loss tidak membaik. Scheduler ini membantu model keluar dari plateau tanpa mengubah arsitektur. Nilai patience=2 berarti penurunan dilakukan setelah dua epoch tanpa perbaikan.
Intersection over Union mengukur kualitas mask dengan membandingkan area irisan dan area gabungan per kelas. Nilai IoU 0.8 pada kelas objek menunjukkan tumpang tindih yang baik. Metrik ini lebih informatif daripada akurasi piksel pada data yang tidak seimbang.
Tanda overfitting muncul ketika loss training terus turun sementara loss validasi berhenti membaik. Hentikan training lebih awal atau tambahkan augmentasi saat pola ini terlihat. Perubahan learning rate saja tidak cukup untuk memperbaikinya.
Untuk inferensi, logit diubah menjadi mask melalui argmax pada dimensi channel. Simpan checkpoint dengan state_dict agar bobot dapat dimuat ulang tanpa mendefinisikan ulang kelas model.
import torch.optim as optim


def compute_iou(pred_mask, target_mask, num_classes=2):
    scores = []
    for cls in range(num_classes):
        pred = pred_mask == cls
        target = target_mask == cls
        union = (pred | target).sum().float()
        if union > 0:
            scores.append(((pred & target).sum().float() / union).item())
    return sum(scores) / len(scores)


train_model = UNet(in_channels=1, num_classes=2)
optimizer = optim.Adam(train_model.parameters(), lr=1e-3)
criterion = nn.CrossEntropyLoss()
scheduler = optim.lr_scheduler.ReduceLROnPlateau(optimizer, patience=2)

for epoch in range(2):
    train_model.train()
    optimizer.zero_grad()
    logits = train_model(batch_images)
    loss = criterion(logits, batch_masks) + 0.5 * DiceLoss()(logits, batch_masks)
    loss.backward()
    optimizer.step()

    train_model.eval()
    with torch.no_grad():
        preds = train_model(batch_images).argmax(dim=1)
    iou = compute_iou(preds, batch_masks)
    scheduler.step(loss.item())
    print(f"epoch {epoch + 1}: loss={loss.item():.4f} iou={iou:.4f}")
Output:
epoch 1: loss=0.9980 iou=0.2535
epoch 2: loss=0.8465 iou=0.2535
Log output memperlihatkan loss dan IoU pada dua epoch pertama. Pada data acak, nilai IoU masih rendah karena tidak ada pola yang dapat dipelajari. Arah kurva menjadi indikator utama di sini. Pada dataset nyata, loss harus turun dan IoU harus naik secara konsisten antar epoch.
Praktik Produksi untuk Model Segmentasi
Beberapa praktik mencegah kegagalan saat model dipindahkan ke produksi. Simpan checkpoint dengan torch.save(model.state_dict(), path) dan muat dengan load_state_dict. Perubahan kecil pada definisi kelas tidak akan merusak file bobot.
Resolusi input harus kelipatan 16 karena empat kali pooling. Untuk gambar berukuran bebas, lakukan resize ke kelipatan terdekat sebelum inferensi. Setelah prediksi, kembalikan mask ke ukuran asli dengan interpolasi nearest agar batas kelas tetap tegas.
Evaluasi visual tetap diperlukan. Overlay mask berwarna pada citra asli memperlihatkan apakah model salah menangkap bayangan atau artefak. Metrik tinggi tidak menjamin hasil yang berguna pada kasus tepi.
U-Net klasik memiliki batas pada objek dengan variasi skala ekstrem. Varian seperti U-Net++ menambahkan koneksi bertingkat, sedangkan Attention U-Net memberi bobot pada area relevan. Kedua varian tetap memakai prinsip encoder-decoder dengan skip connection yang sama.
Model segmentasi yang baik lahir dari pemahaman arsitektur, bukan hanya pemanggilan library. Jika Anda ingin membangun pipeline computer vision dari dasar sampai deployment, program Deep Learning Rumah Coding membahas PyTorch, CNN, dan segmentasi secara terstruktur.
Kursus Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.