Implementasi RFM Analysis untuk Segmentasi Pelanggan E-Commerce dengan Pandas dan Matplotlib
Memahami Metrik Recency Frequency dan Monetary pada Data Transaksi
RFM Analysis mengukur tiga perilaku pelanggan dari data transaksi. Recency mencatat jarak hari antara tanggal snapshot dan transaksi terakhir setiap pelanggan. Frequency menghitung jumlah invoice unik yang pernah dibuat pelanggan. Monetary menjumlahkan total nilai belanja pelanggan selama periode observasi.
Ketiga metrik ini saling melengkapi. Recency menangkap momentum belanja terkini. Frequency menangkap kebiasaan belanja berulang. Monetary menangkap kontribusi revenue pelanggan. Kombinasi ketiganya memberi gambaran segmentasi yang cukup akurat tanpa model machine learning yang kompleks.
Data transaksi e-commerce umumnya memuat kolom InvoiceNo, CustomerID, InvoiceDate, Quantity, dan UnitPrice. Kolom turunan TotalPrice dihitung dari Quantity dikali UnitPrice. Tabel RFM akhir memiliki satu baris per pelanggan dengan tiga kolom numerik tersebut. Format ini menjadi input untuk scoring dan visualisasi pada tahap berikutnya. Keunggulan utama RFM adalah interpretabilitas hasil. Setiap angka skor dapat dijelaskan langsung ke stakeholder non-teknis. Tim marketing dapat memahami alasan seorang pelanggan masuk segmen Champions tanpa penjelasan model yang rumit. Contoh konkret membantu intuisi. Pelanggan dengan Recency 12 hari, Frequency 8 transaksi, dan Monetary 3,6 juta rupiah jelas lebih aktif. Bandingkan dengan pelanggan ber-Recency 200 hari yang hanya memiliki satu transaksi. Pemilihan tanggal snapshot memengaruhi nilai Recency secara langsung. Praktik standar memakai satu hari setelah transaksi terakhir agar pelanggan paling aktif mendapat Recency satu hari.
Menyiapkan Dataset Transaksi dan Menghitung Nilai RFM dengan Pandas
We mulai dengan memuat dataset dan membersihkan baris yang tidak valid. Baris tanpa CustomerID harus dibuang karena tidak dapat dipetakan ke pelanggan. Transaksi return (quantity negatif) juga perlu dibuang agar nilai Monetary tidak terdistorsi. Kolom tanggal perlu di-parse ke tipe datetime agar selisih hari dapat dihitung.
Langkah berikutnya adalah menentukan tanggal snapshot. Praktik umum memakai satu hari setelah tanggal transaksi maksimum. Pendekatan ini membuat nilai Recency minimum bernilai satu hari. Agregasi per pelanggan memakai groupby pada CustomerID dengan tiga fungsi berbeda.
Gambar: Transaksi pembayaran pelanggan menjadi bahan mentah perhitungan Recency, Frequency, dan Monetary — Foto oleh Clay Banks, Sumber: Unsplash
import pandas as pd
import numpy as np

df = pd.read_csv("online_retail.csv", parse_dates=["InvoiceDate"])
df = df.dropna(subset=["CustomerID"])
df = df[df["Quantity"] > 0].copy()
df["TotalPrice"] = df["Quantity"] * df["UnitPrice"]

snapshot_date = df["InvoiceDate"].max() + pd.Timedelta(days=1)

rfm = df.groupby("CustomerID").agg(
    Recency=("InvoiceDate", lambda x: (snapshot_date - x.max()).days),
    Frequency=("InvoiceNo", "nunique"),
    Monetary=("TotalPrice", "sum"),
).reset_index()

print(rfm.head())
print(rfm.describe())
Output: _(dijalankan pada dataset sintetis 300 pelanggan dengan skema identik)_
  CustomerID  Recency  Frequency  Monetary
0      C1000       26          8   3640.23
1      C1001       12          5   2161.94
2      C1002       21          3    685.17
3      C1003      131          7   4787.79
4      C1004       20          8   4791.19
          Recency   Frequency     Monetary
count  297.000000  297.000000   297.000000
mean    48.525253    5.047138  2516.160774
std     44.118240    2.367674  1475.202544
min      1.000000    1.000000    62.800000
25%     15.000000    3.000000  1341.990000
50%     35.000000    5.000000  2369.470000
75%     70.000000    7.000000  3435.470000
max    233.000000   13.000000  6886.230000
Blok kode di atas menghasilkan tabel RFM dengan satu baris per pelanggan. Workflow ini memakai satu operasi groupby dengan tiga agregasi berbeda. Output yang diharapkan adalah tabel lima baris pertama plus ringkasan statistik. Perhatikan distribusi Monetary yang biasanya miring ke kanan. Kondisi skew ini wajar pada data e-commerce karena sebagian kecil pelanggan menyumbang revenue besar. Edge case perlu mendapat perhatian khusus. Pelanggan dengan satu transaksi akan memiliki Frequency satu dan Monetary sama dengan nilai invoice tersebut. Baris return dengan quantity negatif wajib dibuang sejak awal. Satu baris return dapat membuat Monetary negatif dan merusak pembagian kuantil pada tahap scoring.
Memberi Skor Kuantil dan Memetakan Segmen Pelanggan
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Skor kuantil mengubah nilai kontinu menjadi peringkat 1 sampai 4. Fungsi qcut membagi pelanggan ke empat kelompok berukuran seimbang. Recency memakai label terbalik karena nilai kecil berarti perilaku baik. Frequency dan Monetary memakai label menaik karena nilai besar berarti perilaku baik.
Gabungan tiga skor membentuk kode seperti 444 atau 111. Kode ini kemudian dipetakan ke nama segmen bisnis. Pola 444 berarti pelanggan baru, sering belanja, dan bernilai tinggi. Pola 111 berarti pelanggan lama tidak aktif dengan nilai rendah. Pemetaan regex menyederhanakan ratusan kombinasi kode menjadi delapan segmen yang mudah dikomunikasikan.
rfm["R_Score"] = pd.qcut(rfm["Recency"], 4, labels=[4, 3, 2, 1])
rfm["F_Score"] = pd.qcut(rfm["Frequency"].rank(method="first"), 4, labels=[1, 2, 3, 4])
rfm["M_Score"] = pd.qcut(rfm["Monetary"], 4, labels=[1, 2, 3, 4])
rfm["RFM_Score"] = (
    rfm["R_Score"].astype(str) + rfm["F_Score"].astype(str) + rfm["M_Score"].astype(str)
)

segment_map = {
    r"[4-4][4-4][4-4]": "Champions",
    r"[3-4][3-4][1-4]": "Loyal Customers",
    r"[4-4][1-1][1-4]": "New Customers",
    r"[3-4][1-3][1-3]": "Potential Loyalists",
    r"[2-3][1-2][1-2]": "At Risk",
    r"[1-2][2-4][2-4]": "Cannot Lose Them",
    r"[1-2][1-2][1-2]": "Hibernating",
    r"[1-1][1-1][1-1]": "Lost",
}

rfm["Segment"] = rfm["RFM_Score"].replace(segment_map, regex=True)
rfm["Segment"] = rfm["Segment"].where(rfm["Segment"].isin(segment_map.values()), "Others")
print(rfm["Segment"].value_counts())
Output:
Loyal Customers        79
Cannot Lose Them       63
Hibernating            43
Potential Loyalists    42
At Risk                33
Champions              22
Others                 10
New Customers           5
Logika pada blok ini berfokus pada dua tahap. Tahap pertama memberi skor kuantil per dimensi. Tahap kedua memetakan kode gabungan ke segmen bisnis. Perhatikan penggunaan rank(method="first") pada Frequency untuk menangani nilai kembar yang sering menggagalkan qcut. Output yang diharapkan adalah distribusi jumlah pelanggan per segmen. Baris tambahan dengan where menampung kombinasi kode yang tidak tercakup pola regex ke segmen Others. Jumlah Others yang kecil menandakan pemetaan segmen sudah mencakup mayoritas pola. Distribusi ini menjadi dasar prioritas strategi retensi.
Memvisualisasikan Distribusi Segmen untuk Keputusan Bisnis
Visualisasi mengubah tabel segmen menjadi insight yang dapat dipresentasikan ke tim bisnis. Bar chart menunjukkan ukuran setiap segmen secara sekilas. Boxplot Monetary per segmen menunjukkan segmen mana yang menyumbang revenue terbesar. Kedua grafik ini menjawab dua pertanyaan berbeda dengan satu dataset yang sama.
We membuat dua figure terpisah agar setiap grafik memiliki pesan tunggal. Figure pertama mengurutkan segmen dari terbesar ke terkecil. Figure kedua membandingkan distribusi Monetary antar segmen utama. Pola yang perlu diperhatikan adalah segmen kecil dengan median Monetary tinggi. Segmen seperti ini layak mendapat perhatian retensi prioritas.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

order = rfm["Segment"].value_counts().index

fig1, ax1 = plt.subplots(figsize=(10, 5))
rfm["Segment"].value_counts().loc[order].plot(kind="bar", ax=ax1)
ax1.set_title("Distribusi Jumlah Pelanggan per Segmen RFM")
ax1.set_xlabel("Segmen")
ax1.set_ylabel("Jumlah Pelanggan")
plt.xticks(rotation=30, ha="right")
plt.tight_layout()
plt.savefig("/tmp/rfm-segment-bar.png", dpi=120)

top_segments = ["Champions", "Loyal Customers", "At Risk", "Hibernating"]
plot_data = [rfm.loc[rfm["Segment"] == s, "Monetary"] for s in top_segments]

fig2, ax2 = plt.subplots(figsize=(10, 5))
ax2.boxplot(plot_data, labels=top_segments, showfliers=False)
ax2.set_title("Distribusi Monetary per Segmen Utama")
ax2.set_ylabel("Total Belanja (Monetary)")
plt.xticks(rotation=15)
plt.tight_layout()
plt.savefig("/tmp/rfm-monetary-box.png", dpi=120)
Output:
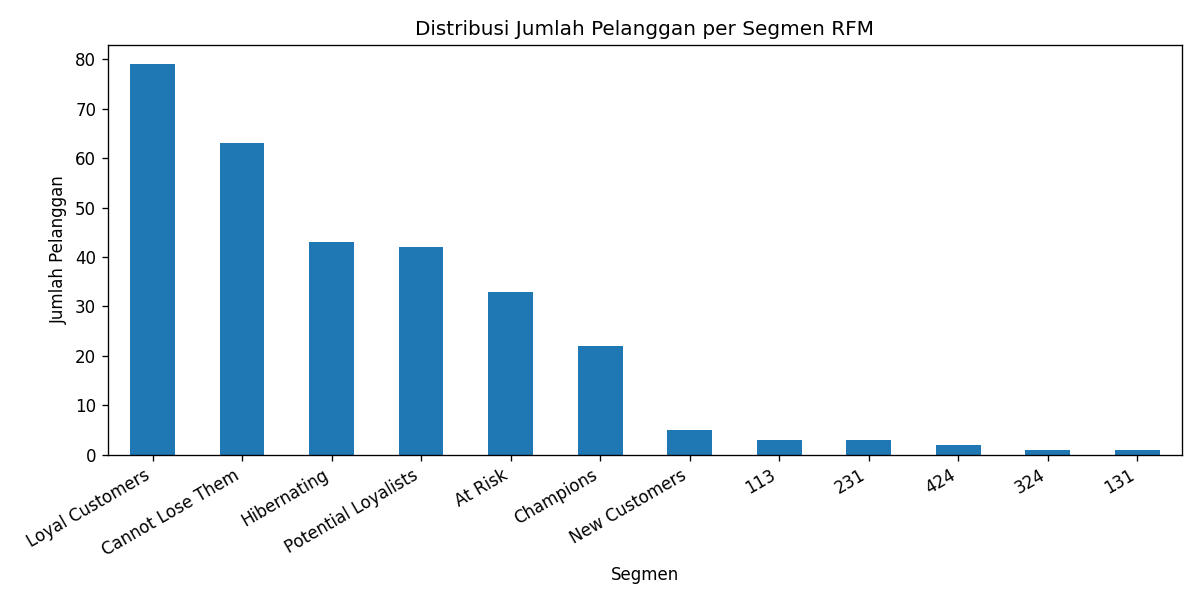
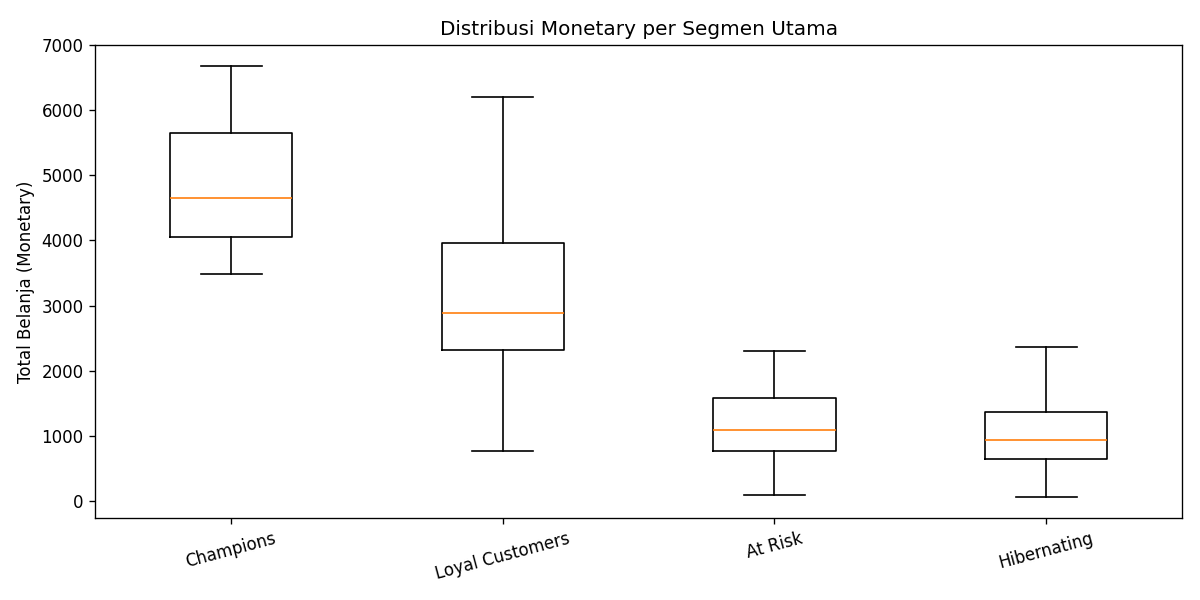
Workflow visualisasi ini memakai backend non-interaktif Agg agar stabil pada server. Output yang diharapkan adalah dua file gambar PNG. Grafik batang memberi gambaran komposisi basis pelanggan. Grafik boxplot memberi gambaran nilai ekonomi tiap segmen. Gabungan keduanya membantu tim memutuskan alokasi budget promosi secara proporsional. Cara membaca boxplot perlu dipahami dengan benar. Garis tengah kotak menunjukkan median Monetary segmen tersebut. Tinggi kotak menunjukkan sebaran nilai tengah pelanggan. Segmen Champions idealnya memiliki median tertinggi dengan sebaran sempit. Segmen At Risk dengan median rendah menjadi kandidat utama kampanye reaktivasi.
Menerjemahkan Hasil Segmentasi Menjadi Strategi Retensi yang Terukur
Setiap segmen membutuhkan perlakuan berbeda. Segmen Champions cocok untuk program loyalitas dan akses awal produk baru. Segmen Loyal Customers merespons baik pada rekomendasi personal berbasis riwayat belanja. Segmen At Risk membutuhkan pengingat atau promo reaktivasi sebelum benar-benar hilang. Segmen Hibernating membutuhkan insentif win-back yang lebih agresif. Segmen Lost sebaiknya dievaluasi dari sisi biaya akuisisi ulang.
Metode RFM memiliki batasan yang perlu We pahami. Nilai Recency sensitif terhadap pemilihan tanggal snapshot. Skor kuantil bersifat relatif terhadap dataset saat ini sehingga tidak dapat dibandingkan antar periode tanpa kalibrasi. Metode ini juga mengabaikan informasi kategori produk dan margin keuntungan. Refresh segmentasi secara bulanan menjaga relevansi skor terhadap perilaku terbaru. Dokumentasikan tanggal snapshot dan definisi kuantil setiap kali refresh dilakukan. Dokumentasi ini memastikan perbandingan antar periode tetap konsisten dan dapat diaudit oleh tim data. Ukur keberhasilan strategi dengan metrik yang jelas. Pantau migrasi pelanggan antar segmen setiap bulan. Kenaikan jumlah Champions dan penurunan jumlah At Risk menandakan retensi berjalan baik. Targetkan persentase reaktivasi Hibernating sebagai KPI kampanye win-back.
Gambar: Dashboard analitik membantu tim memantau migrasi segmen dan mengukur keberhasilan retensi — Foto oleh Carlos Muza, Sumber: Unsplash
Langkah lanjutan yang realistis adalah menggabungkan RFM dengan analisis cohort. Analisis cohort melacak retensi kelompok pelanggan dari waktu ke waktu. Gabungan RFM dan cohort memberi pandangan titik waktu sekaligus tren. Pendekatan berikutnya adalah memprediksi Customer Lifetime Value dengan regresi. Model tersebut memakai fitur RFM sebagai input untuk estimasi nilai masa depan.
We telah menghitung skor RFM dengan Pandas dan memvisualisasikan segmen dengan Matplotlib dalam satu alur kerja yang reproducible. Praktik langsung seperti ini mempercepat pemahaman analisis pelanggan dibanding membaca teori saja. Program Data Science di Rumah Coding membahas workflow serupa dengan dataset real dan review mentor. Kunjungi katalog kelas Rumah Coding untuk melanjutkan pembelajaran ke analisis cohort dan pemodelan CLV.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Machine Learning Bootcamp
A beginner-friendly, 7-week project-based bootcamp designed to take you from Python basics to deploying your first Machine Learning model. Through hands-on practice, you will master essential data manipulation, build predictive algorithms, and develop an end-to-end, industry-ready application to kickstart your career in data science.
End-to-End Student Success Predictor
- Automated Data Pipeline: A preprocessing script that automatically cleans missing values, encodes categorical data (like course type or student background), and scales numerical inputs.
- Predictive Engine: A tuned machine learning classification model (e.g., Random Forest) specifically optimized for high Recall, ensuring that "at-risk" students are not missed.
- Interactive Web Dashboard: A user-friendly Streamlit interface featuring a sidebar where instructors can manually input a student's study hours, quiz scores, and login frequency to get an instant pass/fail probability.
Related Articles
Memahami Konsep Missing Data Mechanism (MCAR, MAR, MNAR) dan Implementasinya dengan Python untuk Imputasi yang Tepat
Implementasi Data Wrangling dengan PySpark: Transformasi Dataset Skala Besar secara Distributed