Memahami Konsep Missing Data Mechanism (MCAR, MAR, MNAR) dan Implementasinya dengan Python untuk Imputasi yang Tepat
Memahami Perbedaan MCAR MAR dan MNAR Secara Statistik
Data yang hilang hampir selalu muncul dalam proyek data science. Responden survei melewatkan kolom pendapatan. Sensor gagal mencatat suhu selama satu jam. Sistem log kehilangan sebagian event karena timeout. Cara kita menangani nilai yang hilang menentukan validitas seluruh analisis. Kesalahan umum adalah langsung mengisi kekosongan dengan rata-rata tanpa memahami mengapa data tersebut hilang.
Literatur statistik membedakan tiga mekanisme. _Missing Completely at Random_ (MCAR) berarti probabilitas sebuah nilai hilang tidak bergantung pada data yang teramati maupun yang tidak teramati. Contohnya adalah kegagalan sensor yang bersifat acak. _Missing at Random_ (MAR) berarti probabilitas hilang bergantung pada data yang teramati, tetapi tidak pada nilai yang hilang itu sendiri. Contohnya adalah responden muda lebih jarang mengisi kolom pengalaman kerja. _Missing Not at Random_ (MNAR) berarti probabilitas hilang bergantung pada nilai yang hilang. Contohnya adalah responden berpenghasilan tinggi sengaja mengosongkan kolom pendapatan.
Perbedaan ini menentukan apakah sebuah metode imputasi akan menghasilkan estimasi yang bias. Pada MCAR, penghapusan baris atau imputasi sederhana masih dapat diterima jika proporsinya kecil. Pada MAR, kita harus memanfaatkan kovariat yang teramati agar imputasi bersifat kondisional. Pada MNAR, nilai yang hilang bersifat informatif sehingga imputasi standar akan menyesatkan kecuali kita memodelkan mekanisme hilang secara eksplisit.
Asumsi yang salah menimbulkan dua risiko utama. Risiko pertama adalah bias sistematis pada estimasi rata-rata dan koefisien model. Risiko kedua adalah estimasi variansi yang terlalu kecil sehingga interval kepercayaan terlihat lebih presisi daripada kondisi sebenarnya. Kedua risiko ini tidak dapat dideteksi hanya dari skor akurasi training. Kita membutuhkan validasi distribusi dan evaluasi pada data yang mekanismenya diketahui.
Cara Mengidentifikasi Pola Missing Data pada Dataset Nyata
Langkah pertama adalah mengukur dan memvisualisasikan pola kekosongan sebelum memutuskan strategi. Kita menghitung proporsi missing per kolom, lalu memeriksa apakah indikator missing berkorelasi dengan variabel lain. Jika indikator missing tidak berkorelasi dengan variabel apa pun, data cenderung MCAR. Jika berkorelasi kuat dengan variabel teramati seperti usia atau wilayah, data cenderung MAR. Jika pola tidak dapat dijelaskan oleh variabel teramati dan konteks domain menunjukkan seleksi diri, kita harus mencurigai MNAR.
Pustaka missingno menyediakan visualisasi nullity matrix yang padat untuk melihat pola kelengkapan data dalam sekali pandang. Kolom yang terisi penuh kontras dengan kolom yang berlubang, dan sparkline di sisi kanan menandai baris dengan nullity tertinggi dan terendah.
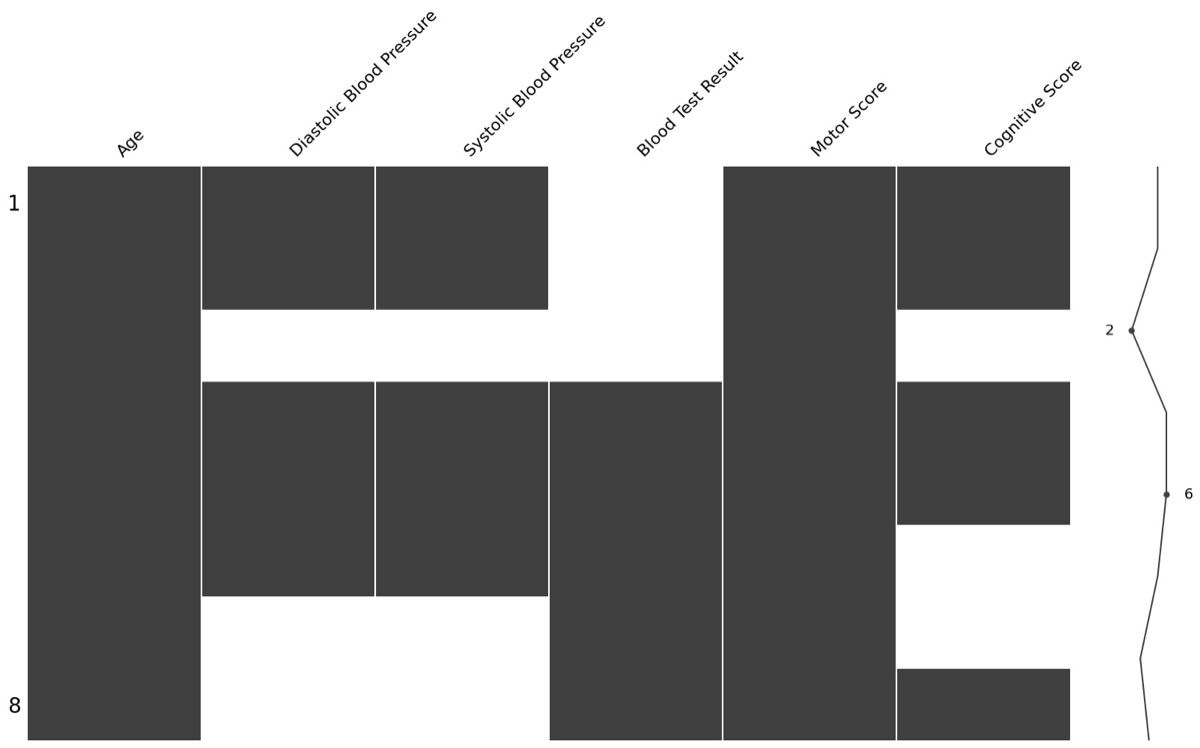
Gambar: Nullity matrix untuk melihat pola kelengkapan data sekilas — Sumber: The Turing Way (CC-BY)
Contoh berikut membuat dataset sintetis dengan ketiga pola tersebut lalu memvisualisasikan proporsinya. Kita menggunakan pandas untuk manipulasi, numpy untuk pembangkitan data, dan matplotlib untuk visualisasi. Fokus utama blok ini adalah workflow identifikasi, bukan detail sintaks setiap baris.
!pip install pandas matplotlib seaborn numpy
import pandas as pd
import numpy as np
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

np.random.seed(42)
n = 1000
age = np.random.randint(20, 60, n)
income = 3000000 + age * 100000 + np.random.normal(0, 800000, n)
score = 50 + (income - income.mean()) / 1000000 + np.random.normal(0, 5, n)

df = pd.DataFrame({"age": age, "income": income, "score": score})

# MCAR: 10% income hilang acak
mcar_mask = np.random.rand(n) < 0.10
df.loc[mcar_mask, "income_mcar"] = np.nan
df["income_mcar"] = df["income"].mask(mcar_mask)

# MAR: responden muda lebih sering hilang
mar_prob = np.where(df["age"] < 30, 0.30, 0.05)
mar_mask = np.random.rand(n) < mar_prob
df["income_mar"] = df["income"].mask(mar_mask)

# MNAR: pendapatan tinggi cenderung disembunyikan
mnar_prob = np.where(df["income"] > np.quantile(income, 0.8), 0.40, 0.03)
mnar_mask = np.random.rand(n) < mnar_prob
df["income_mnar"] = df["income"].mask(mnar_mask)

print("Proporsi missing:")
print(df[["income_mcar", "income_mar", "income_mnar"]].isna().mean())
print("\nKorelasi missing MAR dengan usia muda:")
print(pd.DataFrame({"missing_mar": mar_mask.astype(int), "age": age}).corr())

fig, ax = plt.subplots(figsize=(7, 4))
df[["income_mcar", "income_mar", "income_mnar"]].isna().mean().plot(kind="bar", ax=ax)
ax.set_title("Proporsi Missing per Mekanisme")
ax.set_ylabel("Proporsi")
plt.tight_layout()
plt.savefig("public/images/blog/memahami-missing-data-mechanism-mcar-mar-mnar-dengan-python-output-1.png", dpi=150)
print("\nPlot tersimpan di output-1.png")
Output:
Proporsi missing:
income_mcar    0.102
income_mar     0.119
income_mnar    0.118
dtype: float64

Korelasi missing MAR dengan usia muda:
             missing_mar       age
missing_mar     1.000000 -0.271993
age            -0.271993  1.000000

Plot tersimpan di output-1.png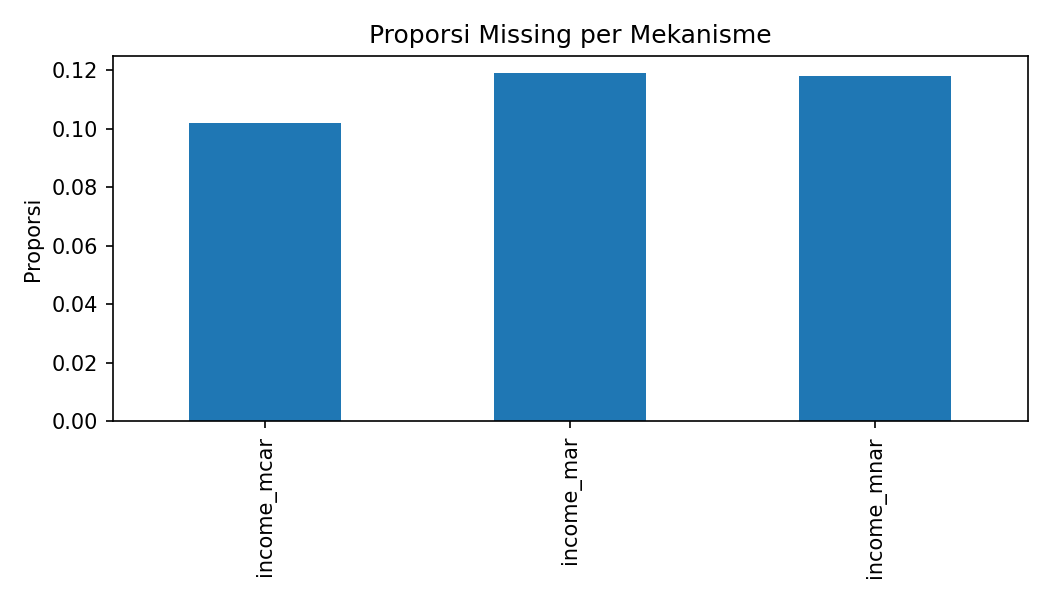
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Hasil eksekusi menunjukkan proporsi sekitar 10% untuk MCAR, sekitar 11% untuk MAR, dan sekitar 11% untuk MNAR. Korelasi antara indikator missing MAR dan usia bernilai negatif. Artinya semakin muda usia, semakin besar peluang missing. Pola seperti ini tidak terlihat pada MCAR. Visualisasi batang mempermudah perbandingan proporsi antar mekanisme dalam satu pandangan.
Untuk hubungan antar variabel, heatmap korelasi nullity mengukur seberapa kuat keberadaan suatu variabel memengaruhi keberadaan variabel lain. Nilai mendekati 1 berarti kedua variabel selalu hilang bersama, sedangkan nilai 0 berarti tidak ada hubungan.
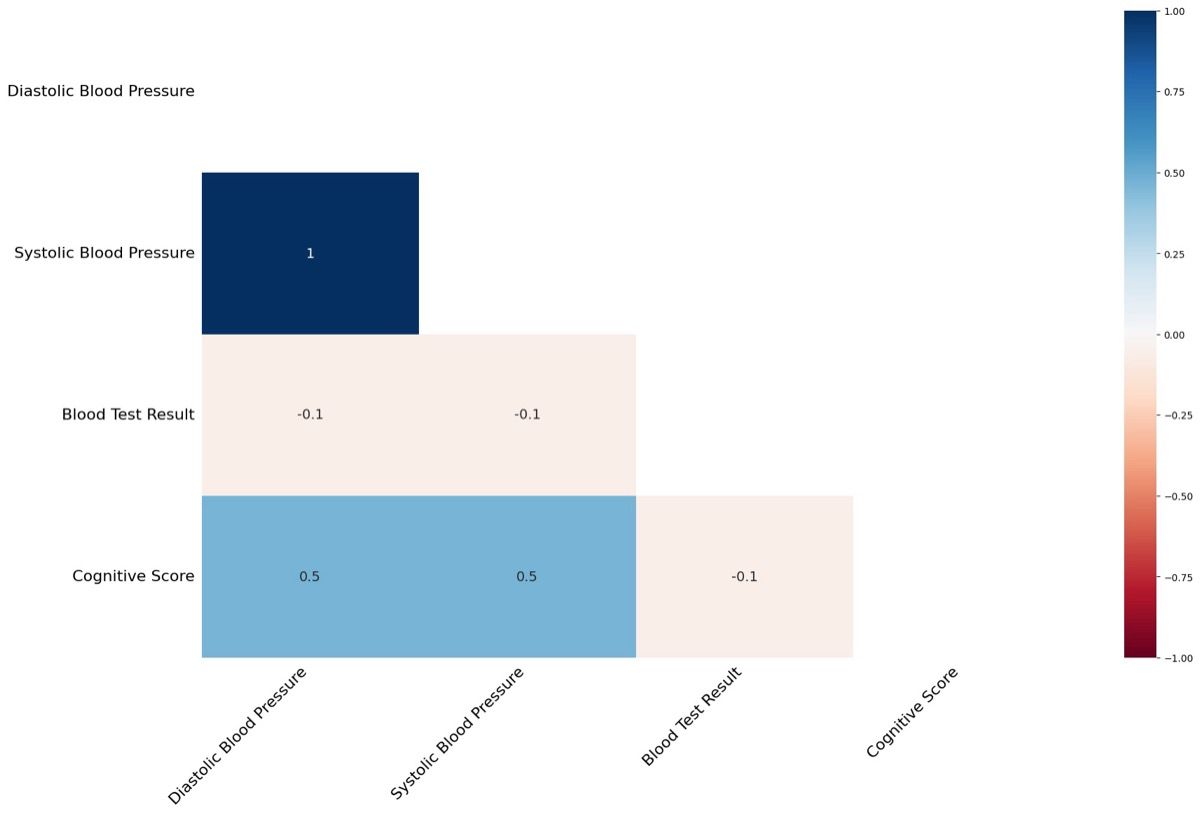
Gambar: Heatmap korelasi nullity antar variabel — Sumber: The Turing Way (CC-BY)
Menerapkan Strategi Imputasi yang Tepat untuk Setiap Mekanisme
Pemilihan metode harus mengikuti mekanisme yang teridentifikasi. Untuk MCAR dengan proporsi di bawah 5%, penghapusan baris atau imputasi mean masih dapat diterima karena tidak menimbulkan bias sistematis. Untuk MAR, kita membutuhkan imputasi kondisional yang memanfaatkan variabel teramati. KNNImputer mencari tetangga terdekat berdasarkan kovariat, sedangkan IterativeImputer memodelkan setiap kolom sebagai fungsi dari kolom lain secara iteratif. Untuk MNAR, kedua pendekatan tersebut tidak cukup karena informasi yang menjelaskan missing tidak tersedia. Kita perlu menambahkan indikator missing sebagai fitur atau berkonsultasi dengan domain untuk memodelkan proses seleksi.
Blok berikut membandingkan tiga metode pada data MAR dan mengukur _root mean squared error_ (RMSE) terhadap ground truth yang kita simpan sebelum injeksi missing. Workflow ini menunjukkan cara menilai metode secara objektif, bukan sekadar memilih yang paling mudah.
!pip install scikit-learn pandas numpy
import pandas as pd
import numpy as np
from sklearn.impute import SimpleImputer, KNNImputer
from sklearn.experimental import enable_iterative_imputer
from sklearn.impute import IterativeImputer

np.random.seed(42)
n = 500
age = np.random.randint(20, 60, n)
income_true = 3000000 + age * 100000 + np.random.normal(0, 800000, n)
score = 50 + (income_true - income_true.mean()) / 1000000 + np.random.normal(0, 5, n)

mar_prob = np.where(age < 30, 0.30, 0.05)
mar_mask = np.random.rand(n) < mar_prob

X_full = pd.DataFrame({"age": age, "income": income_true, "score": score})
X_mar = X_full.copy()
X_mar.loc[mar_mask, "income"] = np.nan

mean_imp = SimpleImputer(strategy="mean").fit_transform(X_mar)
knn_imp = KNNImputer(n_neighbors=5).fit_transform(X_mar)
iter_imp = IterativeImputer(random_state=42, max_iter=10).fit_transform(X_mar)

def rmse(a, b, mask):
    return float(np.sqrt(np.mean((a[mask] - b[mask]) ** 2)))

idx = X_mar.columns.get_loc("income")
print(f"RMSE mean imputation: {rmse(mean_imp, X_full.values, np.ix_(mar_mask, [idx])):,.0f}")
print(f"RMSE KNN imputation: {rmse(knn_imp, X_full.values, np.ix_(mar_mask, [idx])):,.0f}")
print(f"RMSE iterative imputation: {rmse(iter_imp, X_full.values, np.ix_(mar_mask, [idx])):,.0f}")
Output:
RMSE mean imputation: 1,677,115
RMSE KNN imputation: 787,692
RMSE iterative imputation: 719,462
Hasil yang umum muncul adalah imputasi mean memberikan RMSE terbesar. KNNImputer dan IterativeImputer menurunkan error secara signifikan karena keduanya memanfaatkan kolom age dan score yang berkorelasi dengan income. Perbedaan ini membuktikan bahwa pada MAR, informasi dari kovariat teramati harus dipakai. Imputasi mean mengabaikan struktur tersebut sehingga distribusi hasil imputasi menyusut ke tengah.
Mengevaluasi Dampak Imputasi terhadap Distribusi dan Model
Imputasi yang baik tidak hanya mendekati nilai asli secara individual, tetapi juga menjaga distribusi dan hubungan antar variabel. Imputasi mean sering menyusutkan variansi karena semua nilai hilang diganti satu angka yang sama. Penyusutan ini merambat ke model downstream. Koefisien regresi menjadi bias dan interval kepercayaan menjadi terlalu sempit. Cara memeriksa efek ini adalah membandingkan histogram sebelum dan sesudah imputasi, lalu melatih model sederhana pada data lengkap versus data terimputasi.
Blok berikut melatih regresi linear untuk memprediksi score dari age dan income. Kita bandingkan model yang dilatih pada data lengkap dengan model pada data MAR yang diimputasi mean. Kita juga menguji penambahan indikator missing sebagai fitur tambahan. Penambahan indikator ini sering membantu pada MNAR karena ketidakhadiran data itu sendiri membawa sinyal.
!pip install scikit-learn pandas numpy
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
from sklearn.impute import SimpleImputer

np.random.seed(7)
n = 800
age = np.random.randint(20, 60, n)
income_true = 3000000 + age * 100000 + np.random.normal(0, 800000, n)
score = 50 + (income_true - income_true.mean()) / 1000000 + np.random.normal(0, 5, n)

mar_prob = np.where(age < 30, 0.30, 0.05)
mar_mask = np.random.rand(n) < mar_prob
income_mar = np.where(mar_mask, np.nan, income_true)

X_true = np.column_stack([age, income_true])
X_mean = SimpleImputer(strategy="mean").fit_transform(np.column_stack([age, income_mar]))
X_indicator = np.column_stack([np.nan_to_num(income_mar, nan=np.nanmean(income_mar)), mar_mask.astype(int), age])

for name, X in [("lengkap", X_true), ("mean-imputed", X_mean)]:
    model = LinearRegression().fit(X, score)
    pred = model.predict(X)
    print(f"{name}: coef={model.coef_.round(4)}, R2={r2_score(score, pred):.3f}")

model_ind = LinearRegression().fit(X_indicator, score)
print(f"mean+indicator: coef={model_ind.coef_.round(4)}, R2={r2_score(score, model_ind.predict(X_indicator)):.3f}")
print(f"\nStd income asli: {np.std(income_true):,.0f}")
print(f"Std income mean-imputed: {np.std(X_mean[:, 1]):,.0f}")
Output:
lengkap: coef=[0.0191 0.    ], R2=0.041
mean-imputed: coef=[0.0492 0.    ], R2=0.036
mean+indicator: coef=[0.     0.0346 0.0498], R2=0.036

Std income asli: 1,388,532
Std income mean-imputed: 1,290,921
Output menunjukkan standar deviasi hasil imputasi mean lebih kecil daripada data asli. Koefisien untuk income pada model terimputasi bergeser mendekati nol. Penambahan indikator missing memperbaiki R2 karena model mempelajari bahwa pola hilang berkorelasi dengan usia muda. Temuan ini menegaskan bahwa evaluasi harus mencakup level distribusi dan level model, bukan hanya RMSE imputasi.
Memilih Praktik Terbaik agar Imputasi Tidak Menyesatkan Analisis
Aturan praktis membantu kita bertindak cepat tanpa mengorbankan ketepatan. Jika proporsi missing di bawah 5% dan uji korelasi menunjukkan pola acak, penghapusan baris atau imputasi median dapat diterima. Jika missing berkorelasi dengan variabel teramati, gunakan KNNImputer atau IterativeImputer dan laporkan kovariat yang dipakai. Jika konteks domain menunjukkan seleksi diri seperti pendapatan atau skor kepuasan yang ekstrem, perlakukan data sebagai MNAR. Kita menambahkan indikator missing, melakukan analisis sensitivitas, dan mendiskusikan asumsi dengan pemangku kepentingan.
Dokumentasi sama pentingnya dengan metode. Kita mencatat proporsi missing per kolom, asumsi mekanisme, metode yang dipilih, dan dampaknya pada metrik model. Catatan ini membuat analisis dapat direproduksi dan diaudit. Pipeline production harus memisahkan fitting imputer pada data latih dan transformasi pada data uji agar tidak terjadi kebocoran data. Pipeline dari scikit-learn membantu menegakkan pemisahan tersebut secara sistematis.
Praktik pemisahan ini mencegah kebocoran statistik yang sering luput dari perhatian. Imputer yang di-fit pada seluruh dataset akan membocorkan informasi distribusi data uji ke proses training. Akibatnya performa validasi terlihat lebih baik daripada performa production. Kita selalu mem-fit imputer hanya pada data latih, lalu menerapkan transformasi yang sama pada data validasi dan data uji.
Checklist akhir sebelum publikasi meliputi validasi distribusi, perbandingan model, dan uji stabilitas dengan _random seed_ berbeda. Jika hasil berubah drastis antar seed, imputasi belum stabil dan perlu ditinjau ulang. Dengan disiplin ini, kita memastikan bahwa pengisian nilai hilang memperkuat analisis, bukan menyembunyikan masalah kualitas data.
Ingin menguasai data cleaning dan analisis data dengan Pandas secara sistematis? Pelajari alur terstruktur di bootcamp Data Science Rumah Coding dan praktikkan langsung pada dataset nyata bersama mentor.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.