Teori dan Implementasi Contrastive Learning (SimCLR) dengan PyTorch untuk Representation Learning
Mengapa Supervised Classification Menghasilkan Representasi yang Rapuh
Model klasifikasi supervised dengan label terbatas belajar memisahkan kelas yang ada di dataset, bukan memahami objek. Fitur yang terbentuk sering terikat pada kombinasi warna, tekstur, dan latar yang kebetulan berkorelasi dengan label. Ketika domain bergeser, misalnya kamera berbeda atau pencahayaan berubah, akurasi turun karena fitur tersebut tidak menangkap struktur visual yang stabil.
Representation learning mengubah tujuan optimasi. Output yang diinginkan bukan probabilitas kelas, melainkan vektor embedding yang informatif. Classifier linear di atas embedding menjadi alat ukur, bukan bagian dari tujuan training. Dengan embedding yang baik, tugas downstream seperti retrieval, deteksi, dan segmentasi cukup memakai sedikit label.
Contrastive learning mendefinisikan tujuan itu melalui relasi antar sampel. Kita mendorong positive pair saling berdekatan dan negative pair saling berjauhan di ruang embedding. Embedding space adalah peta di mana jarak antar titik mewakili kemiripan makna, bukan kemiripan piksel. Tanpa label manual, positive pair dibentuk dari dua augmentasi berbeda pada gambar yang sama, sedangkan negative pair adalah sampel lain dalam batch.
Ilustrasi berikut menunjukkan pembentukan pasangan tersebut: dua gambar dari objek yang sama dihubungkan sebagai positive pair, sedangkan gambar objek lain berperan sebagai negative pair.
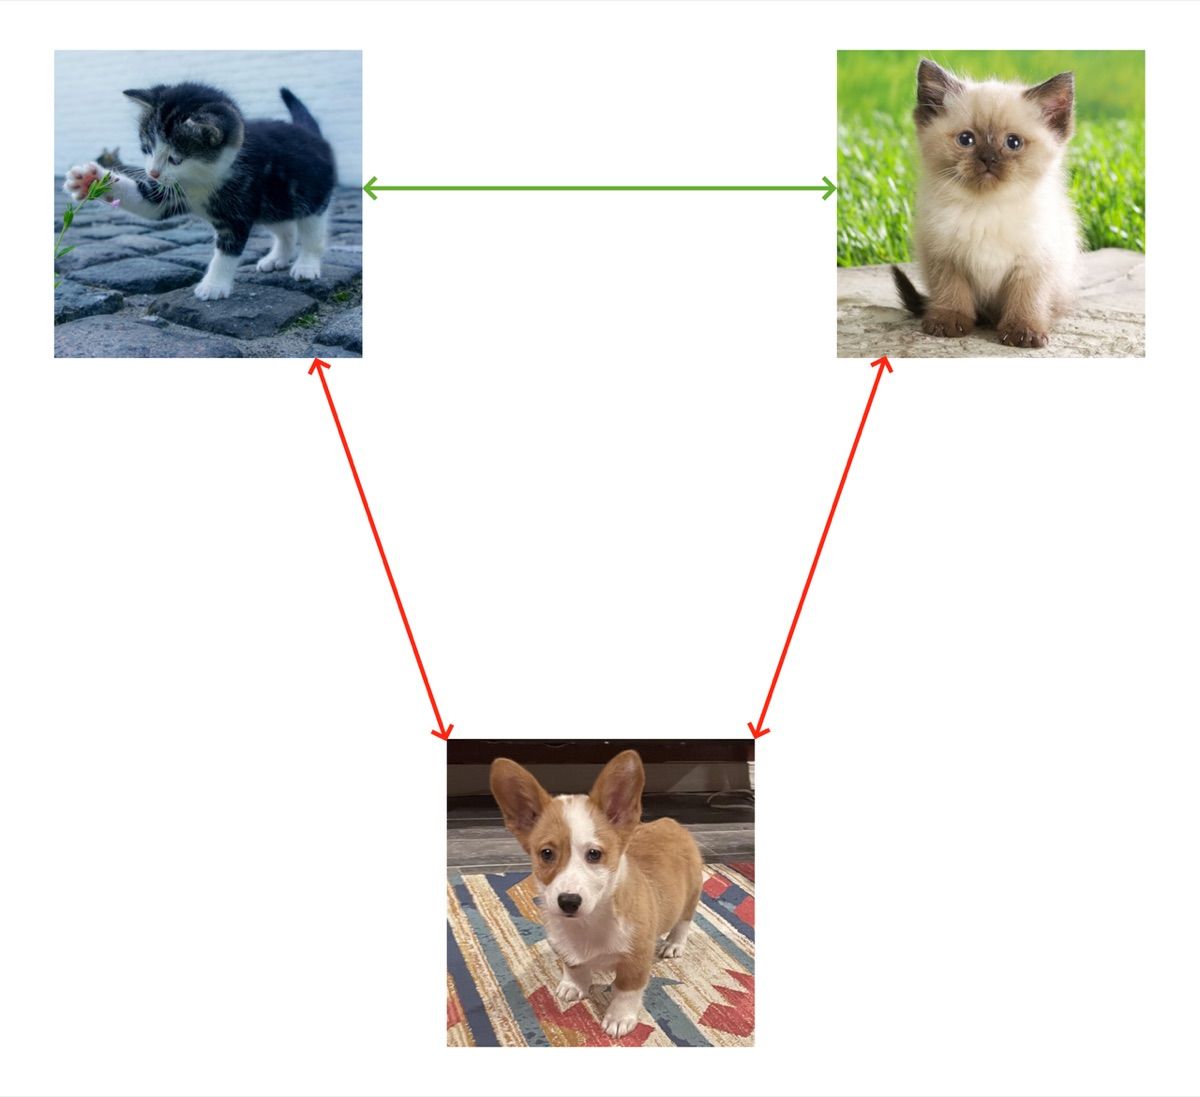
Gambar: dua gambar kucing sebagai positive pair (panah hijau) dan gambar anjing sebagai negative pair (panah merah) — Sumber: Positive and negative pairs for contrastive learning — A potato hater, CC BY-SA 4.0
SimCLR memperkenalkan resep yang relatif sederhana untuk ide tersebut: satu encoder, satu projection head, dan NT-Xent loss. Tidak ada memory bank atau arsitektur khusus seperti pada metode sebelumnya. Karena itu SimCLR sering menjadi titik awal untuk mempelajari self-supervised learning pada computer vision.
Batasan SimCLR terasa saat implementasi. Jumlah negatif bergantung pada batch size, sehingga batch kecil melemahkan sinyal contrastive. Biaya komputasi untuk membangun seluruh pasangan juga naik seiring ukuran batch. Artikel ini membangun versi kecil yang berjalan di CPU agar mekanismenya terlihat, lalu mengukur kualitas representasi dengan linear probe dan t-SNE.
Mekanisme SimCLR dan NT-Xent Loss
Satu iterasi SimCLR dimulai dari satu batch gambar. Setiap gambar ditransformasi dua kali secara acak sehingga menghasilkan dua view. Kedua view melewati encoder yang sama, lalu projection head, dan menghasilkan dua vektor embedding. Encoder tidak pernah menerima label kelas.
Alur tersebut digambarkan pada diagram berikut.
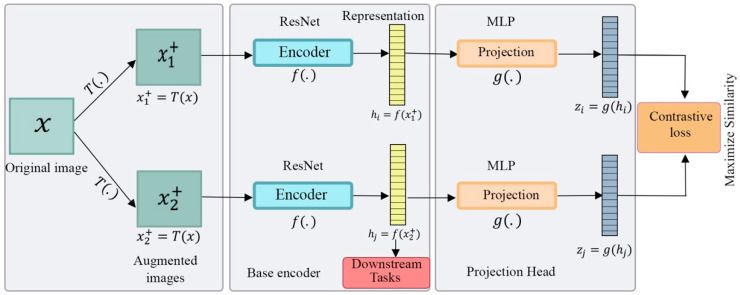
Gambar: alur SimCLR, dari satu gambar menjadi dua view hasil augmentasi, melewati encoder bersama dan projection head, lalu loss memaksimalkan kemiripan keduanya. Label "ResNet" mengikuti encoder default pada paper aslinya; implementasi di artikel ini memakai CNN kecil — Sumber: Survey on Self-Supervised Learning: Auxiliary Pretext Tasks and Contrastive Learning Methods in Imaging — Saleh Albelwi, CC BY 4.0
Augmentasi berperan sebagai sumber sinyal positif. RandomResizedCrop mengubah skala dan posisi objek, ColorJitter mengubah fotometri, RandomGrayscale menghapus informasi warna, dan RandomHorizontalFlip mengubah orientasi. Dua view dianggap mewakili objek yang sama, sehingga encoder dilatih untuk invarian terhadap transformasi tersebut.
ProjectionHead adalah MLP kecil dengan pola Linear-ReLU-Linear. Loss dihitung dari output head, bukan output encoder. Ruang loss dibuat lebih sempit agar encoder tidak dipaksa membuang informasi yang berguna hanya demi invariance. Saat inference, output encoder yang dipakai untuk tugas downstream.
NT-Xent loss (Normalized Temperature-scaled Cross Entropy) untuk pasangan positif $(i, j)$ ditulis sebagai:
$$\ell_{i,j} = -\log \frac{\exp(\mathrm{sim}(z_i, z_j)/\tau)}{\sum_{k=1}^{2N} \mathbb{1}_{[k \neq i]} \exp(\mathrm{sim}(z_i, z_k)/\tau)}$$
sim adalah cosine similarity dan $\tau$ adalah temperature. Nilai $\tau$ kecil membuat distribusi lebih tajam dan penalti pada negatif sulit lebih besar. Nilai $\tau$ besar memberi gradien yang lebih halus, tetapi pemisahan antar kelas melemah.
Implementasinya membangun matriks similarity $2N \times 2N$ dari satu batch. Embedding dinormalisasi L2, dibagi dengan $\tau$, lalu diagonal diisi nilai sangat kecil sebelum cross_entropy. Masking diagonal diperlukan karena setiap sampel selalu paling mirip dengan dirinya sendiri, dan pasangan itu bukan target prediksi.
Perbedaan dengan Siamese network terletak pada jumlah pembanding. Siamese network melatih satu pasangan per langkah, sedangkan SimCLR memakai $2N-2$ negatif untuk setiap anchor. Jumlah negatif yang besar membuat estimasi loss lebih stabil, dengan syarat batch cukup besar.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Membangun Augmentation Pipeline dan Encoder SimCLR dengan PyTorch
Implementasi memakai torch dan torchvision tanpa dataset eksternal. Semua tensor dibuat di CPU dengan ukuran 3x32x32 agar satu sesi training selesai dalam hitungan detik.
!pip install torch torchvision

import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision import transforms

torch.manual_seed(42)

class SimCLRAugmentation(nn.Module):
    def __init__(self):
        super().__init__()
        self.augment = transforms.Compose([
            transforms.RandomResizedCrop(32, scale=(0.7, 1.0)),
            transforms.RandomHorizontalFlip(),
            transforms.ColorJitter(0.2, 0.2, 0.2, 0.05),
            transforms.RandomGrayscale(p=0.05),
        ])

    def forward(self, x):
        return self.augment(x), self.augment(x)

class Encoder(nn.Module):
    def __init__(self, embed_dim=128):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, 3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.AdaptiveAvgPool2d(1),
        )
        self.projection = nn.Linear(64, embed_dim)

    def forward(self, x):
        return self.projection(self.features(x).flatten(1))

class ProjectionHead(nn.Module):
    def __init__(self, in_dim=128, hidden_dim=128, out_dim=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_dim, hidden_dim), nn.ReLU(),
            nn.Linear(hidden_dim, out_dim),
        )

    def forward(self, x):
        return self.net(x)

class SimCLRModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = Encoder()
        self.head = ProjectionHead()

    def forward(self, x):
        h = self.encoder(x)
        return h, self.head(h)

model = SimCLRModel()
augment = SimCLRAugmentation()
batch = torch.rand(8, 3, 32, 32)
view1, view2 = augment(batch)
h, z = model(view1)
print(model.encoder)
print(model.head)
print(f"total parameter: {sum(p.numel() for p in model.parameters()):,}")
print(f"encoder: {tuple(h.shape)} | projection: {tuple(z.shape)}")
Output:
Encoder(
  (features): Sequential(
    (0): Conv2d(3, 32, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (1): BatchNorm2d(32, eps=1e-05, momentum=0.1, affine=True, bias=True, track_running_stats=True)
    (2): ReLU()
    (3): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (4): Conv2d(32, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
    (5): BatchNorm2d(64, eps=1e-05, momentum=0.1, affine=True, bias=True, track_running_stats=True)
    (6): ReLU()
    (7): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
    (8): AdaptiveAvgPool2d(output_size=1)
  )
  (projection): Linear(in_features=64, out_features=128, bias=True)
)
ProjectionHead(
  (net): Sequential(
    (0): Linear(in_features=128, out_features=128, bias=True)
    (1): ReLU()
    (2): Linear(in_features=128, out_features=64, bias=True)
  )
)
total parameter: 52,672
encoder: (8, 128) | projection: (8, 64)
Kelas SimCLRAugmentation memanggil self.augment(x) dua kali. Setiap panggilan mengambil parameter acak sendiri, sehingga dua view tidak identik. Pola ini yang membuat pasangan positif tetap menantang, bukan sekadar salinan gambar.
Encoder terdiri dari dua blok Conv2d + BatchNorm2d + ReLU + MaxPool2d, lalu AdaptiveAvgPool2d dan satu Linear dari 64 ke 128. ProjectionHead memetakan 128 ke 128 lalu ke 64. Dimensi output head lebih kecil karena ruang loss hanya perlu memisahkan sampel, sementara encoder menyimpan detail yang dibutuhkan tugas downstream.
Encoder tidak memakai label. Supervisi satu-satunya berasal dari pasangan view. Output yang diharapkan adalah ringkasan arsitektur dan bentuk tensor: encoder (8, 128) dan projection (8, 64) untuk batch uji 8 gambar. Total parameter sekitar 52 ribu, cukup kecil untuk berjalan di CPU.
Implementasi NT-Xent Loss dan Training Loop dengan Data Sintetis
nt_xent_loss melakukan empat langkah. Embedding dinormalisasi L2 agar similarity berada di rentang -1 sampai 1, matriks similarity dihitung dengan torch.matmul, nilainya dibagi temperature, dan diagonal dimasking sebelum cross_entropy.
Label positif disusun manual. View pertama pada indeks i berpasangan dengan view kedua pada indeks i + batch_size, sehingga label untuk separuh pertama adalah arange(n, 2n) dan separuh kedua arange(0, n). nn.CrossEntropyLoss kemudian membaca setiap baris matriks sebagai distribusi logits.
Data sintetis dibangun dari 8 kelas warna dengan pola blob acak per gambar. Pola unik ini penting: jika semua gambar dalam satu kelas identik, negatif palsu dengan similarity tinggi akan membuat loss mentok di nilai besar. Blok berikut melanjutkan model dan augment dari bagian sebelumnya.
!pip install torch torchvision

import torch
import torch.nn as nn
import torch.nn.functional as F

def make_pattern_data(n_per_class=40, size=32):
    colors = torch.tensor([
        [0.90, 0.15, 0.15], [0.15, 0.80, 0.30], [0.20, 0.30, 0.90], [0.90, 0.80, 0.15],
        [0.80, 0.20, 0.80], [0.15, 0.80, 0.80], [0.95, 0.55, 0.15], [0.75, 0.75, 0.75],
    ])
    images, labels = [], []
    for c in range(8):
        for _ in range(n_per_class):
            blob = torch.randn(1, 8, 8).repeat(3, 1, 1)
            blob = F.interpolate(blob.unsqueeze(0), size=(size, size), mode="bilinear").squeeze(0)
            img = 0.6 * colors[c].view(3, 1, 1) + 0.4 * torch.sigmoid(blob)
            img = (img + 0.02 * torch.randn_like(img)).clamp(0, 1)
            images.append(img)
            labels.append(c)
    return torch.stack(images), torch.tensor(labels)

def nt_xent_loss(z, temperature=0.2):
    z = F.normalize(z, dim=1)
    n = z.size(0) // 2
    sim = torch.matmul(z, z.t()) / temperature
    sim.fill_diagonal_(-1e9)
    labels = torch.cat([torch.arange(n, 2 * n), torch.arange(0, n)])
    return F.cross_entropy(sim, labels)

images, labels = make_pattern_data()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
batch_size = 32

for epoch in range(10):
    model.train()
    perm = torch.randperm(len(images))
    total = 0.0
    for start in range(0, len(images), batch_size):
        batch = images[perm[start:start + batch_size]]
        v1, v2 = augment(batch)
        _, z = model(torch.cat([v1, v2], dim=0))
        loss = nt_xent_loss(z)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        total += loss.item() * len(batch)
    print(f"epoch {epoch + 1:02d} | loss={total / len(images):.4f}")
Output:
epoch 01 | loss=3.3740
epoch 02 | loss=2.8987
epoch 03 | loss=2.4601
epoch 04 | loss=2.8002
epoch 05 | loss=2.7234
epoch 06 | loss=2.5402
epoch 07 | loss=2.7595
epoch 08 | loss=2.8127
epoch 09 | loss=2.5250
epoch 10 | loss=2.4202
Training loop menjalankan zero_grad, forward dua view dalam satu panggilan, hitung loss, backward, lalu optimizer.step. Kedua view harus masuk dalam satu forward pass karena matriks negatif dibangun dari seluruh isi batch. Jika view diproses terpisah, tidak ada negatif yang bisa dibandingkan dalam satu matriks.
Nilai loss teoretis di awal training berada di sekitar $\log(2N-1)$, yaitu $\log(63) \approx 4.14$ untuk batch 32. Pada eksekusi ini rata-rata epoch pertama sudah 3.37 karena model langsung menangkap sinyal warna, lalu turun ke 2.42 dalam 10 epoch. Fluktuasi kecil muncul karena batch berukuran kecil. Data sintetis tidak mewakili citra nyata, jadi penurunan loss belum cukup untuk menyimpulkan kualitas representasi.
Evaluasi Kualitas Representasi dengan Linear Probe dan Visualisasi t-SNE
Kita tidak bisa memakai loss training sebagai ukuran kualitas representasi. Nilai loss bisa turun karena encoder mempelajari invariance yang tidak berguna. Metrik yang lebih relevan adalah performa pada tugas downstream dengan encoder yang dibekukan.
Linear probe membekukan encoder, mengekstrak embedding, lalu melatih satu layer Linear di atas embedding memakai label. Akurasi probe mengukur seberapa mudah fitur dipisahkan secara linear. Alternatif k-NN evaluation mencari tetangga terdekat di ruang embedding tanpa training tambahan. Metode ini praktis saat data validasi sedikit atau evaluasi perlu cepat. Blok berikut memakai model yang sudah dilatih pada bagian sebelumnya.
!pip install torch torchvision scikit-learn matplotlib

import matplotlib.pyplot as plt
from sklearn.manifold import TSNE
from sklearn.metrics import accuracy_score

@torch.no_grad()
def extract_embeddings(x):
    model.eval()
    return model.encoder(x)

embeddings = extract_embeddings(images)
idx = torch.randperm(len(images))
train_idx, val_idx = idx[:256], idx[256:]

for p in model.encoder.parameters():
    p.requires_grad = False

probe = nn.Linear(embeddings.shape[1], 8)
opt = torch.optim.Adam(probe.parameters(), lr=1e-2)
for step in range(300):
    opt.zero_grad()
    loss = F.cross_entropy(probe(embeddings[train_idx]), labels[train_idx])
    loss.backward()
    opt.step()

with torch.no_grad():
    pred = probe(embeddings[val_idx]).argmax(dim=1)
acc = accuracy_score(labels[val_idx].numpy(), pred.numpy())
print(f"linear probe accuracy: {acc:.3f}")

tsne = TSNE(n_components=2, perplexity=20, random_state=42, init="pca")
coords = tsne.fit_transform(embeddings.numpy())
plt.figure(figsize=(6, 5))
for c in range(8):
    mask = labels.numpy() == c
    plt.scatter(coords[mask, 0], coords[mask, 1], s=14, label=f"class {c}")
plt.legend(ncol=2, fontsize=8)
plt.title("t-SNE embedding ruang representasi SimCLR")
plt.tight_layout()
plt.show()
Output:
linear probe accuracy: 1.000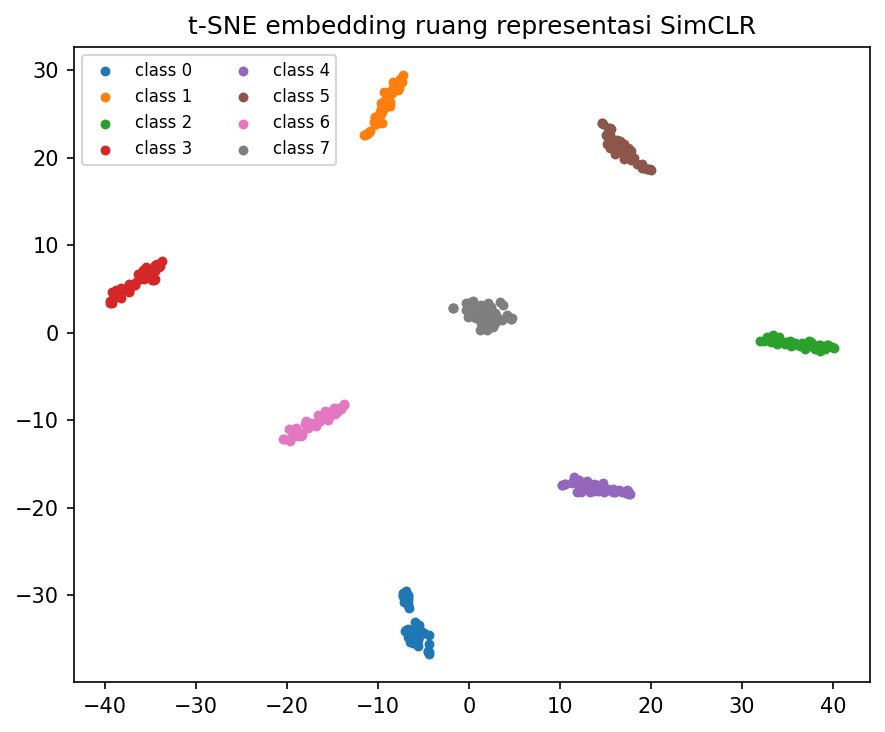
Gambar: hasil t-SNE dari encoder SimCLR setelah 10 epoch pada data sintetis. Setiap warna mewakili satu kelas.
Fungsi extract_embeddings memanggil model.encoder, bukan model.head. Perbedaan ini penting: head hanya alat bantu training dan tidak dipakai saat inference. Encoder dibekukan dengan requires_grad = False agar probe tidak mengubah representasi.
Hasil pada data sintetis adalah akurasi 1.000 dan delapan cluster yang terpisah pada plot t-SNE. Cluster rapat menandakan encoder berhasil memisahkan faktor variasi antar kelas. Cluster yang tersebar acak biasanya menandakan learning rate terlalu besar, augmentasi terlalu agresif, atau training belum cukup.
Akurasi sempurna pada data sintetis mudah dicapai karena sinyal warnanya jelas. Pada data nyata, ekspektasi realistis berada jauh di bawah angka tersebut. t-SNE juga hanya alat inspeksi visual, bukan metrik kuantitatif.
Praktik yang Menentukan Keberhasilan Training SimCLR
Batch size menentukan jumlah negatif dalam satu matriks. Batch yang lebih besar memberi estimasi loss lebih stabil, tetapi biaya memori naik. Saat GPU terbatas, kita dapat memakai gradient accumulation atau memory queue seperti pada MoCo sebagai kompromi yang lazim.
Temperature yang umum dipakai berada di rentang 0.1 sampai 0.2. Nilai terlalu kecil membuat training sensitif terhadap negatif sulit, sedangkan nilai terlalu besar melemahkan pemisahan. Komposisi augmentasi juga menentukan: kombinasi crop dan color jitter memberi sinyal paling kuat, sementara augmentasi berlebihan merusak pasangan positif.
Optimizer Adam atau LAMB dengan warmup membantu stabilitas pada batch besar. Kesalahan umum meliputi memakai output projection head untuk downstream task, lupa normalisasi L2 sebelum menghitung similarity, dan mencampur view dari gambar berbeda. Pemantauan sebaiknya mencakup kurva loss, akurasi linear probe secara periodik, dan konsistensi embedding antara pasangan positif.
Jika ingin membangun pipeline representation learning pada dataset nyata dengan pendampingan langsung, program Deep Learning di Rumah Coding menyediakan jalur latihan yang terstruktur. Materi mencakup penulisan training loop PyTorch, evaluasi embedding, sampai penyusunan eksperimen self-supervised learning. Lihat kurikulum dan jadwal terbaru di rumahcoding.co.id.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.