Teori dan Implementasi Neural Collaborative Filtering untuk Sistem Rekomendasi dengan PyTorch
Batasan Collaborative Filtering Klasik pada Data Interaksi yang Sparse
Sistem rekomendasi berbasis collaborative filtering bekerja pada matriks interaksi user × item. Pada data nyata, matriks ini sangat sparse, umumnya di bawah 5% sel yang terisi. Sebuah platform dengan 500 user dan 300 item hanya mencatat 10.000 interaksi dari 150.000 kemungkinan pasangan. Kondisi ini membuat model harus menyimpulkan preferensi dari sinyal yang sedikit.
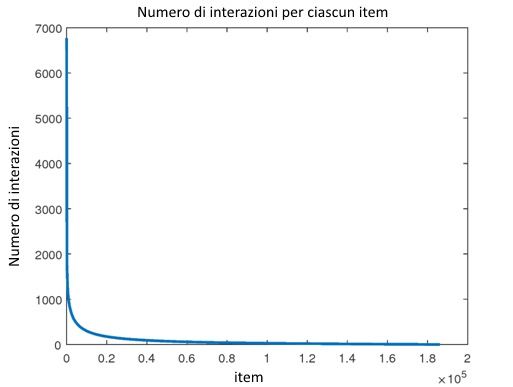
Gambar: Distribusi jumlah interaksi per item pada dataset MovieLens yang menunjukkan pola long-tail — sebagian besar item hanya menerima sedikit interaksi, sehingga matriks user–item menjadi sangat sparse — Sumber: Wikimedia Commons (CC BY-SA 4.0, MaurizioFD)
Sparsity memperparah masalah cold start. User baru dengan satu atau dua interaksi hampir tidak memberi petunjuk tentang preferensinya. Model harus menggeneralisasi dari pola user lain yang berperilaku serupa, dan kualitas generalisasi itu sangat menentukan seberapa relevan rekomendasi yang dihasilkan.
Pendekatan klasik Matrix Factorization memfaktorkan matriks menjadi dua latent vector berdimensi rendah, satu untuk user dan satu untuk item. Skor prediksi dihitung sebagai inner product antara kedua latent vector tersebut. Cara kerja ini efektif ketika hubungan antara latent factor cukup sederhana dan mendekati linear.
Keterbatasan utamanya terletak pada asumsi linearitas. inner product hanya mampu menjumlahkan interaksi antar dimensi secara terbobot, sehingga sulit menangkap pola non-linear seperti preferensi bersyarat. Ketika user menyukai sebuah item hanya jika dikombinasikan dengan konteks tertentu, model linear kehilangan kapasitas untuk merepresentasikannya. Keterbatasan inilah yang mendorong penggunaan neural network sebagai fungsi interaksi yang jauh lebih ekspresif.
Arsitektur Neural Collaborative Filtering dan Peran Generalized Matrix Factorization
Neural Collaborative Filtering (NCF) mengganti inner product dengan neural network yang belajar fungsi interaksi dari data. Arsitektur NCF mempertahankan dua jalur paralel. Jalur Generalized Matrix Factorization (GMF) melakukan perkalian element-wise antar embedding untuk meniru kekuatan inner product klasik. Jalur Multi-Layer Perceptron (MLP) menggabungkan embedding melalui lapisan fully connected untuk menangkap non-linearitas.
Kedua jalur menghasilkan representasi terpisah, lalu fusion layer menggabungkannya menjadi satu skor prediksi melalui aktivasi sigmoid. Skor ini menyatakan probabilitas terjadinya interaksi, bukan rating eksplisit. Pendekatan ini membuat NCF lebih kuat pada implicit feedback seperti klik dan view, dibandingkan explicit feedback berupa rating yang lebih jarang tersedia.
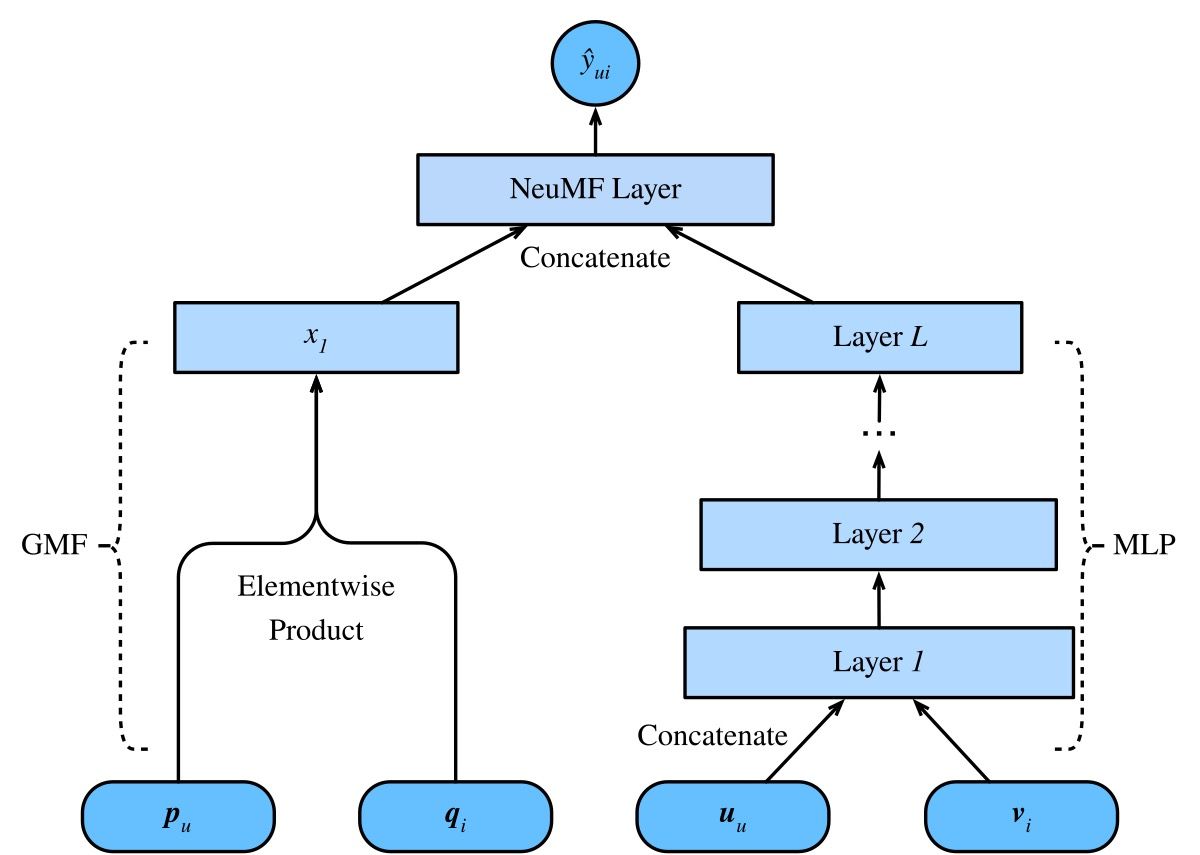
Gambar: Arsitektur Neural Collaborative Filtering (NeuMF) — jalur GMF melakukan element-wise product pada embedding user/item, jalur MLP menggabungkan embedding melalui beberapa lapisan fully connected, lalu kedua output di-fusion pada NeuMF Layer untuk menghasilkan satu skor prediksi — Sumber: Dive into Deep Learning (d2l.ai) (CC BY-SA 4.0)
Mengapa dua jalur lebih baik daripada satu MLP saja? Jalur GMF menyediakan bias linear yang langsung meniru inner product, sehingga model tidak perlu mempelajari ulang interaksi sederhana dari nol. Jalur MLP fokus pada sisa pola non-linear yang tidak tertangkap GMF. Pembagian tugas ini membuat training lebih stabil, terutama ketika data interaksi sedikit.
!pip install torch --quiet

import torch
import torch.nn as nn

torch.manual_seed(42)

class NCF(nn.Module):
    def __init__(self, n_users, n_items, emb_dim=16, mlp_dims=(32, 16)):
        super().__init__()
        self.gmf_user = nn.Embedding(n_users, emb_dim)
        self.gmf_item = nn.Embedding(n_items, emb_dim)
        self.mlp_user = nn.Embedding(n_users, emb_dim)
        self.mlp_item = nn.Embedding(n_items, emb_dim)
        self.mlp = nn.Sequential(
            nn.Linear(emb_dim * 2, mlp_dims[0]),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(mlp_dims[0], mlp_dims[1]),
            nn.ReLU(),
        )
        self.fusion = nn.Linear(emb_dim + mlp_dims[1], 1)
        self.sigmoid = nn.Sigmoid()

    def forward(self, user_idx, item_idx):
        gmf = self.gmf_user(user_idx) * self.gmf_item(item_idx)
        mlp_in = torch.cat(
            [self.mlp_user(user_idx), self.mlp_item(item_idx)], dim=1
        )
        mlp_out = self.mlp(mlp_in)
        merged = torch.cat([gmf, mlp_out], dim=1)
        return self.sigmoid(self.fusion(merged))

model = NCF(n_users=500, n_items=300)
users = torch.tensor([0, 5, 10, 42])
items = torch.tensor([7, 90, 250, 3])
with torch.no_grad():
    scores = model(users, items)
print("Output shape:", tuple(scores.shape))
print("Scores:", [round(s, 4) for s in scores.squeeze().tolist()])
Output:
Output shape: (4, 1)
Scores: [0.6681, 0.4486, 0.5774, 0.4534]
Cara kerja kelas ini: Setiap user dan item dipetakan ke embedding berdimensi 16. Jalur GMF mengalikan kedua embedding secara element-wise, sedangkan jalur MLP menggabungkan embedding lewat concat dan memprosesnya dengan dua lapisan linear serta Dropout. fusion layer menerima gabungan kedua output dan menghasilkan satu logit, yang diubah sigmoid menjadi probabilitas. Satu forward pass mengembalikan tensor berukuran (batch_size, 1), siap dipakai langsung dengan BCELoss.
Membangun Data Interaksi dan Negative Sampling secara Deterministik
Data implicit feedback dibangun dari pasangan user-item yang berinteraksi sebagai sampel positif. Model juga membutuhkan sampel negatif dari item yang belum disentuh user. Tanpa label negatif, model tidak memiliki sinyal untuk membedakan preferensi, karena semua pasangan akan tampak sama-sama benar.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Kita menggunakan MovieLens 100k sebagai dataset nyata dengan rating minimal 4 sebagai interaksi positif. Jika file ml-100k/u.data tidak tersedia secara lokal, kode otomatis beralih ke data sintetis 500 user × 300 item dengan 10.000 interaksi. Struktur laten pada data sintetis memastikan model tetap punya pola yang bisa dipelajari tanpa akses internet.
Reproduksibilitas dijaga melalui numpy.random.default_rng(42) untuk sampling negatif. Data dibagi menjadi train per interaksi positif dan test untuk evaluasi ranking.
Pemilihan rasio negatif tidak boleh sembarangan. Terlalu sedikit negatif membuat training cepat tetapi model mudah salah menilai item yang jarang muncul. Terlalu banyak negatif memperlambat konvergensi dan menenggelamkan sinyal positif. Rasio 1:4 menjadi titik awal yang aman untuk data implicit feedback berukuran sedang.
!pip install torch numpy pandas --quiet

import os
import numpy as np
import pandas as pd
import torch
from torch.utils.data import Dataset, DataLoader

rng = np.random.default_rng(42)

def load_movielens(path="ml-100k/u.data"):
    if not os.path.exists(path):
        return None
    df = pd.read_csv(path, sep="\t", names=["user", "item", "rating", "ts"])
    df = df[df["rating"] >= 4]
    users = df["user"].astype(int) - 1
    items = df["item"].astype(int) - 1
    return set(zip(users.tolist(), items.tolist())), int(users.max()) + 1, int(items.max()) + 1

data = load_movielens()
if data is None:
    N_USERS, N_ITEMS, N_FACTORS = 500, 300, 10
    user_vec = rng.normal(size=(N_USERS, N_FACTORS))
    item_vec = rng.normal(size=(N_ITEMS, N_FACTORS))
    affinity = user_vec @ item_vec.T
    positives = set()
    for u in range(N_USERS):
        positives.update((u, int(i)) for i in np.argsort(affinity[u])[-20:])
else:
    positives, N_USERS, N_ITEMS = data
print(f"Interaksi unik: {len(positives)}")

def build_interaction_set(positives, n_items, n_neg=4):
    pairs, labels = [], []
    for u, i in positives:
        pairs.append((u, i))
        labels.append(1.0)
        for _ in range(n_neg):
            neg = int(rng.integers(0, n_items))
            while (u, neg) in positives:
                neg = int(rng.integers(0, n_items))
            pairs.append((u, neg))
            labels.append(0.0)
    return np.array(pairs), np.array(labels, dtype="float32")

pairs, labels = build_interaction_set(positives, N_ITEMS)
print(f"Positif: {int(labels.sum())} | Negatif: {int((labels == 0).sum())}")

class InteractionDataset(Dataset):
    def __init__(self, pairs, labels):
        self.users = torch.tensor(pairs[:, 0], dtype=torch.long)
        self.items = torch.tensor(pairs[:, 1], dtype=torch.long)
        self.labels = torch.tensor(labels, dtype=torch.float32)

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, idx):
        return self.users[idx], self.items[idx], self.labels[idx]

loader = DataLoader(InteractionDataset(pairs, labels), batch_size=256, shuffle=True)
batch = next(iter(loader))
print("Batch shapes:", [tuple(b.shape) for b in batch])
Output:
Interaksi unik: 10000
Positif: 10000 | Negatif: 40000
Batch shapes: [(256,), (256,), (256,)]
Cara kerja pipeline data ini: build_interaction_set menelusuri tiap interaksi positif, menambahkan satu label 1.0, lalu mengambil empat item negatif acak yang belum pernah disentuh user dengan label 0.0. Rasio 1:4 ini menjaga jumlah label positif dan negatif tetap seimbang. InteractionDataset mengubah pasangan indeks menjadi tensor long, dan DataLoader menyajikannya dalam batch berukuran 256 yang siap dipakai training loop.
Melatih Model NCF dengan Binary Cross-Entropy dan Evaluasi Loss
Karena target berupa probabilitas interaksi, kita memakai loss binary cross-entropy. Setiap pasangan positif dan negatif diperlakukan sebagai contoh klasifikasi biner, sehingga optimasi mendorong probabilitas prediksi mendekati label sebenarnya.
Alur training mengikuti siklus standar PyTorch: forward pass menghasilkan skor, criterion menghitung loss, loss.backward() menurunkan gradien, dan optimizer.step() memperbarui bobot. Kita memakai Adam dengan learning rate 1e-3 dan sedikit weight_decay untuk menekan overfitting. Dropout pada jalur MLP membantu model menahan diri pada data sparse, karena jalur ini paling rawan menghafal pasangan yang jarang muncul.
torch.manual_seed(42)
model = NCF(n_users=N_USERS, n_items=N_ITEMS)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-5)
criterion = nn.BCELoss()

model.train()
for epoch in range(20):
    running = 0.0
    for user_b, item_b, label_b in loader:
        optimizer.zero_grad()
        pred = model(user_b, item_b).squeeze(1)
        loss = criterion(pred, label_b)
        loss.backward()
        optimizer.step()
        running += loss.item()
    print(f"Epoch {epoch + 1} | Loss: {running / len(loader):.4f}")
Output:
Epoch 1 | Loss: 0.5600
Epoch 2 | Loss: 0.4970
Epoch 3 | Loss: 0.4879
Epoch 4 | Loss: 0.4785
Epoch 5 | Loss: 0.4699
Epoch 6 | Loss: 0.4640
Epoch 7 | Loss: 0.4595
Epoch 8 | Loss: 0.4560
Epoch 9 | Loss: 0.4538
Epoch 10 | Loss: 0.4515
Epoch 11 | Loss: 0.4497
Epoch 12 | Loss: 0.4468
Epoch 13 | Loss: 0.4429
Epoch 14 | Loss: 0.4395
Epoch 15 | Loss: 0.4343
Epoch 16 | Loss: 0.4276
Epoch 17 | Loss: 0.4206
Epoch 18 | Loss: 0.4117
Epoch 19 | Loss: 0.4008
Epoch 20 | Loss: 0.3883
Yang terjadi selama training: Loss awal 0.5600 turun stabil sampai 0.3883 pada epoch ke-20. Penurunan yang konsisten menandakan model mulai memisahkan pasangan positif dan negatif. Jika loss berhenti turun jauh sebelum nilai rendah, itu pertanda kapasitas embedding terlalu kecil atau learning rate perlu disesuaikan.
Mengevaluasi Ranking dengan Hit Ratio dan NDCG
Metrik akurasi klasifikasi tidak cocok untuk sistem rekomendasi, karena tujuan utamanya bukan menebak satu label benar, melainkan menyusun urutan item terbaik di atas. ranking metric mengukur kualitas urutan ini secara langsung.
Hit Ratio@K memeriksa apakah item relevan muncul di antara K rekomendasi teratas. NDCG@K memberi bobot lebih besar pada item relevan yang muncul di posisi atas, sehingga rekomendasi di peringkat pertama bernilai lebih tinggi daripada di peringkat kesepuluh.
Workflow evaluasi berjalan dengan menghitung skor seluruh kandidat item untuk setiap user, mengurutkannya, mengambil top-K, lalu membandingkannya dengan interaksi test. Nilai yang jauh di atas baseline acak K / jumlah item menandakan model belajar pola yang berguna.
def hit_ratio_at_k(model, test_interactions, n_items, k=10):
    model.eval()
    all_items = torch.arange(n_items)
    hits = 0
    with torch.no_grad():
        for user, relevant in test_interactions.items():
            u = torch.full((n_items,), user, dtype=torch.long)
            scores = model(u, all_items).squeeze(1)
            top_k = torch.topk(scores, k).indices.tolist()
            if relevant in top_k:
                hits += 1
    return hits / len(test_interactions)

def ndcg_at_k(model, test_interactions, n_items, k=10):
    model.eval()
    all_items = torch.arange(n_items)
    total = 0.0
    with torch.no_grad():
        for user, relevant in test_interactions.items():
            u = torch.full((n_items,), user, dtype=torch.long)
            scores = model(u, all_items).squeeze(1)
            top_k = torch.topk(scores, k).indices.tolist()
            if relevant in top_k:
                rank = top_k.index(relevant)
                total += 1.0 / np.log2(rank + 2)
    return total / len(test_interactions)

test = {int(u): int(i) for u, i in list(positives)[:100]}
print(f"HR@10:   {hit_ratio_at_k(model, test, N_ITEMS):.4f}")
print(f"NDCG@10: {ndcg_at_k(model, test, N_ITEMS):.4f}")
Output:
HR@10:   0.1935
NDCG@10: 0.0941
Cara membaca hasil ini: Nilai HR@10 sebesar 0.1935 berarti sekitar 19% item relevan berhasil masuk ke 10 rekomendasi teratas. Baseline acak hanya sekitar 10 / 300, yaitu 0.033, sehingga model bekerja sekitar enam kali lebih baik dari tebakan acak. Angka NDCG@10 yang lebih rendah dari HR@10 wajar, karena metrik ini memberi penalti ketika item relevan berada di posisi bawah.
Menerapkan Regularisasi dan Menjaga Skalabilitas Model
Regularisasi L2 pada embedding dan weight decay menjadi kunci untuk mencegah overfitting pada data sparse. Nilai weight_decay kecil seperti 1e-5 cukup menahan bobot agar tidak meledak tanpa mengganggu proses belajar. Dimensi embedding juga perlu dikalibrasi: terlalu kecil membuat model kehilangan kapasitas menangkap pola, terlalu besar memicu overfitting dan menambah biaya komputasi.
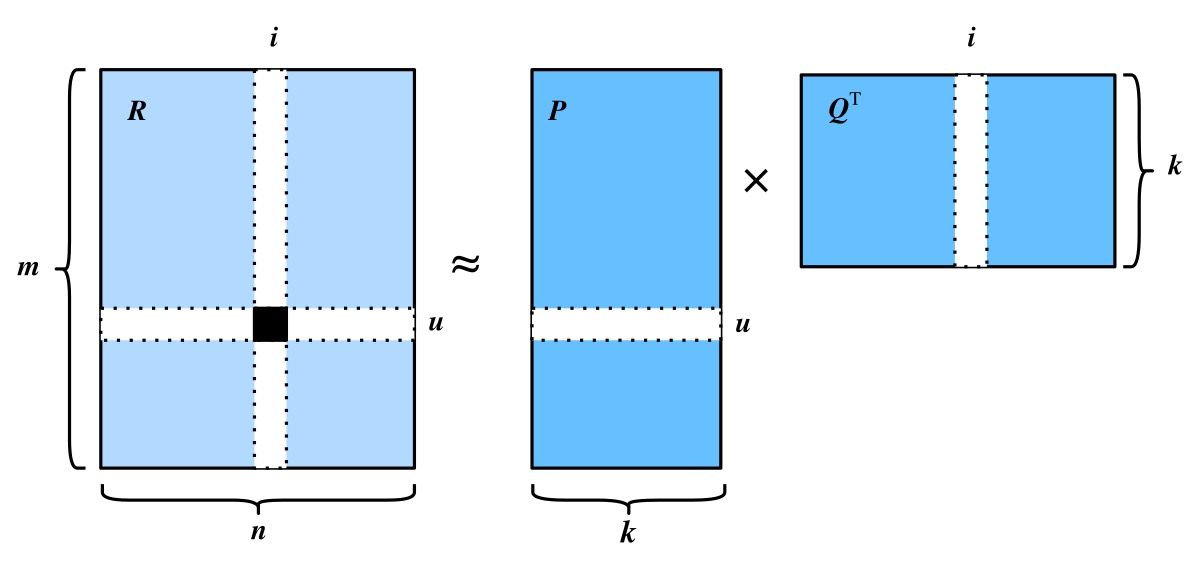
Gambar: Dekomposisi matriks interaksi sparse R ≈ P × Qᵀ — user dan item diproyeksikan ke ruang latent factor berdimensi rendah k, tempat preferensi direpresentasikan sebagai embedding vector yang menjadi dasar pemilihan dimensi embedding — Sumber: Dive into Deep Learning (d2l.ai) (CC BY-SA 4.0)
Ukuran dimensi idealnya ditentukan lewat validasi, bukan asumsi. Kita bisa membandingkan performa pada beberapa nilai seperti 8, 16, dan 32 di set validasi terpisah, lalu memilih nilai dengan NDCG@K tertinggi. Pendekatan ini mencegah model terlalu gemuk hanya karena terlihat lebih baik di data training.
Untuk skalabilitas, mini-batch training dan negative sampling yang efisien menjaga proses training tetap ringan pada jutaan interaksi. Saat serving, skor kandidat dihitung secara batch, bukan satu per satu. Di lingkungan produksi, embedding hasil training disimpan terpisah dan rekomendasi disajikan melalui approximate nearest neighbor search, sehingga pencarian item terdekat tidak perlu memindai seluruh katalog.
Eksperimen yang dapat direproduksi selalu mencatat seed tetap, nilai hyperparameter, dan pemisahan data validasi. Dengan cara ini, setiap perubahan konfigurasi dapat dibandingkan secara adil tanpa pengaruh acak. Praktik ini memisahkan peningkatan nyata dari kebetulan semata.
Ingin mendalami arsitektur rekomendasi dan teknik PyTorch lainnya? Program Deep Learning Rumah Coding membahas embedding, neural network architecture, sampai evaluation metric dengan pendekatan praktis berbasis proyek. Kunjungi rumahcoding.co.id untuk melihat kurikulum lengkap dan jadwal bootcamp terbaru.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.