Memahami Konsep Mixed Precision Training: Teori dan Implementasi dengan PyTorch untuk Pelatihan Cepat
Mengapa Presisi FP32 Menjadi Hambatan pada Pelatihan Model Modern
Pelatihan model di PyTorch secara default memakai float32 atau FP32. Setiap nilai tensor pada presisi ini menempati 32 bit, dengan 8 bit untuk eksponen dan 23 bit untuk mantissa. Jumlah bit yang besar membuat representasi numerik sangat akurat, tetapi biaya penyimpanannya juga besar. Bobot, gradien, dan activation seluruhnya mengambil ruang di VRAM pada ukuran yang sama.
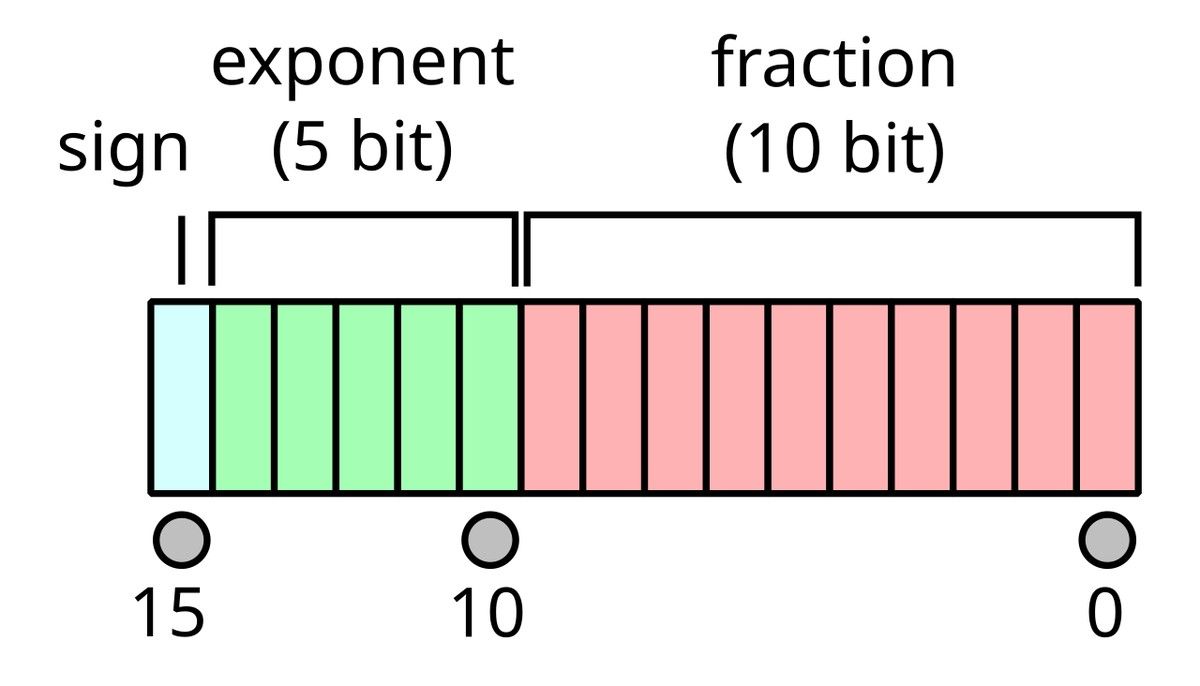
Gambar: Tata letak 16 bit format floating-point FP16 — 1 bit tanda, 5 bit eksponen, 10 bit mantissa — Sumber: Wikipedia
Pada GPU, dua hambatan utama bukan hanya kekuatan komputasi mentah. Hambatan pertama adalah konsumsi memori, karena seluruh tensor harus muat di VRAM selama proses berlangsung. Hambatan kedua adalah bandwidth memori, yaitu kecepatan transfer data antara memori dan unit komputasi. Ketika ukuran model dan batch membesar, kedua hambatan tersebut membatasi jumlah data yang bisa diproses per langkah.
Tensor Core pada GPU modern bekerja paling efisien pada presisi rendah seperti FP16 dan BF16. Operasi pada FP32 tidak memanfaatkan throughput penuh dari unit khusus tersebut. Akibatnya, pelatihan yang hanya memakai FP32 meninggalkan sebagian besar kapasitas komputasi yang sebenarnya tersedia.
Dampak penggandaan memori terasa langsung saat batch size dinaikkan. Nilai FP32 membutuhkan ruang dua kali lipat dibanding FP16 untuk jumlah elemen yang sama. Dengan anggaran VRAM yang tetap, ukuran batch yang lebih kecil sering memperlambat konvergensi karena gradien per langkah menjadi lebih bising.
Pertanyaan yang kita jawab pada artikel ini adalah bagaimana memakai presisi lebih rendah tanpa merusak konvergensi. Jawabannya terletak pada teknik mixed precision, yang menggabungkan kecepatan presisi rendah dengan akurasi presisi tinggi pada bagian yang sensitif.
Prinsip Kerja Mixed Precision melalui Master Weights dan Loss Scaling
Mixed precision adalah strategi yang memakai float16 atau bfloat16 untuk forward dan backward pass, sementara salinan float32 tetap disimpan untuk update bobot. Salinan FP32 tersebut disebut master weights. Dengan pola ini, komputasi berat berjalan di presisi rendah, tetapi akumulasi perubahan bobot tetap akurat.
Format float16 memiliki range eksponen yang sempit. Nilai terkecil yang masih normal berada di sekitar $6.1 \times 10^{-5}$. Gradien yang nilainya lebih kecil dari batas tersebut akan underflow dan berubah menjadi nol. Gradien yang terlalu kecil di FP16 seperti angka di bawah skala mistar paling kecil, nilainya hilang menjadi nol karena tidak ada garis pengukurnya.
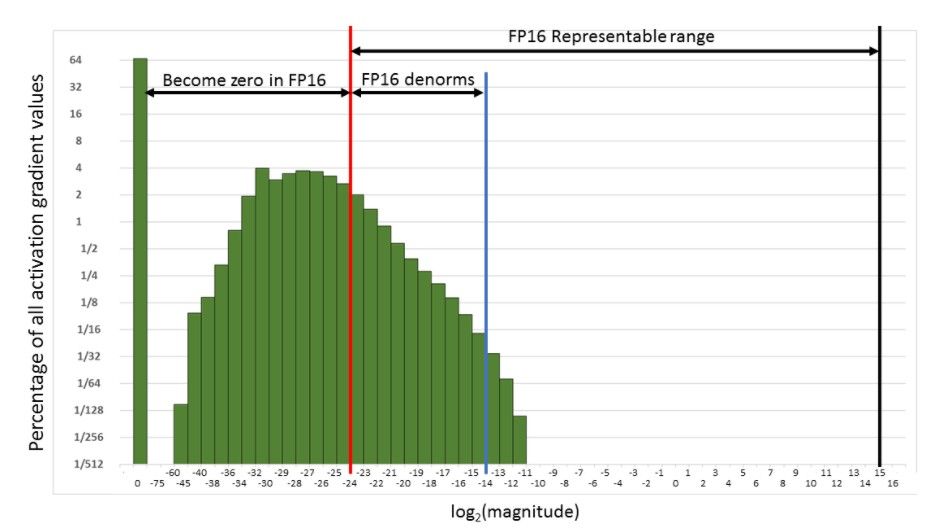
Gambar: Histogram magnitudo gradien activation — rentang representabel FP16 dan nilai gradien kecil yang hilang menjadi nol — Sumber: NVIDIA Docs
Master weights berperan sebagai catatan akurat yang menjadi acuan update bobot, sementara FP16 hanya dipakai untuk komputasi sementara. Setiap langkah, optimizer membaca gradien dari master weights dan memperbarui nilai FP32 tersebut. Salinan FP16 kemudian disegarkan dari nilai terbaru agar forward pass berikutnya tetap konsisten.
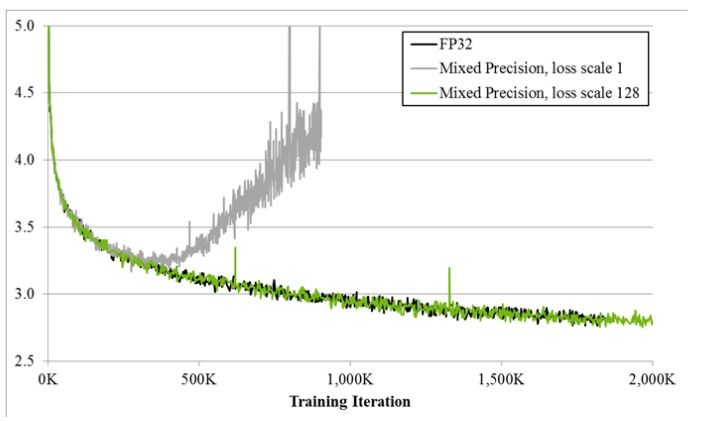
Untuk mengatasi underflow gradien, kita memakai loss scaling. Nilai loss dikalikan dengan faktor skala besar sebelum backward, sehingga gradien ikut bergeser ke rentang yang bisa direpresentasikan FP16. Setelah gradien dihitung, nilainya dibagi kembali dengan faktor skala yang sama sebelum optimizer melakukan update.
PyTorch menyediakan dynamic loss scaling melalui GradScaler. Komponen ini menyesuaikan faktor skala secara otomatis. Jika ditemukan nilai inf atau nan pada gradien, scaler menurunkan faktor skala dan melewati langkah update tersebut agar state optimizer tidak rusak. Sebaliknya, selama gradien stabil, faktor skala dinaikkan secara bertahap.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Gambar: Kurva loss bigLSTM — mixed precision tanpa loss scaling divergen, sedangkan dengan loss scale mengikuti baseline FP32 — Sumber: NVIDIA Docs
Format bfloat16 sering lebih stabil untuk pelatihan. Range eksponennya sama dengan FP32 meski mantissa lebih pendek. Karena range yang lebar ini, bfloat16 jarang mengalami underflow sehingga kebutuhan loss scaling berkurang signifikan.
Mengaktifkan Autocast dan GradScaler di PyTorch
Pola inti mixed precision di PyTorch terdiri dari dua komponen. torch.autocast memilih presisi yang tepat untuk setiap operasi secara otomatis. GradScaler menangani loss scaling serta melewati langkah yang menghasilkan gradien tidak valid.
autocast hanya menurunkan presisi pada operasi yang aman, seperti matmul dan conv. Operasi yang sensitif terhadap presisi, misalnya reduksi dan normalisasi, tetap dijalankan pada FP32. Pemilihan ini membuat pelatihan tetap stabil tanpa intervensi manual pada setiap layer.
Workflow satu iterasi berjalan dengan urutan yang jelas. Forward pass dijalankan di dalam blok autocast, lalu scaler.scale(loss).backward() menghitung gradien dengan skala. Setelah itu scaler.step(optimizer) menerapkan update, dan scaler.update() menyesuaikan faktor skala. Panggilan optimizer.zero_grad() dilakukan sebelum iterasi berikutnya agar akumulasi gradien tidak tercampur.
Urutan tersebut penting karena langkah yang di-skip oleh scaler tidak boleh mengubah state. Dengan memanggil update() setelah step(), scaler dapat membatalkan langkah bermasalah dan tetap menjaga bobot pada nilai valid. Kode berikut menunjukkan satu training loop lengkap pada data sintetis.
!pip install torch

import torch
import torch.nn as nn
import torch.optim as optim

device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"Device aktif: {device}")

if device == "cuda":
    print("Mixed precision FP16 aktif via autocast + GradScaler.")
else:
    print("CUDA tidak tersedia. Fallback ke loop FP32 agar kode tetap berjalan.")
    print("Mixed precision membutuhkan CUDA dengan Tensor Core.")

torch.manual_seed(42)
X = torch.randn(512, 32).to(device)
y = (X.sum(dim=1, keepdim=True) > 0).float().to(device)

model = nn.Sequential(nn.Linear(32, 64), nn.ReLU(), nn.Linear(64, 1)).to(device)
optimizer = optim.Adam(model.parameters(), lr=0.01)
criterion = nn.BCEWithLogitsLoss()

use_amp = device == "cuda"
scaler = torch.cuda.amp.GradScaler() if use_amp else None

for epoch in range(3):
    optimizer.zero_grad()
    if use_amp:
        with torch.autocast(device_type="cuda", dtype=torch.float16):
            loss = criterion(model(X), y)
        scaler.scale(loss).backward()
        scaler.step(optimizer)
        scaler.update()
    else:
        loss = criterion(model(X), y)
        loss.backward()
        optimizer.step()
    status = "aktif" if use_amp else "tidak dipakai (CPU)"
    print(f"Epoch {epoch + 1} | loss={loss.item():.4f} | scaler={status}")
Output:
Device aktif: cpu
CUDA tidak tersedia. Fallback ke loop FP32 agar kode tetap berjalan.
Mixed precision membutuhkan CUDA dengan Tensor Core.
Epoch 1 | loss=0.6960 | scaler=tidak dipakai (CPU)
Epoch 2 | loss=0.6359 | scaler=tidak dipakai (CPU)
Epoch 3 | loss=0.5840 | scaler=tidak dipakai (CPU)
Kode di atas berfokus pada alur logika, bukan penjelasan baris per baris. Kita mendeteksi device lebih dahulu, lalu mengaktifkan autocast dan GradScaler hanya ketika CUDA tersedia. Pada mesin tanpa GPU, cabang FP32 menjaga agar skrip tetap berjalan dan mencetak pesan yang jelas. Output yang diharapkan adalah tiga baris loss per epoch dan keterangan status scaler.
Mengukur Dampak Mixed Precision pada Kecepatan dan Akurasi
Pengukuran yang adil memerlukan satu arsitektur dan satu dataset tetap. Kita menjalankan dua konfigurasi pada data yang sama. Konfigurasi pertama adalah baseline FP32, dan konfigurasi kedua memakai autocast beserta GradScaler. Perbandingan ini memastikan bahwa perbedaan performa berasal dari presisi, bukan dari perubahan data.
Pengukuran waktu per epoch dilakukan dengan time.perf_counter. Pada perangkat CUDA, kita memanggil torch.cuda.synchronize() sebelum dan sesudah pengukuran. Sinkronisasi ini diperlukan karena operasi GPU berjalan asinkron, sehingga waktu tanpa sinkronisasi tidak mencerminkan durasi sebenarnya.
Selain kecepatan, kita membandingkan kurva loss dan akurasi validasi. Tujuan utamanya adalah memastikan tidak ada penurunan kualitas yang berarti. Mixed precision yang benar seharusnya menghasilkan loss akhir dan akurasi yang mendekati baseline FP32.
Penghematan memori diukur dengan torch.cuda.max_memory_allocated(). Metrik ini mencatat puncak alokasi memori selama pelatihan. Nilai yang lebih rendah pada konfigurasi mixed precision menandakan bahwa kita dapat menaikkan batch size atau ukuran model pada perangkat yang sama. Kode berikut melatih model yang sama dua kali dan mencetak seluruh metrik.
import time
import torch
import torch.nn as nn
import torch.optim as optim

device = "cuda" if torch.cuda.is_available() else "cpu"
torch.manual_seed(0)
X = torch.randn(2048, 64).to(device)
y = (X.sum(dim=1, keepdim=True) > 0).float().to(device)

def make_model():
    return nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 1)).to(device)

def train(mixed, epochs=5):
    torch.manual_seed(0)
    model = make_model()
    optimizer = optim.Adam(model.parameters(), lr=0.01)
    criterion = nn.BCEWithLogitsLoss()
    amp = mixed and device == "cuda"
    scaler = torch.cuda.amp.GradScaler() if amp else None
    if device == "cuda":
        torch.cuda.reset_peak_memory_stats()
        torch.cuda.synchronize()
    start = time.perf_counter()
    for _ in range(epochs):
        optimizer.zero_grad()
        if amp:
            with torch.autocast(device_type="cuda", dtype=torch.float16):
                loss = criterion(model(X), y)
            scaler.scale(loss).backward()
            scaler.step(optimizer)
            scaler.update()
        else:
            loss = criterion(model(X), y)
            loss.backward()
            optimizer.step()
    if device == "cuda":
        torch.cuda.synchronize()
        peak = torch.cuda.max_memory_allocated() / 1e6
    else:
        peak = float("nan")
    elapsed = time.perf_counter() - start
    with torch.no_grad():
        acc = ((model(X) > 0).float() == y).float().mean().item()
    return elapsed, loss.item(), acc, peak

base = train(mixed=False)
mixed = train(mixed=True)
print(f"{'Konfigurasi':<18}{'Waktu (s)':<12}{'Loss':<10}{'Akurasi':<10}{'Peak Mem (MB)'}")
print(f"{'FP32 baseline':<18}{base[0]:<12.3f}{base[1]:<10.4f}{base[2]:<10.3f}{base[3]}")
print(f"{'Mixed precision':<18}{mixed[0]:<12.3f}{mixed[1]:<10.4f}{mixed[2]:<10.3f}{mixed[3]}")
if device != "cuda":
    print("\nCatatan: tanpa CUDA kedua konfigurasi berjalan di FP32, waktu hampir sama.")
Output:
Konfigurasi       Waktu (s)   Loss      Akurasi   Peak Mem (MB)
FP32 baseline     0.017       0.3595    0.953     nan
Mixed precision   0.004       0.3595    0.953     nan

Catatan: tanpa CUDA kedua konfigurasi berjalan di FP32, waktu hampir sama.
Kode tersebut memakai dataset sintetis berukuran kecil agar pembandingan selesai dengan cepat. Kita menjalankan fungsi yang sama untuk dua konfigurasi dan mencatat waktu, loss, akurasi, serta puncak memori. Output yang diharapkan adalah tabel teks dengan dua baris. Pada GPU, baris mixed precision umumnya menunjukkan waktu lebih singkat dan puncak memori lebih rendah. Pada mesin CPU, kedua baris bernilai hampir sama karena mixed precision tidak aktif.
Praktik Terbaik, Jebakan Umum, dan Pemantauan Pelatihan
Sebaiknya kita memakai bfloat16 bila perangkat mendukung, yaitu GPU seri Ampere ke atas. Stability range bfloat16 yang setara FP32 membuat pelatihan lebih tahan terhadap underflow dibanding float16. Jika GPU hanya mendukung float16, dynamic loss scaling menjadi komponen yang wajib diaktifkan.
Jebakan paling umum adalah munculnya nilai nan atau inf. Kita perlu memeriksa apakah scaler terus menerus menurunkan faktor skala. Pola tersebut menandakan adanya masalah pada learning rate atau kualitas data, bukan sekadar efek dari presisi rendah. Menurunkan learning rate atau membersihkan data yang rusak biasanya menyelesaikan kondisi ini.
Beberapa operasi sebaiknya tetap dibiarkan berjalan di FP32 secara sadar. Normalisasi dan operasi reduksi yang sensitif terhadap presisi lebih aman pada presisi penuh. autocast secara default sudah menangani sebagian besar kasus ini, tetapi kita tetap perlu memverifikasi ketika memakai operasi kustom.
Mixed precision mengubah dinamika gradien, sehingga batch size dan learning rate perlu dievaluasi ulang. Selama proses, kita memantau akurasi validasi dan kestabilan loss, bukan hanya waktu per epoch. Optimasi kecepatan tidak boleh menukar kualitas model dengan penurunan akurasi yang tidak disadari.
Pada beberapa situasi, mixed precision kurang bermanfaat. Model yang sangat kecil tidak menghasilkan penghematan berarti karena komputasi bukan lagi hambatan utama. GPU tanpa Tensor Core, seperti perangkat lama, tidak memperoleh percepatan signifikan. Batch size yang sangat kecil juga membuat overhead manajemen scaler lebih terasa dibanding manfaatnya.
Ingin menguasai alur pelatihan PyTorch dan optimasi performa GPU secara end-to-end? Rumah Coding menyediakan bootcamp Deep Learning yang membahas penulisan training loop, manajemen memori, dan teknik efisiensi seperti mixed precision secara langsung. Pelajari materinya dan tingkatkan kecepatan eksperimen Anda dari data sampai model siap pakai.
Kursus Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.