Teori dan Implementasi Diffusion Model untuk Image Generation dengan PyTorch
Mengapa Diffusion Model Bekerja melalui Proses Denoising Bertahap
GAN membangkitkan sampel dalam satu langkah melalui generator yang dilatih melawan discriminator. VAE memampatkan data ke ruang laten lalu melakukan decode. Diffusion model memilih jalur berbeda: data dihancurkan sedikit demi sedikit oleh noise, kemudian satu jaringan dilatih untuk membalik setiap langkah penghancuran tersebut.
Proses membalik noise secara bertahap ini mirip cara kita memulihkan foto buram dengan mengoreksi sedikit demi sedikit, bukan menebak gambar akhir sekaligus.
Keuntungan pendekatan ini terletak pada objective training. Alih-alih menyelesaikan permainan adversarial yang rentan terhadap mode collapse, model hanya perlu memprediksi noise yang ditambahkan pada timestep tertentu. Tugas regresi itu memberi sinyal gradien yang stabil dan mudah dipantau melalui nilai loss.
Harga yang dibayar adalah biaya inference. Satu gambar memerlukan puluhan sampai ratusan forward pass, tergantung jumlah timestep dan sampler yang dipakai. Karena itu riset diffusion model banyak berfokus pada pengurangan jumlah langkah sampling tanpa mengorbankan kualitas.
Artikel ini membangun versi kecil DDPM yang berjalan di CPU. Data yang dipakai berupa titik dua dimensi pada empat cluster, sehingga seluruh proses training dan sampling dapat diamati dalam hitungan detik.
Forward Process dan Noise Schedule sebagai Definisi Masalah
Forward process mendefinisikan bagaimana data bersih x_0 berubah menjadi noise. Pada setiap timestep t, kita menambahkan noise Gaussian dengan varians beta_t. Rangkaian beta_t inilah yang disebut noise schedule.
Karena penambahan noise bersifat Gaussian, proses ini memiliki bentuk closed-form. Nilai x_t dapat dihitung langsung dari x_0 memakai alpha_bar_t, yaitu hasil kali kumulatif dari 1 - beta_t. Kita tidak perlu menjalankan t langkah secara iteratif saat menyiapkan batch training.
Ilustrasi berikut memperlihatkan efek forward process pada satu gambar. Setiap langkah menambah noise, sampai struktur objek hilang dan tersisa noise Gaussian.
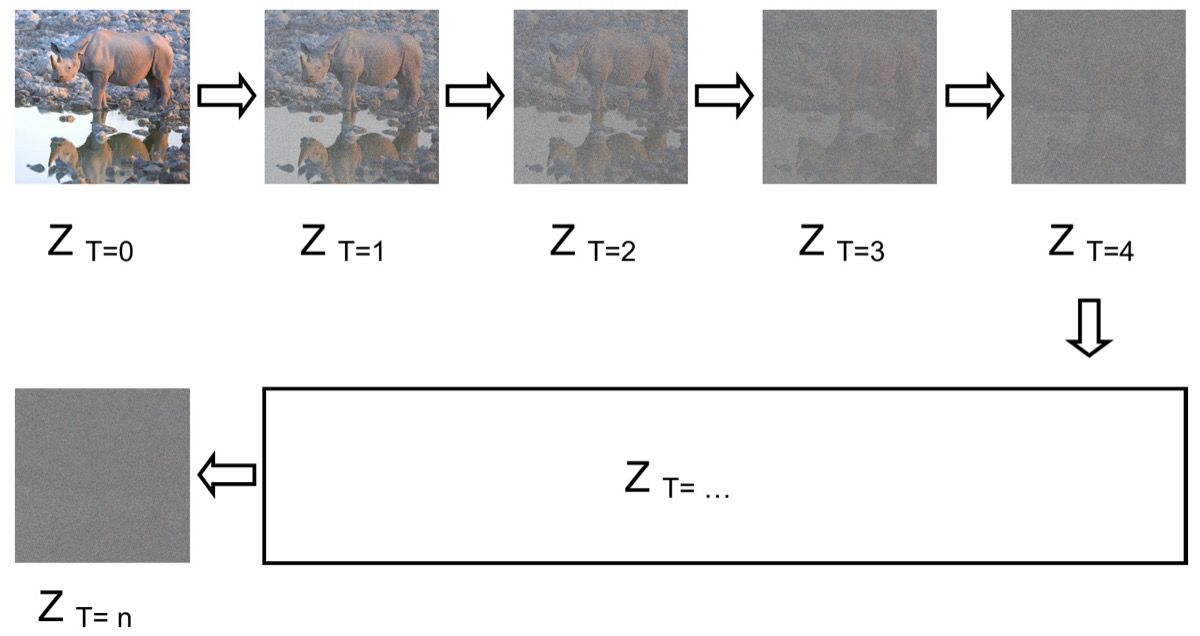
Gambar: contoh forward diffusion pada foto badak, dari `Z_T=0` yang bersih sampai `Z_T=4` yang didominasi noise. Notasi `Z_T` pada sumber setara dengan `x_t` pada notasi DDPM di artikel ini — Sumber: Wikimedia Commons, Example of Forward Diffusion Models — MrAlanKoh, CC BY-SA 4.0
import math
import torch
import matplotlib.pyplot as plt

torch.manual_seed(42)


class LinearNoiseScheduler:
    def __init__(self, num_timesteps=200, beta_start=1e-4, beta_end=0.02):
        self.num_timesteps = num_timesteps
        self.betas = torch.linspace(beta_start, beta_end, num_timesteps)
        self.alphas = 1.0 - self.betas
        self.alpha_bars = torch.cumprod(self.alphas, dim=0)

    def add_noise(self, x_0, noise, t):
        alpha_bar = self.alpha_bars[t].unsqueeze(-1)
        return alpha_bar.sqrt() * x_0 + (1 - alpha_bar).sqrt() * noise

    def sample_timesteps(self, batch_size):
        return torch.randint(0, self.num_timesteps, (batch_size,))


scheduler = LinearNoiseScheduler(num_timesteps=200)
for step in (0, 50, 100, 150, 199):
    print(f"t={step:3d} alpha_bar={scheduler.alpha_bars[step]:.5f}")
Output:
t=  0 alpha_bar=0.99990
t= 50 alpha_bar=0.87562
t=100 alpha_bar=0.59640
t=150 alpha_bar=0.31555
t=199 alpha_bar=0.13218
Nilai alpha_bar_t bergerak dari mendekati 1 menuju mendekati 0. Pada t kecil, x_t masih didominasi data asli. Pada t besar, informasi data hampir hilang dan x_t mendekati noise Gaussian murni. Perilaku inilah yang membuat model perlu mengetahui timestep saat memprediksi noise.
Bentuk closed-form tersebut juga menghemat biaya komputasi. Satu batch dapat memuat sampel dengan timestep berbeda tanpa menjalankan proses difusi secara berurutan. Kita hanya perlu menyimpan betas dan alpha_bars sebagai tensor satu dimensi, lalu mengindeksnya dengan tensor t yang berbentuk (batch_size,). Broadcasting pada unsqueeze(-1) menjaga agar setiap dimensi data memakai koefisien yang sama.
Pemilihan rentang beta menentukan seberapa cepat informasi hilang. Rentang terlalu kecil membuat x_T masih menyisakan struktur data, sehingga langkah awal sampling tidak lagi berangkat dari noise murni. Rentang terlalu besar membuat model kesulitan membedakan level noise yang berdekatan.
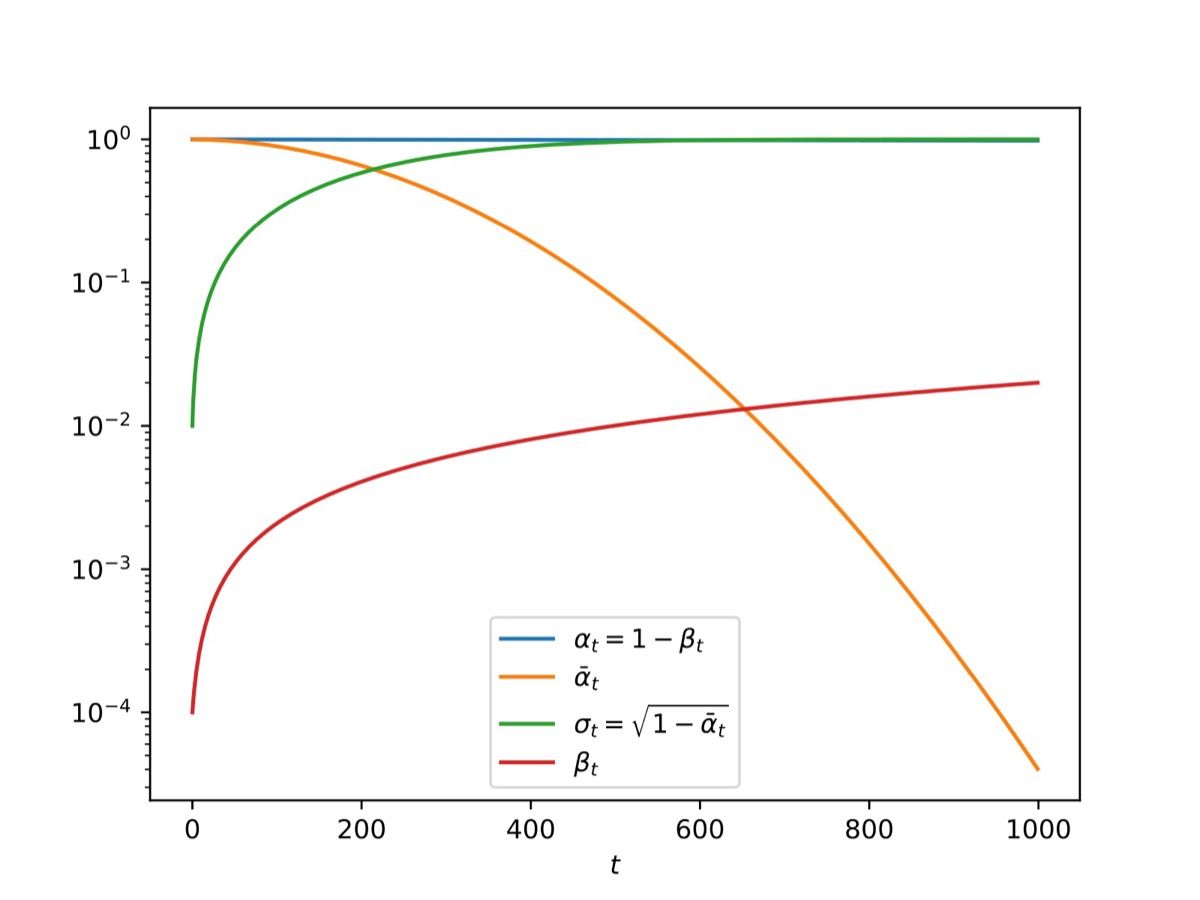
Kurva berikut menunjukkan hubungan keempat besaran pada schedule linear 1000 langkah. Perhatikan bahwa alpha_bar_t turun secara eksponensial, sementara beta_t naik perlahan.
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Gambar: kurva `beta_t`, `alpha_t`, `alpha_bar_t`, dan `sigma_t` pada linear noise schedule 1000 langkah, skala logaritmik — Sumber: Wikimedia Commons, Linear diffusion noise scheduler — Cosmia Nebula, CC BY-SA 4.0
Arsitektur Noise Predictor dan Training Objective
Noise predictor menerima dua input: versi ber-noise x_t dan nilai timestep t. Output-nya adalah prediksi noise yang ditambahkan pada langkah tersebut. Bentuk jaringan bebas, dari MLP kecil sampai U-Net dengan attention untuk data gambar.
Informasi timestep diberikan melalui sinusoidal embedding. Encoding ini memetakan skalar t menjadi vektor kontinu, sehingga model dapat membedakan level noise yang berbeda tanpa harus menghafal setiap nilai. Pola frekuensi sinus dan kosinus memberi representasi yang halus antar timestep.
import torch.nn as nn


class SinusoidalTimeEmbedding(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.dim = dim

    def forward(self, t):
        half = self.dim // 2
        freqs = torch.exp(-math.log(10000) * torch.arange(half) / half)
        args = t[:, None].float() * freqs[None, :]
        return torch.cat([args.sin(), args.cos()], dim=-1)


class NoisePredictor(nn.Module):
    def __init__(self, data_dim=2, hidden_dim=128, time_dim=32):
        super().__init__()
        self.time_embedding = SinusoidalTimeEmbedding(time_dim)
        self.net = nn.Sequential(
            nn.Linear(data_dim + time_dim, hidden_dim),
            nn.SiLU(),
            nn.Linear(hidden_dim, hidden_dim),
            nn.SiLU(),
            nn.Linear(hidden_dim, data_dim),
        )

    def forward(self, x_t, t):
        return self.net(torch.cat([x_t, self.time_embedding(t)], dim=-1))


model = NoisePredictor()
print("jumlah parameter:", sum(p.numel() for p in model.parameters()))
Output:
jumlah parameter: 21250Objective training DDPM sederhana memakai mean squared error antara noise asli dan noise prediksi. Kita tidak memprediksi x_0 secara langsung karena komponen noise pada x_t memiliki skala yang jelas dan stabil di setiap timestep. Target yang stabil membuat loss lebih mudah diturunkan.
Pada implementasi skala produksi, jaringan pengganti MLP biasanya berupa U-Net. Lapisan downsampling menangkap konteks global, sedangkan skip connection mempertahankan detail spasial yang dibutuhkan saat rekonstruksi. Untuk data dua dimensi, MLP sudah cukup karena tidak ada struktur spasial yang perlu dijaga.
Menyusun Training Loop DDPM pada Data 2D
Satu iterasi training terdiri dari empat langkah. Kita mengambil batch x_0, memilih timestep acak untuk setiap sampel, menambahkan noise sesuai schedule, lalu menghitung loss antara noise asli dan hasil prediksi. Backpropagation hanya melewati jaringan, bukan melalui proses difusi.
Pemilihan timestep secara acak penting karena satu model dipakai untuk seluruh rentang t. Setiap iterasi menyentuh level noise yang berbeda, sehingga model belajar membalik noise pada semua skala secara bersamaan.
def make_data(num_samples=2000):
    centers = torch.tensor([[2.0, 2.0], [-2.0, 2.0], [-2.0, -2.0], [2.0, -2.0]])
    labels = torch.randint(0, 4, (num_samples,))
    return centers[labels] + 0.25 * torch.randn(num_samples, 2)


x_0 = make_data()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
loss_fn = nn.MSELoss()

for step in range(1, 1501):
    batch = x_0[torch.randint(0, len(x_0), (256,))]
    t = scheduler.sample_timesteps(batch.shape[0])
    noise = torch.randn_like(batch)
    x_t = scheduler.add_noise(batch, noise, t)

    loss = loss_fn(model(x_t, t), noise)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if step % 500 == 0:
        print(f"step {step:4d} loss {loss.item():.4f}")
Output:
step  500 loss 0.4529
step 1000 loss 0.3463
step 1500 loss 0.4200
Nilai loss pada output di atas turun dari 0.4529 ke 0.3463 lalu kembali ke 0.4200. Fluktuasi ini normal karena setiap iterasi memakai timestep acak dan batch berbeda. Yang perlu diamati adalah rentangnya, bukan nilai pada satu langkah. Loss yang tetap berada di kisaran sempit menandakan model sudah menangkap pola noise pada sebagian besar level. Ketika loss berhenti turun jauh di atas nilai awal, penyebab yang paling sering adalah learning rate terlalu besar atau arsitektur terlalu kecil untuk level noise tinggi.
Nilai loss tidak dapat dibandingkan langsung antar schedule noise. Schedule yang menambahkan noise lebih agresif menghasilkan target dengan varians lebih besar, sehingga nilai MSE ikut naik. Perbandingan yang adil dilakukan dengan schedule dan jumlah timestep yang sama, atau dengan mengamati kualitas sampel akhir.
Reverse Process untuk Membangkitkan Sampel Baru
Sampling dimulai dari noise Gaussian murni, lalu model memprediksi noise pada timestep terakhir. Prediksi tersebut dipakai untuk menghitung mean distribusi p(x_{t-1} | x_t). Varians posterior ditentukan oleh schedule, sehingga tidak perlu dipelajari oleh jaringan.
Loop berjalan mundur dari t = T-1 sampai 0. Pada setiap langkah kita menambahkan noise baru kecuali pada langkah terakhir, karena hasil akhir harus berupa sampel bersih tanpa penambahan acak.
@torch.no_grad()
def sample(num_samples=1000):
    x = torch.randn(num_samples, 2)
    for step in reversed(range(scheduler.num_timesteps)):
        t = torch.full((num_samples,), step, dtype=torch.long)
        beta = scheduler.betas[step]
        alpha = scheduler.alphas[step]
        alpha_bar = scheduler.alpha_bars[step]

        pred_noise = model(x, t)
        mean = (x - beta / (1 - alpha_bar).sqrt() * pred_noise) / alpha.sqrt()

        if step > 0:
            variance = beta * (1 - scheduler.alpha_bars[step - 1]) / (1 - alpha_bar)
            x = mean + variance.sqrt() * torch.randn_like(x)
        else:
            x = mean
    return x


samples = sample()

plt.figure(figsize=(5, 5))
plt.scatter(x_0[:, 0], x_0[:, 1], s=8, alpha=0.4, label="data asli")
plt.scatter(samples[:, 0], samples[:, 1], s=8, alpha=0.4, label="sampel model")
plt.legend()
plt.title("Distribusi data asli dan sampel DDPM")
plt.tight_layout()
plt.show()
Output:
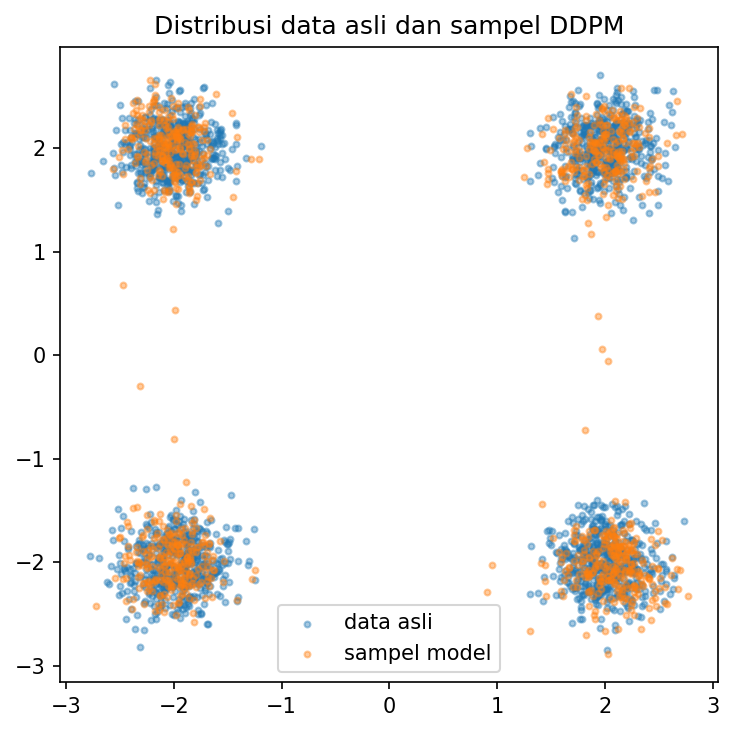
Gambar: hasil sampling DDPM setelah 1500 langkah training. Titik oranye adalah sampel model, titik biru adalah data asli.
Plot perbandingan memperlihatkan sebaran sampel model terhadap data asli. Jika sampel menempel pada empat cluster, model berhasil mempelajari distribusi data. Sampel yang menyebar datar menandakan training belum cukup atau schedule noise terlalu agresif di awal.
Jumlah langkah sampling berbanding lurus dengan waktu inference. Pada 200 timestep, satu sampel memerlukan 200 forward pass. Karena itu pengujian kualitas sebaiknya memakai jumlah sampel yang cukup banyak, misalnya 1000 titik, agar sebaran yang dihasilkan mewakili perilaku model dan bukan variasi acak dari satu sampel.
Praktik yang Menentukan Kualitas Sampel Diffusion Model
Pilihan noise schedule berpengaruh langsung pada detail yang dihasilkan. Schedule linear mudah dipahami, tetapi cosine schedule sering memberi kualitas lebih baik karena menghancurkan informasi lebih perlahan di awal proses. Untuk data gambar, perbedaan ini terlihat pada tekstur halus.
Jumlah langkah sampling dapat dikurangi memakai sampler lanjutan. DDIM memakai formulasi deterministik yang memungkinkan lompatan timestep, sedangkan DPM-Solver mendekati solusi persamaan diferensial dengan orde lebih tinggi. Keduanya menurunkan biaya inference tanpa melatih ulang model.
Exponential moving average atas bobot model membantu menstabilkan kualitas sampel. Bobot hasil rata-rata bergerak biasanya menghasilkan output lebih halus dibanding bobot terakhir. Untuk conditional generation, classifier-free guidance menyeimbangkan keberagaman sampel dan kesesuaian dengan prompt melalui satu parameter skala.
Kesalahan yang sering muncul dalam implementasi meliputi sampling di luar rentang timestep, memakai alpha_bar yang salah pada perhitungan posterior, dan mengevaluasi kualitas hanya dari satu sampel. Evaluasi sebaiknya memakai banyak sampel sekaligus, misalnya melalui FID pada data gambar, agar kesimpulan tidak bergantung pada kebetulan satu hasil.
Jika ingin mendalami generative model secara bertahap, mulai dari dasar neural network sampai implementasi diffusion model dan evaluasinya, program Deep Learning di Rumah Coding menyediakan jalur latihan terstruktur dengan pendampingan langsung. Materi mencakup penulisan training loop PyTorch, pengelolaan eksperimen, dan evaluasi kualitas sampel. Lihat kurikulum terbaru di rumahcoding.co.id.
Kursus Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.