Memahami Konsep Multi-Armed Bandit dan Implementasinya dengan Thompson Sampling untuk Eksperimen A/B Testing
Eksperimen A/B testing sudah menjadi standar untuk mengukur perubahan pada produk digital. Kita membagi traffic ke beberapa varian, menunggu sampai ukuran sampel terpenuhi, lalu membandingkan hasilnya secara statistik. Pendekatan ini valid, tetapi menyimpan biaya yang jarang dihitung: selama eksperimen berjalan, sebagian pengguna tetap menerima varian yang performanya lebih rendah.
Batas Eksperimen A/B Testing dengan Alokasi Traffic Tetap
Eksperimen A/B konvensional bekerja dengan membagi traffic secara tetap sejak hari pertama hingga eksperimen selesai. Kita menentukan ukuran sampel di awal, menjalankan varian kontrol dan perlakuan dengan proporsi yang sama, lalu menunggu sampai jumlah observasi mencukupi. Selama periode itu, separuh pengguna tetap menerima varian dengan performa lebih rendah.
Biaya tersebut dikenal sebagai regret, yaitu selisih antara reward dari keputusan terbaik dan reward dari keputusan yang benar-benar diambil. Pada eksperimen konversi, regret dihitung per impresi. Jika varian B memiliki conversion rate 5% sementara kontrol hanya 3%, setiap impresi yang jatuh ke kontrol kehilangan 2 poin persentase konversi.
Regret bersifat akumulatif. Eksperimen selama empat minggu dengan traffic 20.000 impresi per minggu berarti sekitar 40.000 impresi pada kontrol yang seharusnya bisa dialihkan ke varian yang lebih baik. Kerugiannya tidak terlihat di dashboard karena tidak pernah diukur sebagai metrik tersendiri.
Keterbatasan lain adalah waktu keputusan. Uji signifikansi baru bisa dijalankan setelah sampel terpenuhi, dan prosesnya sering memakan dua sampai empat minggu. Selama menunggu, tim produk tidak punya dasar untuk mengalihkan traffic meskipun data awal sudah mengarah ke varian yang unggul.
Pendekatan ini tetap tepat ketika tujuan kita adalah mengukur efek secara presisi. Namun ketika tujuannya memaksimalkan konversi selama periode eksperimen, alokasi tetap meninggalkan peluang yang tidak termanfaatkan.
Formulasi Multi-Armed Bandit dan Trade-off Exploration versus Exploitation
Multi-armed bandit memodelkan masalah yang sama dengan tujuan berbeda. Kita memiliki himpunan arm, masing-masing mewakili satu varian, dengan distribusi reward yang tidak diketahui dan rata-rata μ_i. Pada setiap putaran t, kita memilih satu arm, mengamati reward r_t yang bernilai 0 atau 1 mengikuti distribusi Bernoulli, lalu memperbarui keyakinan kita tentang arm tersebut.
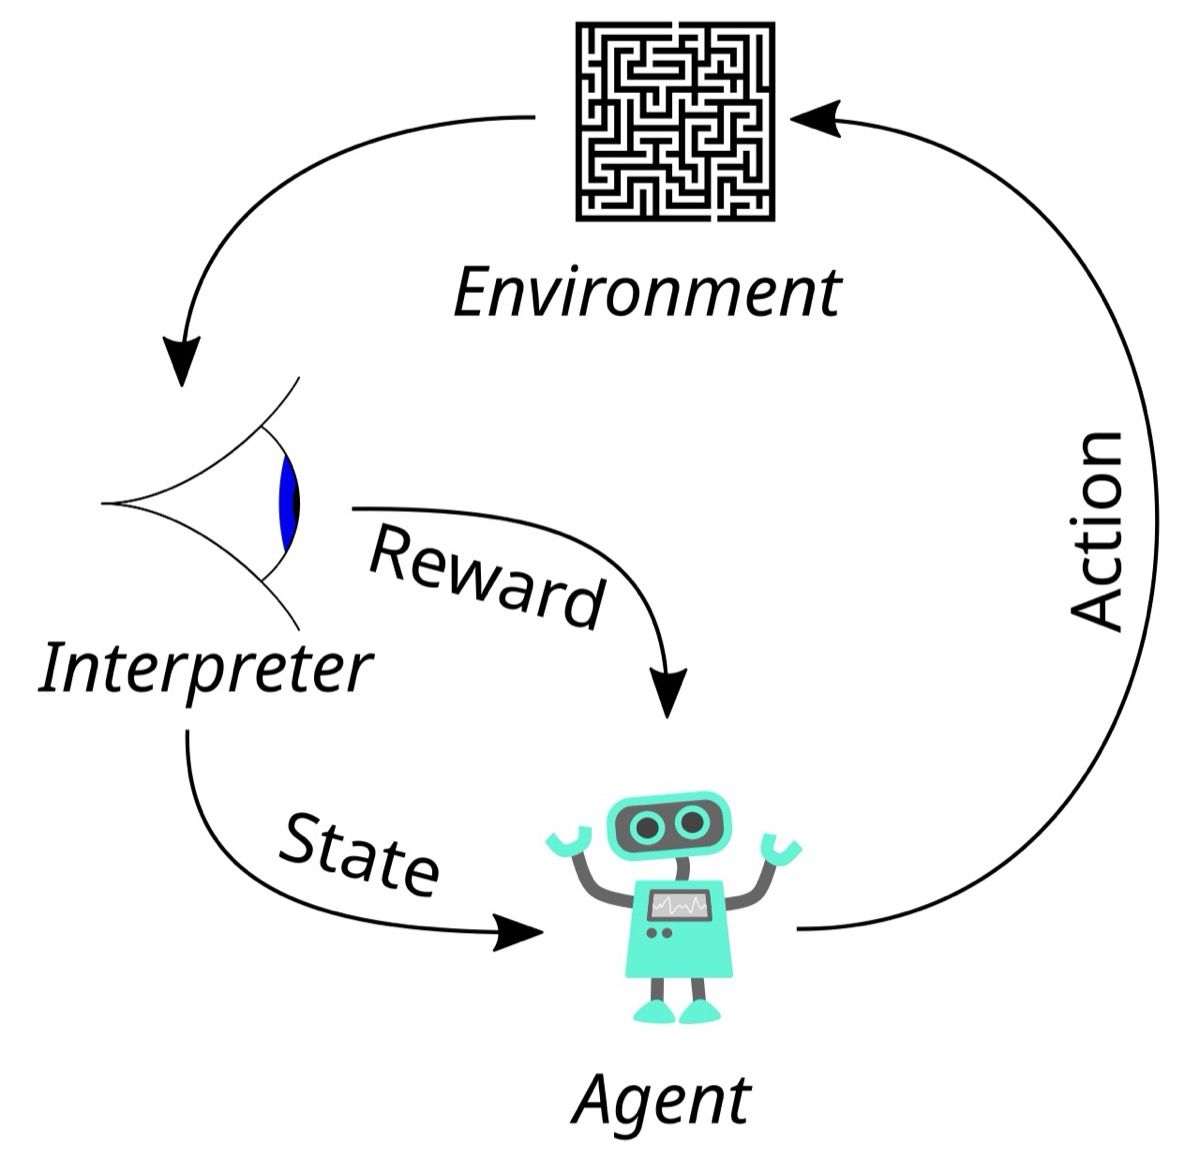
Gambar: Loop agent–environment pada reinforcement learning. Multi-armed bandit adalah bentuk sederhananya, tanpa state dan interpreter — Sumber: Wikimedia Commons
Tujuan bandit adalah memaksimalkan total reward kumulatif Σ r_t selama T putaran, bukan meminimalkan error estimasi di akhir eksperimen. Karena itu, regret menjadi fungsi objektif utama: regret(T) = T × max μ_i − E[Σ r_t]. Kebijakan yang baik menjaga pertumbuhan regret tetap sublinear terhadap jumlah impresi.
Perbedaan tujuan ini mengubah cara kita memperlakukan data. A/B testing mengeksplorasi semua arm dengan porsi sama agar perbandingan bersih. Bandit mengeksploitasi arm yang tampak unggul sambil tetap mengeksplorasi arm lain secukupnya.
Tiga strategi yang umum dipakai adalah epsilon-greedy, Upper Confidence Bound (UCB), dan Thompson Sampling. epsilon-greedy memilih arm terbaik saat ini dengan probabilitas 1 − ε dan arm acak dengan probabilitas ε. UCB menambahkan bonus optimisme pada arm yang jarang dipilih melalui suku sqrt(2 ln t / n_i). Thompson Sampling mengambil sampel dari distribusi posterior setiap arm dan memilih sampel tertinggi.
Pada praktiknya, Thompson Sampling sering dipilih untuk eksperimen konversi karena hasilnya mudah diinterpretasi. Posterior setiap arm dapat dibaca langsung sebagai distribusi conversion rate, sehingga tim produk melihat rentang nilai yang masuk akal, bukan hanya satu angka estimasi.
Eksplorasi tetap diperlukan karena estimasi awal mudah terkunci pada kebetulan. Arm yang menang dua kali dari dua percobaan terlihat sempurna, padahal estimasinya masih sangat lebar. Tanpa eksplorasi, arm tersebut mendominasi traffic dan arm lain tidak pernah mendapat kesempatan memperbaiki estimasinya.
Posterior Beta Distribution sebagai Dasar Thompson Sampling
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Thompson Sampling memakai distribusi Beta sebagai model keyakinan. Reward Bernoulli memiliki conjugate prior Beta, sehingga posterior setelah mengamati data juga berdistribusi Beta. Kita mulai dengan Beta(1, 1) yang setara distribusi uniform, lalu menambahkan jumlah konversi ke parameter alpha dan jumlah non-konversi ke parameter beta.
Aturan pembaruannya sederhana: alpha_i = 1 + conversions_i dan beta_i = 1 + (impressions_i − conversions_i). Setelah 1.000 impresi dengan 80 konversi, posterior arm tersebut menjadi Beta(81, 921) dengan rata-rata 0.081. Semakin banyak data, semakin sempit distribusinya, dan ketidakpastian menurun.
Pada setiap putaran, Thompson Sampling menarik satu nilai acak dari posterior setiap arm, lalu memilih arm dengan nilai tertinggi. Probabilitas sebuah arm terpilih sebanding dengan probabilitas arm tersebut benar-benar yang terbaik menurut data yang kita miliki. Posterior yang lebar masih bisa menghasilkan sampel tinggi, sehingga eksplorasi terjadi secara alami.
Mekanisme ini menyeimbangkan eksplorasi dan eksploitasi tanpa parameter tuning. Tidak ada nilai ε yang harus dipilih, dan tidak ada bonus eksplisit yang perlu dikalibrasi. Ketidakpastian itu sendiri yang menentukan seberapa besar eksplorasi yang diberikan.
!pip install numpy scipy matplotlib

import numpy as np
from scipy.stats import beta
import matplotlib.pyplot as plt

np.random.seed(42)

# Pasangan (konversi, impresi) untuk tiga varian
data = {
    'Varian A': (30, 1000),
    'Varian B': (50, 1000),
    'Varian C': (80, 1000),
}

x = np.linspace(0, 0.15, 500)
fig, ax = plt.subplots(figsize=(10, 5))

for label, (conversions, impressions) in data.items():
    alpha = 1 + conversions
    beta_param = 1 + (impressions - conversions)
    density = beta.pdf(x, alpha, beta_param)
    mean_ctr = alpha / (alpha + beta_param)

    ax.plot(x, density, label=f'{label} (mean={mean_ctr:.3f})')
    print(f'{label}: alpha={alpha}, beta={beta_param}, mean CTR={mean_ctr:.3f}')

ax.set_title('Posterior Beta untuk Tiga Varian')
ax.set_xlabel('Conversion rate')
ax.set_ylabel('Density')
ax.legend()
ax.grid(True, alpha=0.3)

plt.tight_layout()
Output:
Varian A: alpha=31, beta=971, mean CTR=0.031
Varian B: alpha=51, beta=951, mean CTR=0.051
Varian C: alpha=81, beta=921, mean CTR=0.081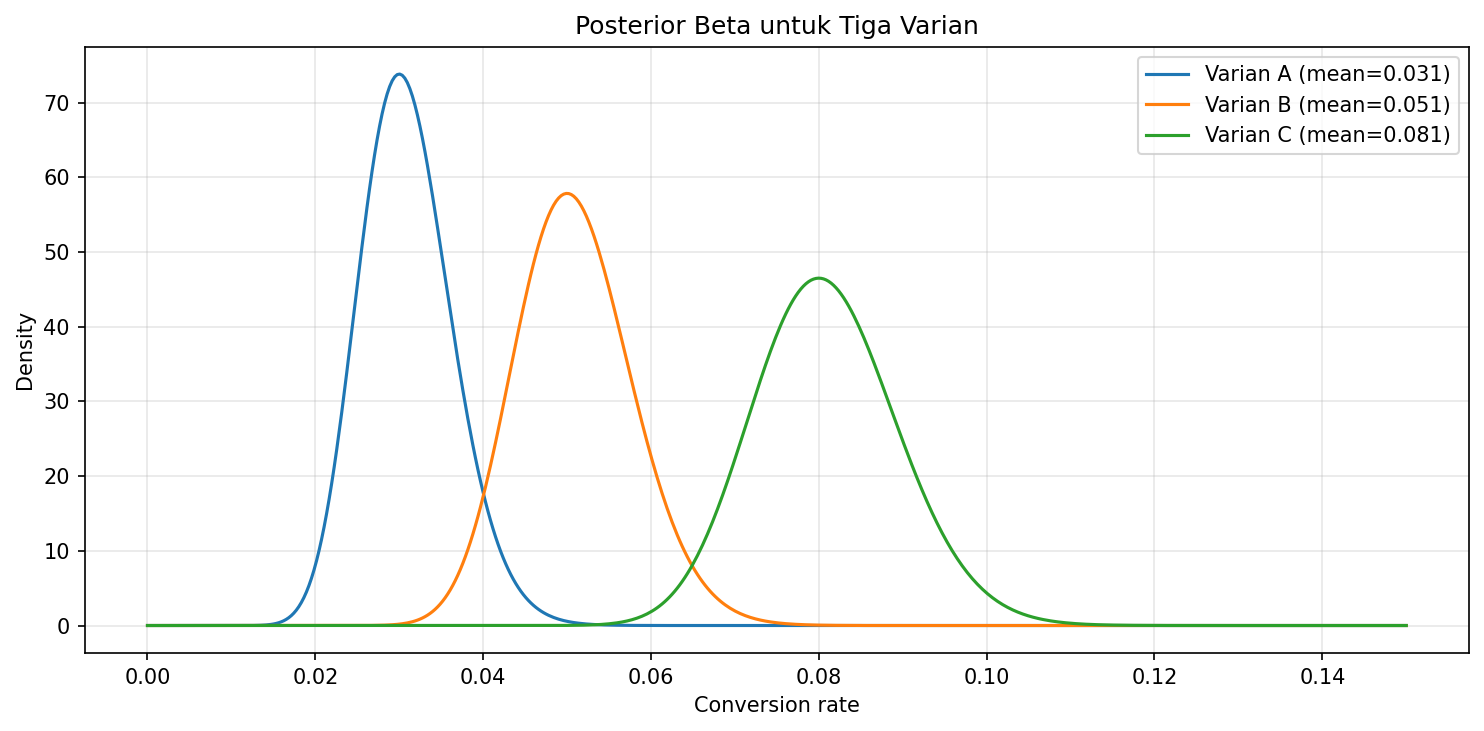
Tiga kurva pada plot menunjukkan posisi dan lebar posterior masing-masing varian. Varian C berada paling kanan dengan puncak tertinggi dan bentuk paling sempit, tanda bahwa datanya paling meyakinkan. Varian A berada paling kiri dengan kurva lebar, sehingga masih menyisakan ruang untuk naik bila data berikutnya berbeda.
Simulasi Thompson Sampling dan Perbandingannya dengan A/B Testing Statis
Untuk melihat dampaknya, kita simulasikan 10.000 impresi pada tiga arm dengan true CTR 0.03, 0.05, dan 0.08. Baseline statis membagi impresi secara merata ke ketiga arm, meniru alokasi tetap pada A/B testing. Setiap arm menyimpan parameter alpha dan beta yang diperbarui setelah setiap konversi.
Fungsi run_thompson_sampling() menjalankan loop utama. Di setiap iterasi, fungsi mengambil sampel posterior untuk semua arm, memilih arm dengan sampel tertinggi, lalu membangkitkan reward Bernoulli sesuai true CTR arm tersebut. Reward itu dipakai untuk memperbarui posterior arm yang terpilih, sementara parameter arm lain tidak berubah. Baseline statis memakai rotasi arm yang sama sepanjang eksperimen sehingga tidak pernah belajar dari hasil.
Kode menyimpan pilihan arm dan reward per putaran. Dari dua array itu kita bisa menghitung tiga metrik: reward kumulatif, jumlah impresi per arm, dan cumulative regret terhadap arm terbaik. Plot dua panel menampilkan perbandingan reward kumulatif dan distribusi traffic.
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)

true_ctr = np.array([0.03, 0.05, 0.08])
n_arms = len(true_ctr)
n_rounds = 10000

def run_thompson_sampling(true_ctr, n_rounds):
    alpha = np.ones(n_arms)
    beta_param = np.ones(n_arms)
    rewards = np.zeros(n_rounds)
    choices = np.zeros(n_rounds, dtype=int)

    for t in range(n_rounds):
        samples = np.random.beta(alpha, beta_param)
        arm = int(np.argmax(samples))
        reward = np.random.binomial(1, true_ctr[arm])

        alpha[arm] += reward
        beta_param[arm] += 1 - reward
        choices[t] = arm
        rewards[t] = reward

    return choices, rewards

def run_static_split(true_ctr, n_rounds):
    choices = np.arange(n_rounds) % n_arms
    rewards = np.random.binomial(1, true_ctr[choices])
    return choices, rewards

ts_choices, ts_rewards = run_thompson_sampling(true_ctr, n_rounds)
ab_choices, ab_rewards = run_static_split(true_ctr, n_rounds)

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

axes[0].plot(np.cumsum(ts_rewards), color='#2196F3', label='Thompson Sampling')
axes[0].plot(np.cumsum(ab_rewards), color='#F44336', label='Static A/B')
axes[0].set_title('Cumulative Reward')
axes[0].set_xlabel('Impresi')
axes[0].set_ylabel('Total reward')
axes[0].legend()
axes[0].grid(True, alpha=0.3)

labels = [f'Arm {i + 1}' for i in range(n_arms)]
ts_counts = np.bincount(ts_choices, minlength=n_arms)
ab_counts = np.bincount(ab_choices, minlength=n_arms)
x = np.arange(n_arms)
width = 0.35

axes[1].bar(x - width / 2, ts_counts, width, color='#2196F3', label='Thompson Sampling')
axes[1].bar(x + width / 2, ab_counts, width, color='#F44336', label='Static A/B')
axes[1].set_xticks(x)
axes[1].set_xticklabels(labels)
axes[1].set_title('Alokasi Traffic per Arm')
axes[1].set_ylabel('Jumlah impresi')
axes[1].legend()
axes[1].grid(True, alpha=0.3, axis='y')

plt.tight_layout()

print('Alokasi Thompson Sampling:', dict(zip(labels, ts_counts.tolist())))
print('Alokasi Static A/B     :', dict(zip(labels, ab_counts.tolist())))
print(f'Total reward Thompson Sampling: {ts_rewards.sum()}')
print(f'Total reward Static A/B       : {ab_rewards.sum()}')
regret_ts = np.sum(true_ctr.max() - true_ctr[ts_choices])
regret_ab = np.sum(true_ctr.max() - true_ctr[ab_choices])
print(f'Regret Thompson Sampling: {regret_ts:.1f}')
print(f'Regret Static A/B       : {regret_ab:.1f}')
Output:
Alokasi Thompson Sampling: {'Arm 1': 288, 'Arm 2': 170, 'Arm 3': 9542}
Alokasi Static A/B     : {'Arm 1': 3334, 'Arm 2': 3333, 'Arm 3': 3333}
Total reward Thompson Sampling: 814.0
Total reward Static A/B       : 574
Regret Thompson Sampling: 19.5
Regret Static A/B       : 266.7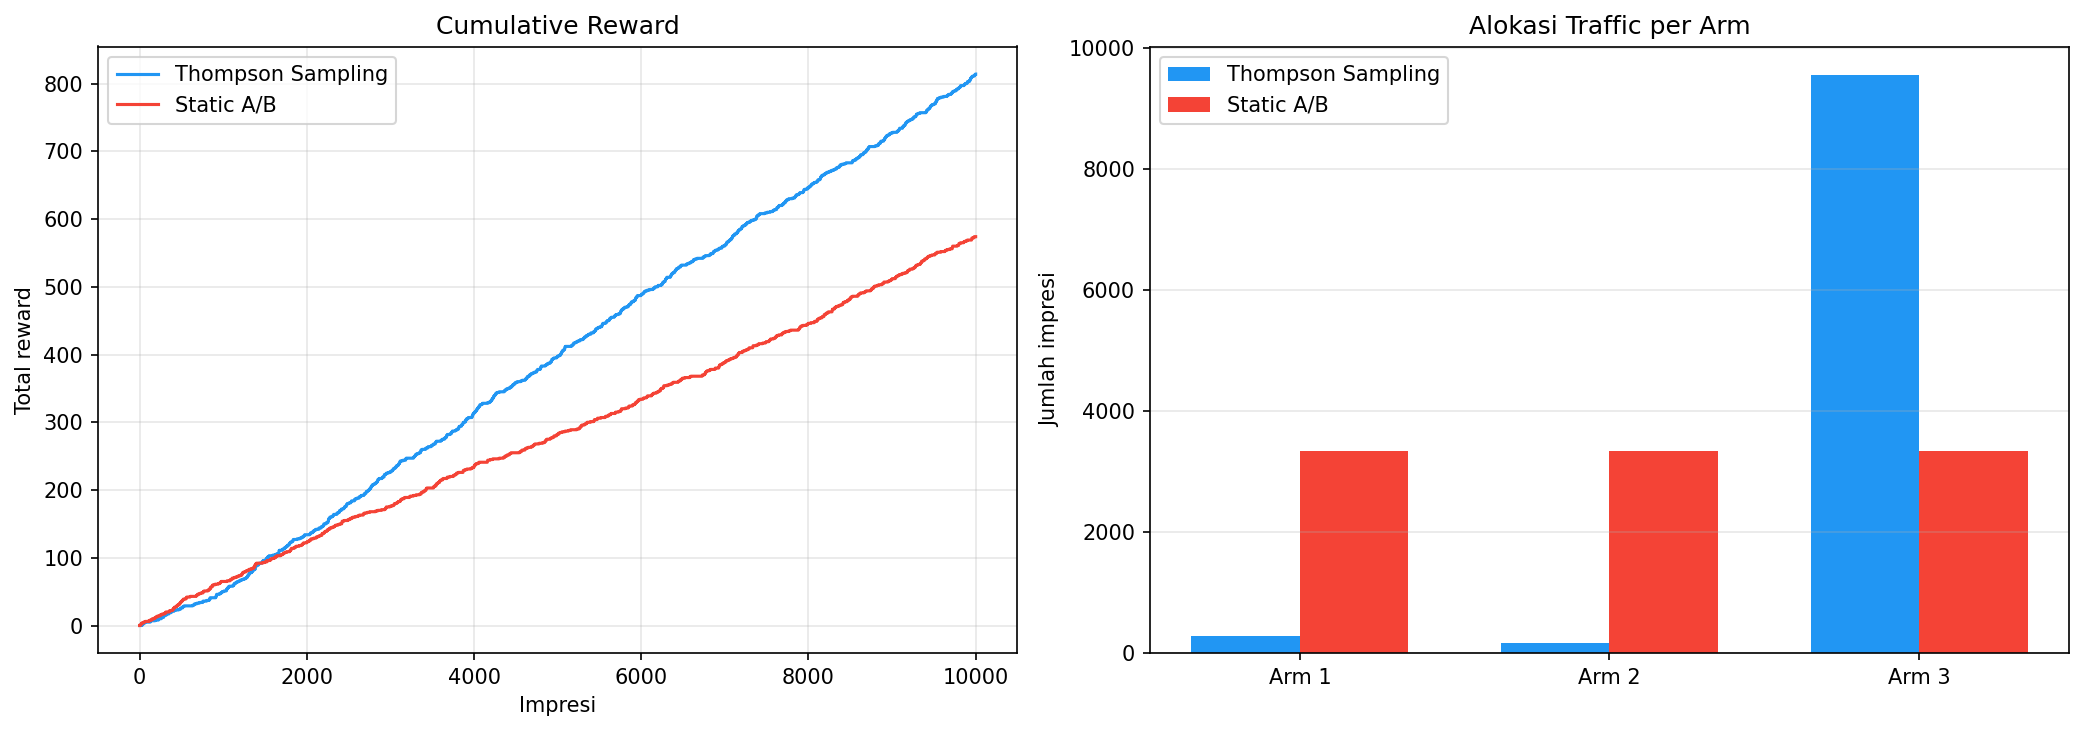
Hasil tipikal menunjukkan dua pola yang konsisten. Kurva reward Thompson Sampling tumbuh lebih cepat, dan jaraknya terhadap baseline melebar setelah beberapa ratus impresi. Alokasi traffic berpindah ke arm ketiga hingga mendekati 95% dari total, sementara dua arm lain hanya menerima sisa untuk eksplorasi. Regret baseline tumbuh hampir linear, sedangkan regret Thompson Sampling melandai setelah posterior cukup yakin.
Perbedaan terbesar muncul di awal eksperimen. Baseline menghabiskan sepertiga traffic pada arm terburuk sepanjang 10.000 impresi. Thompson Sampling hanya memberinya traffic secukupnya sampai posterior arm tersebut menyempit di sekitar nilai rendah, lalu meninggalkannya. Total reward yang dicetak di akhir blok kode menunjukkan selisih langsung dari kedua kebijakan.
Pertimbangan Saat Menerapkan Bandit di Sistem Produksi
Simulasi di atas mengasumsikan reward datang seketika. Pada sistem nyata, konversi sering tertunda beberapa jam hingga beberapa hari. Kita perlu buffer untuk menyimpan eksposur yang belum menghasilkan reward, lalu memperbarui posterior saat konversi tercatat. Tanpa buffer, arm dengan conversion window lebih panjang akan terlihat lebih buruk dari yang sebenarnya.
Preferensi pengguna juga berubah. Posterior yang dibangun dari data enam bulan lalu tidak lagi mewakili kondisi sekarang. Pendekatan yang umum dipakai adalah discounting, yaitu mengalikan parameter posterior dengan faktor kurang dari 1 secara berkala, atau membatasi data pada sliding window tertentu.
Guardrail metric tetap wajib dipantau. Metrik seperti latency, crash rate, dan refund rate tidak ikut dioptimalkan oleh bandit, tetapi harus bisa menghentikan arm yang merusak pengalaman pengguna. Kita juga perlu mencatat eksposur dan reward per arm secara eksplisit untuk keperluan audit dan reproduksibilitas.
Frekuensi update posterior juga perlu disesuaikan dengan volume traffic. Update per impresi memberi respons paling cepat, sedangkan batch update setiap beberapa menit lebih murah secara komputasi dan tetap memadai untuk traffic tinggi.
Bandit bukan pilihan tepat untuk semua eksperimen. Ketika tim perlu mengukur efek jangka panjang, misalnya dampak pada retensi enam bulan, alokasi tetap lebih sesuai karena perbandingan antar arm tetap seimbang. Eksperimen yang menyangkut kepatuhan regulasi juga menuntut populasi kontrol yang stabil. Dalam kondisi itu, A/B testing konvensional masih menjadi alat utama.
Jika kita ingin mempraktikkan eksperimen berbasis data secara terstruktur, Machine Learning Bootcamp di Rumah Coding membahas topik seperti ini dari dasar statistik sampai implementasi di sistem produksi.
Kursus Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.