Memahami Konsep Uji Chi-Square dan Implementasinya dengan SciPy untuk Analisis Data Kategorik
Mengapa Data Kategorik Membutuhkan Uji Statistik yang Berbeda
Data kategorik merekam keanggotaan sebuah observasi ke dalam kelompok, bukan mengukur besarannya. Variabel ini hadir dalam dua bentuk. Skala nominal tidak memiliki urutan, seperti jenis kelamin, status kelulusan, atau kategori produk. Skala ordinal memiliki urutan logis, seperti tingkat kepuasan rendah, sedang, dan tinggi. Nilai pada data kategorik adalah label, sehingga rata-rata dan varians kehilangan makna aritmetiknya.
Karena alasan ini, uji parametrik seperti t-test atau ANOVA tidak berlaku. Kedua uji tersebut beroperasi pada rata-rata dan mengasumsikan data numerik yang berdistribusi kontinu. Ketika variabelnya hanya berupa frekuensi kategori, kita membutuhkan kerangka pengujian yang bekerja langsung pada jumlah observasi di tiap sel. Di sinilah uji Chi-Square berperan.
Pertanyaan yang dijawab uji ini sederhana: apakah dua variabel kategorik saling berhubungan, atau justru independen? Terdapat dua varian dengan tujuan berbeda. Uji goodness-of-fit memeriksa apakah distribusi satu variabel sesuai dengan ekspektasi teoretis. Uji independensi menguji apakah dua variabel saling terkait dalam sebuah tabel kontingensi. Fokus pembahasan kita adalah uji independensi, karena varian inilah yang paling sering dipakai pada analisis data nyata.
Dasar Matematis Chi-Square dan Asumsi yang Harus Dipenuhi Sebelum Pengujian
Uji Chi-Square membandingkan dua jenis frekuensi. Observed frequency adalah jumlah observasi yang benar-benar tercatat pada tiap sel tabel kontingensi. Expected frequency adalah jumlah yang seharusnya muncul jika kedua variabel benar-benar independen. Nilai harapan ini berperan seperti prediksi netral sebelum ada petunjuk apa pun dari data.
Rumus statistik Chi-Square menjumlahkan selisih kuadrat antara frekuensi observasi dan harapan, lalu membaginya dengan frekuensi harapan:
chi2 = SUM (O - E)^2 / ESimbol O mewakili observed frequency dan E mewakili expected frequency. Semakin besar total selisih, semakin kecil kemungkinan kedua variabel independen. Derajat kebebasan tabel kontingensi dihitung dengan (jumlah baris - 1) * (jumlah kolom - 1). Nilai ini menentukan bentuk distribusi Chi-Square yang dipakai untuk menghitung p-value.
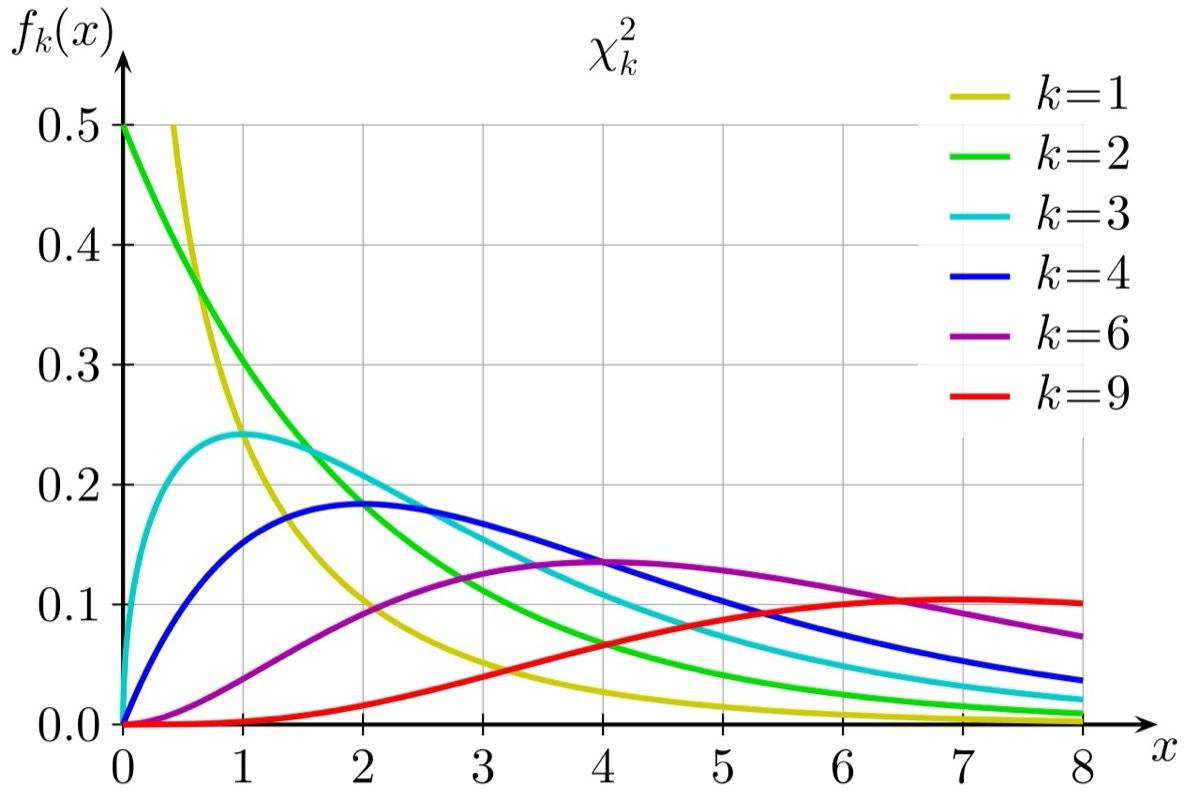
Gambar: Kurva distribusi Chi-Square untuk berbagai derajat kebebasan (k); derajat kebebasan menentukan bentuk kurva yang dipakai menghitung p-value — Sumber: Wikimedia Commons
Keputusan pengujian mengacu pada p-value terhadap tingkat signifikansi alpha, umumnya 0.05. Jika p-value lebih kecil dari alpha, kita menolak hipotesis nol dan menyimpulkan adanya hubungan yang signifikan. Ada tiga asumsi kritis yang wajib dipenuhi. Pertama, frekuensi harapan minimal bernilai 5 pada setiap sel. Kedua, setiap observasi bersifat independen satu sama lain. Ketiga, data yang dimasukkan berupa frekuensi, bukan persentase atau proporsi. Saat asumsi frekuensi kecil tidak terpenuhi, kita beralih ke uji Fisher's Exact yang tetap valid untuk tabel berukuran kecil.
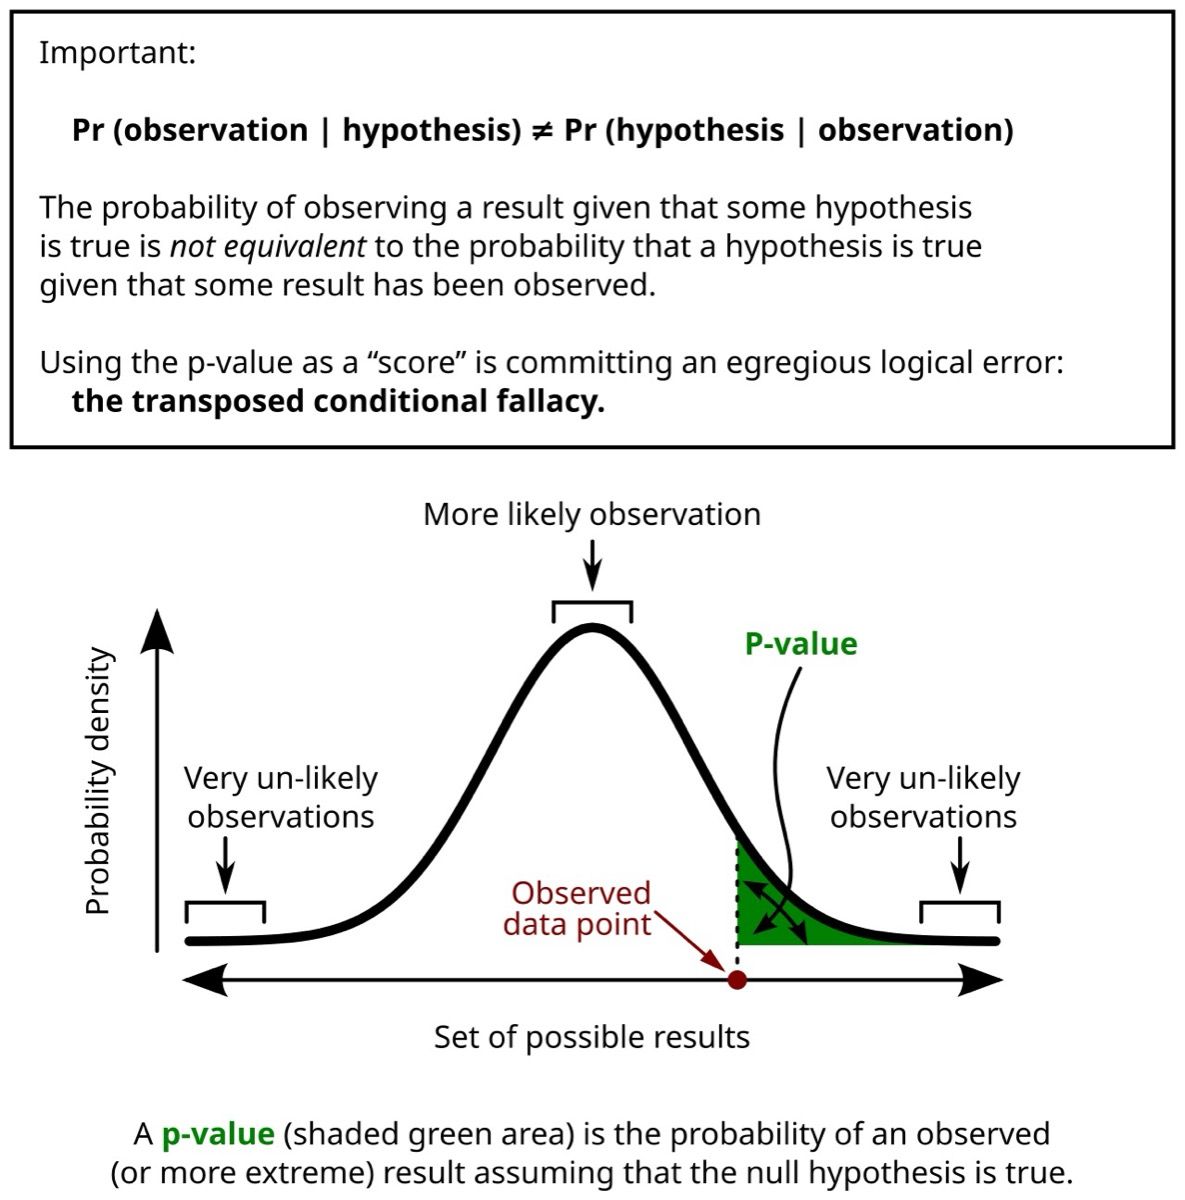
Gambar: Ilustrasi p-value sebagai luas area ekor distribusi, dasar keputusan menolak atau gagal menolak hipotesis nol — Sumber: Wikimedia Commons
Membentuk Tabel Kontingensi dari Raw Data dengan Pandas
Sebelum pengujian, kita perlu menyusun data mentah menjadi tabel kontingensi. Tabel ini menampilkan frekuensi tiap kombinasi kategori, dengan baris mewakili satu variabel dan kolom mewakili variabel lainnya. Kita bangun DataFrame sintetis yang menghubungkan status_pelanggan dengan jenis_paket agar contoh dapat direproduksi tanpa unduhan dataset.
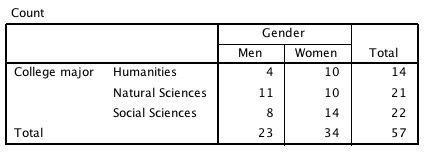
Gambar: Struktur tabel kontingensi frekuensi beserta total marginal pada tiap baris dan kolom — Sumber: Wikimedia Commons
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Fungsi pd.crosstab() mengubah kolom kategorik menjadi tabel silang frekuensi. Proses ini melakukan margination, yaitu menghitung total pada setiap baris dan kolom untuk memberi konteks proporsi. Setelah tabel terbentuk, kita membacanya dengan melihat tiap sel, lalu membandingkannya terhadap total baris dan kolom. Pola hubungan mulai terlihat ketika distribusi pada satu baris berbeda jauh dari distribusi baris lain. Untuk memperjelas pola tersebut, kita tampilkan heatmap frekuensi dengan matplotlib.
!pip install pandas numpy matplotlib

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

np.random.seed(42)

n = 300
status = np.random.choice(['Aktif', 'Nonaktif'], size=n, p=[0.6, 0.4])
paket = np.where(
    status == 'Aktif',
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.2, 0.4, 0.4]),
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.5, 0.35, 0.15])
)

df = pd.DataFrame({'status_pelanggan': status, 'jenis_paket': paket})

tabel = pd.crosstab(df['status_pelanggan'], df['jenis_paket'])
print(tabel)

fig, ax = plt.subplots(figsize=(7, 4))
im = ax.imshow(tabel.values, cmap='Blues')
ax.set_xticks(range(len(tabel.columns)))
ax.set_xticklabels(tabel.columns)
ax.set_yticks(range(len(tabel.index)))
ax.set_yticklabels(tabel.index)
ax.set_title('Heatmap Frekuensi Status Pelanggan vs Jenis Paket')
fig.colorbar(im, ax=ax)
plt.tight_layout()
plt.savefig('heatmap_kontingensi.png')
plt.show()
Output:
jenis_paket       Basic  Enterprise  Pro
status_pelanggan
Aktif                38          80   59
Nonaktif             67          10   46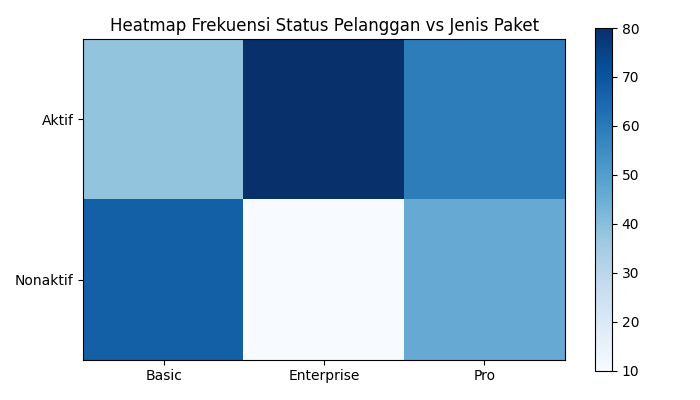
Output menampilkan tabel kontingensi lengkap dengan total margin, diikuti heatmap yang menyoroti sel dengan frekuensi tertinggi. Warna lebih gelap menandai kombinasi kategori yang paling sering muncul, sehingga selisih distribusi antar status pelanggan langsung terlihat secara visual.
Menjalankan Uji Chi-Square dan Menafsirkan Hasilnya dengan SciPy
Fungsi scipy.stats.chi2_contingency() menerima tabel kontingensi dan mengembalikan empat nilai sekaligus. Nilai pertama adalah statistik Chi-Square, ukuran seberapa jauh observasi menyimpang dari harapan. Nilai kedua adalah p-value, peluang memperoleh deviasi sebesar itu jika kedua variabel sebenarnya independen. Nilai ketiga adalah degrees of freedom, dan nilai keempat adalah matriks expected frequencies yang bisa kita bandingkan dengan tabel observasi.
Alur keputusan bersifat langsung. Kita menetapkan alpha sebesar 0.05, lalu menolak hipotesis nol ketika p-value berada di bawah nilai tersebut. Penolakan hipotesis nol berarti terdapat bukti statistik bahwa kedua variabel tidak independen. Namun, statistik Chi-Square yang besar hanya menunjukkan bobot bukti, bukan besar hubungan itu sendiri. Karena alasan ini, kita perlu melaporkan effect size di samping p-value agar kesimpulan tidak menyesatkan.
!pip install pandas numpy scipy

import numpy as np
import pandas as pd
from scipy.stats import chi2_contingency

np.random.seed(42)

n = 300
status = np.random.choice(['Aktif', 'Nonaktif'], size=n, p=[0.6, 0.4])
paket = np.where(
    status == 'Aktif',
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.2, 0.4, 0.4]),
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.5, 0.35, 0.15])
)

df = pd.DataFrame({'status_pelanggan': status, 'jenis_paket': paket})
tabel = pd.crosstab(df['status_pelanggan'], df['jenis_paket'])

chi2, p_value, dof, expected = chi2_contingency(tabel)

print(f'Statistik Chi-Square : {chi2:.3f}')
print(f'P-value              : {p_value:.5f}')
print(f'Degrees of Freedom   : {dof}')
print('Expected frequencies :')
print(pd.DataFrame(expected, index=tabel.index, columns=tabel.columns).round(2))

alpha = 0.05
keputusan = 'menolak H0' if p_value < alpha else 'gagal menolak H0'
print(f'Keputusan pada alpha {alpha}: {keputusan}')
Output:
Statistik Chi-Square : 56.163
P-value              : 0.00000
Degrees of Freedom   : 2
Expected frequencies :
jenis_paket       Basic  Enterprise    Pro
status_pelanggan
Aktif             61.95        53.1  61.95
Nonaktif          43.05        36.9  43.05
Keputusan pada alpha 0.05: menolak H0
Output mencetak statistik Chi-Square, p-value, derajat kebebasan, dan tabel expected frequencies. Dari nilai tersebut kita membaca arah keputusan dan memastikan setiap sel harapan bernilai minimal 5 agar pengujian tetap valid.
Mengukur Kekuatan Hubungan dengan Cramér's V
P-value yang signifikan tidak selalu berarti hubungan yang kuat. Pada sampel besar, perbedaan yang sangat kecil bisa menghasilkan p-value yang sangat rendah. Keterbatasan ini membuat effect size menjadi pelengkap wajib. Cramér's V menormalkan statistik Chi-Square terhadap ukuran tabel, sehingga menghasilkan nilai pada rentang 0 sampai 1. Nilai 0 berarti kedua variabel independen, sedangkan nilai mendekati 1 menandakan asosiasi yang kuat.
Rumusnya membagi statistik Chi-Square dengan ukuran sampel dan nilai minimum dari (baris - 1) atau (kolom - 1), lalu mengambil akar kuadratnya. Modul scipy belum menyediakan fungsi bawaan untuk Cramér's V, jadi kita menuliskannya manual. Setelah nilai tiap pasangan kategori diperoleh, kita tampilkan dalam satu bar chart agar perbandingan kekuatan hubungan mudah dibaca.
!pip install pandas numpy scipy matplotlib

import numpy as np
import pandas as pd
from scipy.stats import chi2_contingency
import matplotlib.pyplot as plt

np.random.seed(42)

n = 300
status = np.random.choice(['Aktif', 'Nonaktif'], size=n, p=[0.6, 0.4])
paket = np.where(
    status == 'Aktif',
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.2, 0.4, 0.4]),
    np.random.choice(['Basic', 'Pro', 'Enterprise'], size=n, p=[0.5, 0.35, 0.15])
)

data = pd.DataFrame({
    'status_pelanggan': status,
    'jenis_paket': paket,
    'metode_bayar': np.random.choice(['Transfer', 'Kartu', 'E-Wallet'], size=n),
    'kota': np.random.choice(['Jakarta', 'Bandung', 'Surabaya'], size=n),
    'kanal_akuisisi': np.random.choice(['Iklan', 'Referral', 'Organik'], size=n),
})


def cramers_v(tabel):
    chi2 = chi2_contingency(tabel)[0]
    total = tabel.sum().sum()
    baris, kolom = tabel.shape
    return np.sqrt((chi2 / total) / min(kolom - 1, baris - 1))


pairs = [
    ('status_pelanggan', 'jenis_paket'),
    ('status_pelanggan', 'metode_bayar'),
    ('jenis_paket', 'kota'),
    ('jenis_paket', 'kanal_akuisisi'),
]

hasil = {}
for kolom_a, kolom_b in pairs:
    tabel = pd.crosstab(data[kolom_a], data[kolom_b])
    nilai_v = cramers_v(tabel)
    label = f'{kolom_a} vs {kolom_b}'
    hasil[label] = nilai_v
    print(f'{label}: V = {nilai_v:.3f}')

fig, ax = plt.subplots(figsize=(8, 4))
ax.barh(list(hasil.keys()), list(hasil.values()), color='steelblue')
ax.set_xlim(0, 1)
ax.set_xlabel("Cramér's V")
ax.set_title('Kekuatan Hubungan Antar Pasangan Variabel Kategorik')
plt.tight_layout()
plt.savefig('cramers_v.png')
plt.show()
Output:
status_pelanggan vs jenis_paket: V = 0.433
status_pelanggan vs metode_bayar: V = 0.102
jenis_paket vs kota: V = 0.026
jenis_paket vs kanal_akuisisi: V = 0.046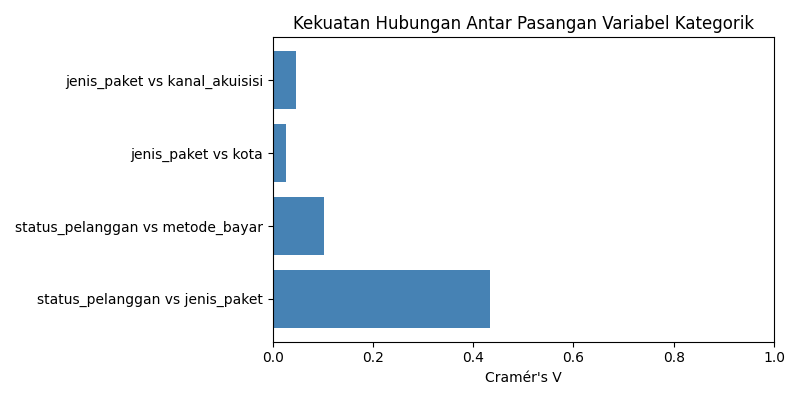
Output mencetak nilai V untuk setiap pasangan, diikuti bar chart yang membandingkannya pada skala 0 sampai 1. Pasangan dengan batang lebih panjang menunjukkan asosiasi lebih kuat, sedangkan batang pendek menandakan hubungan yang lemah meskipun signifikan secara statistik.
Praktik Terbaik dan Kesalahan Umum saat Menggunakan Chi-Square
Kesalahan paling sering adalah memaksa variabel kontinu menjadi kategori tanpa dasar yang jelas. Memotong usia atau pendapatan menjadi beberapa bin memang membuat variabel bisa dianalisis, tetapi pengelompokan yang arbitrer mengaburkan informasi dan menurunkan kekuatan pengujian. Sebaiknya pertahankan variabel kontinu pada uji parametrik yang sesuai.
Asumsi frekuensi harapan minimal 5 juga kerap diabaikan. Ketika banyak sel bernilai harapan di bawah 5, distribusi Chi-Square tidak lagi akurat dan p-value menjadi tidak dapat dipercaya. Pada kondisi seperti itu, gunakan Fisher's Exact atau gabungkan kategori yang secara logis berdekatan.
Bahaya lain muncul saat kita menguji banyak pasangan sekaligus. Melakukan 20 uji dengan alpha 0.05 meningkatkan peluang menemukan signifikansi palsu menjadi cukup besar. Koreksi seperti Bonferroni atau Benjamini-Hochberg diperlukan untuk mengendalikan family-wise error rate. Terakhir, signifikansi statistik tidak pernah membuktikan kausalitas. Hubungan antar variabel kategorik bisa jadi dipengaruhi variabel ketiga yang tidak diukur.
Sebelum melaporkan hasil, periksa checklist berikut: ukuran sampel memadai, seluruh asumsi terpenuhi, p-value disertai derajat kebebasan, dan effect size seperti Cramér's V ikut dicantumkan. Checklist ini menjaga kesimpulan tetap jujur dan dapat dipertanggungjawabkan.
Pelaporan hasil uji Chi-Square yang baik selalu melampaui angka p-value. Fondasi statistik yang kuat inilah yang membedakan analisis deskriptif dari pengambilan keputusan berbasis data. Untuk memperdalam statistika terapan dan analisis data dengan Python, Rumah Coding menyediakan course dan bootcamp Data Science yang membahas topik ini secara praktis. Kita mengajak Anda mengikuti program tersebut agar keterampilan analisis data terarah dan siap dipakai di dunia kerja.
Kursus Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.