Memahami Konsep Uji Normalitas dan Implementasinya dengan SciPy untuk Validasi Asumsi Statistik
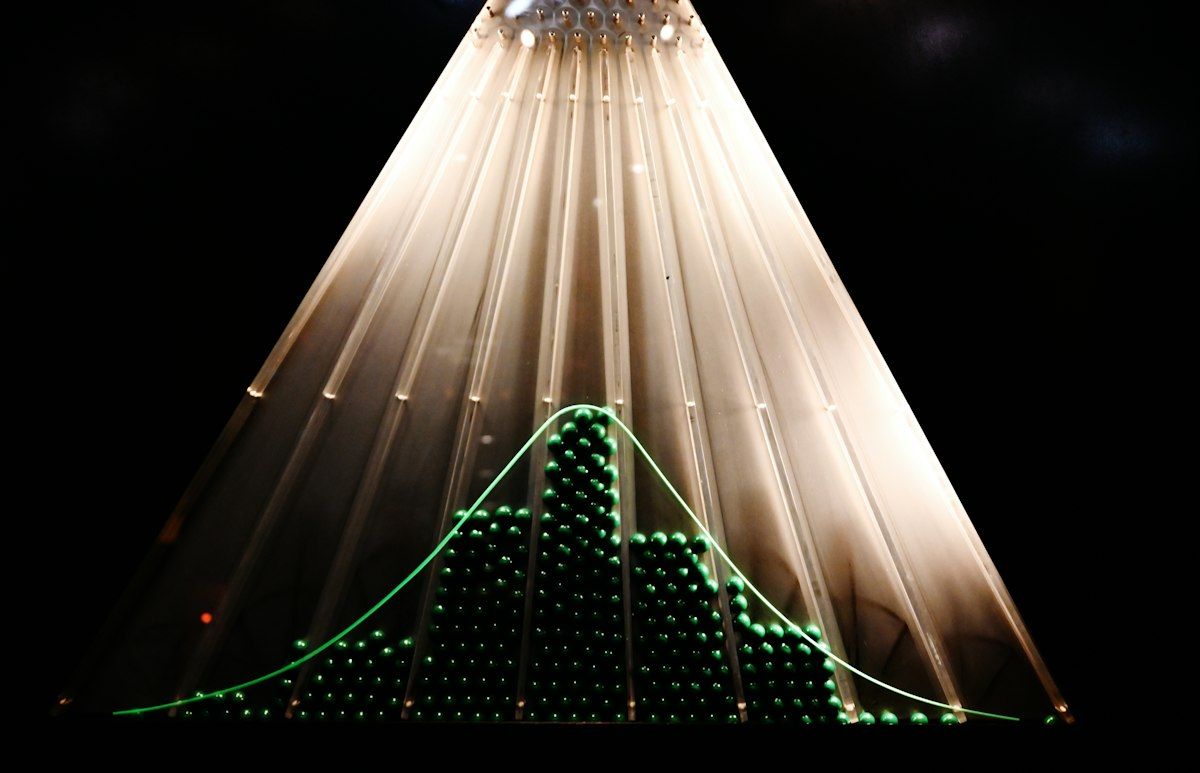
Mengapa Distribusi Normal Menentukan Pilihan Uji Statistik
Sebagian besar uji statistik yang kita pakai berdiri di atas satu asumsi dasar: data atau residual berasal dari distribusi normal. Uji t, ANOVA, dan regresi linear dengan interval kepercayaan berbasis t-distribution semuanya menurunkan nilai p-value dari asumsi tersebut. Ketika asumsi ini dilanggar, keputusan yang kita ambil kehilangan pijakan matematisnya.
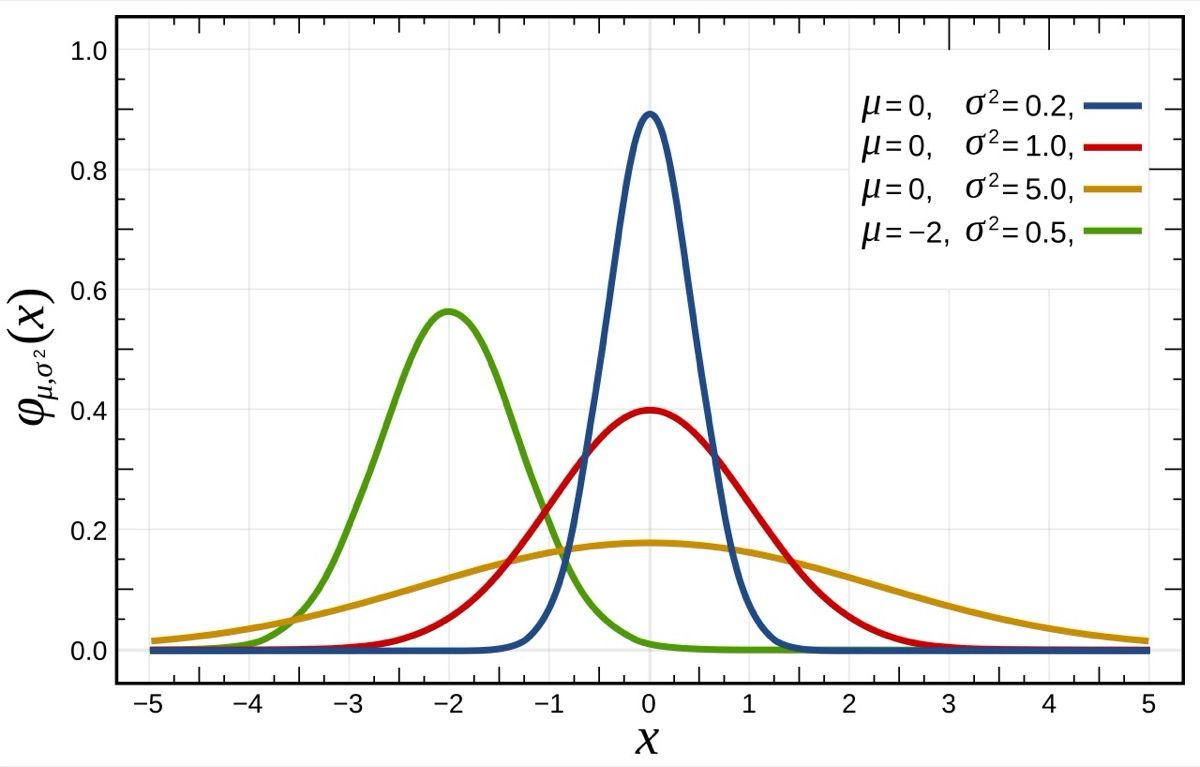
Gambar: Bentuk kurva distribusi normal ditentukan oleh rata-rata dan varians — Sumber: Wikimedia Commons
Objek yang diuji perlu diperjelas sejak awal. Normalitas diperiksa pada residual atau error, bukan pada variabel dependen mentah. Pada regresi linear, residual adalah selisih antara nilai observasi dan nilai prediksi model. Pada uji t dua sampel, yang diasumsikan normal adalah distribusi data di dalam masing-masing kelompok. Banyak analisis berakhir salah arah karena menguji normalitas kolom data mentah, lalu menyimpulkan bahwa modelnya valid.
Dampak pelanggaran asumsi bersifat bertingkat. Pada sampel kecil, distribusi sampling dari rata-rata belum tentu mendekati normal, sehingga p-value dapat menyimpang jauh dari nilai sebenarnya. Interval kepercayaan menjadi lebih lebar atau lebih sempit dari yang seharusnya. Pada model regresi, pelanggaran normalitas tidak membuat estimasi koefisien menjadi bias, tetapi membuat uji signifikansi dan interval kepercayaan tidak lagi dapat dipercaya.
Teorema Limit Pusat sering dijadikan pembenaran untuk mengabaikan pemeriksaan ini. Teorema tersebut menyatakan bahwa distribusi sampling dari rata-rata mendekati normal ketika ukuran sampel bertambah, bukan bahwa data mentah berubah menjadi normal. Pada sampel besar, rata-rata memang cukup stabil untuk banyak keperluan inferensi. Namun uji prediksi individual, interval toleransi, dan model dengan ekor distribusi tebal tetap membutuhkan validasi eksplisit.
Ketika normalitas terbukti dilanggar, kita memiliki beberapa jalur. Transformasi logaritma atau akar kuadrat dapat meredam kemiringan distribusi. Uji non-parametrik seperti Mann-Whitney dan Kruskal-Wallis melepas asumsi normalitas sepenuhnya. Pendekatan bootstrap membangun distribusi empiris dari data tanpa mengasumsikan bentuk tertentu. Pemilihan jalur bergantung pada pertanyaan penelitian dan struktur data, bukan pada hasil uji semata.
Membaca Bentuk Distribusi melalui Histogram dan Q-Q Plot
Langkah pertama dalam validasi normalitas adalah inspeksi visual. Kita bangkitkan dua sampel pembanding untuk melihat perbedaan bentuk distribusi secara langsung. Sampel pertama berasal dari distribusi normal, sedangkan sampel kedua berasal dari distribusi eksponensial yang memiliki ekor kanan panjang.
!pip install numpy pandas matplotlib scipy

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from scipy import stats

np.random.seed(42)

normal_sample = np.random.normal(loc=70, scale=8, size=300)
skewed_sample = np.random.exponential(scale=10, size=300) + 40

df = pd.DataFrame({
    'kelompok': ['normal'] * 300 + ['skewed'] * 300,
    'skor': np.concatenate([normal_sample, skewed_sample])
})

ringkasan = df.groupby('kelompok')['skor'].agg(
    mean='mean',
    std='std',
    skew='skew',
    kurtosis=lambda s: s.kurtosis()
)
print(ringkasan.round(3))

fig, axes = plt.subplots(2, 2, figsize=(12, 8))

for row, (label, values) in enumerate([('normal', normal_sample), ('skewed', skewed_sample)]):
    axes[row, 0].hist(values, bins=25, color='#3b82f6', edgecolor='white')
    axes[row, 0].set_title(f'Histogram - {label}')
    stats.probplot(values, dist='norm', plot=axes[row, 1])
    axes[row, 1].set_title(f'Q-Q Plot - {label}')

plt.tight_layout()
plt.show()
Output:
            mean     std   skew  kurtosis
kelompok
normal    69.956   7.874  0.175     0.597
skewed    50.633  11.378  2.093     6.337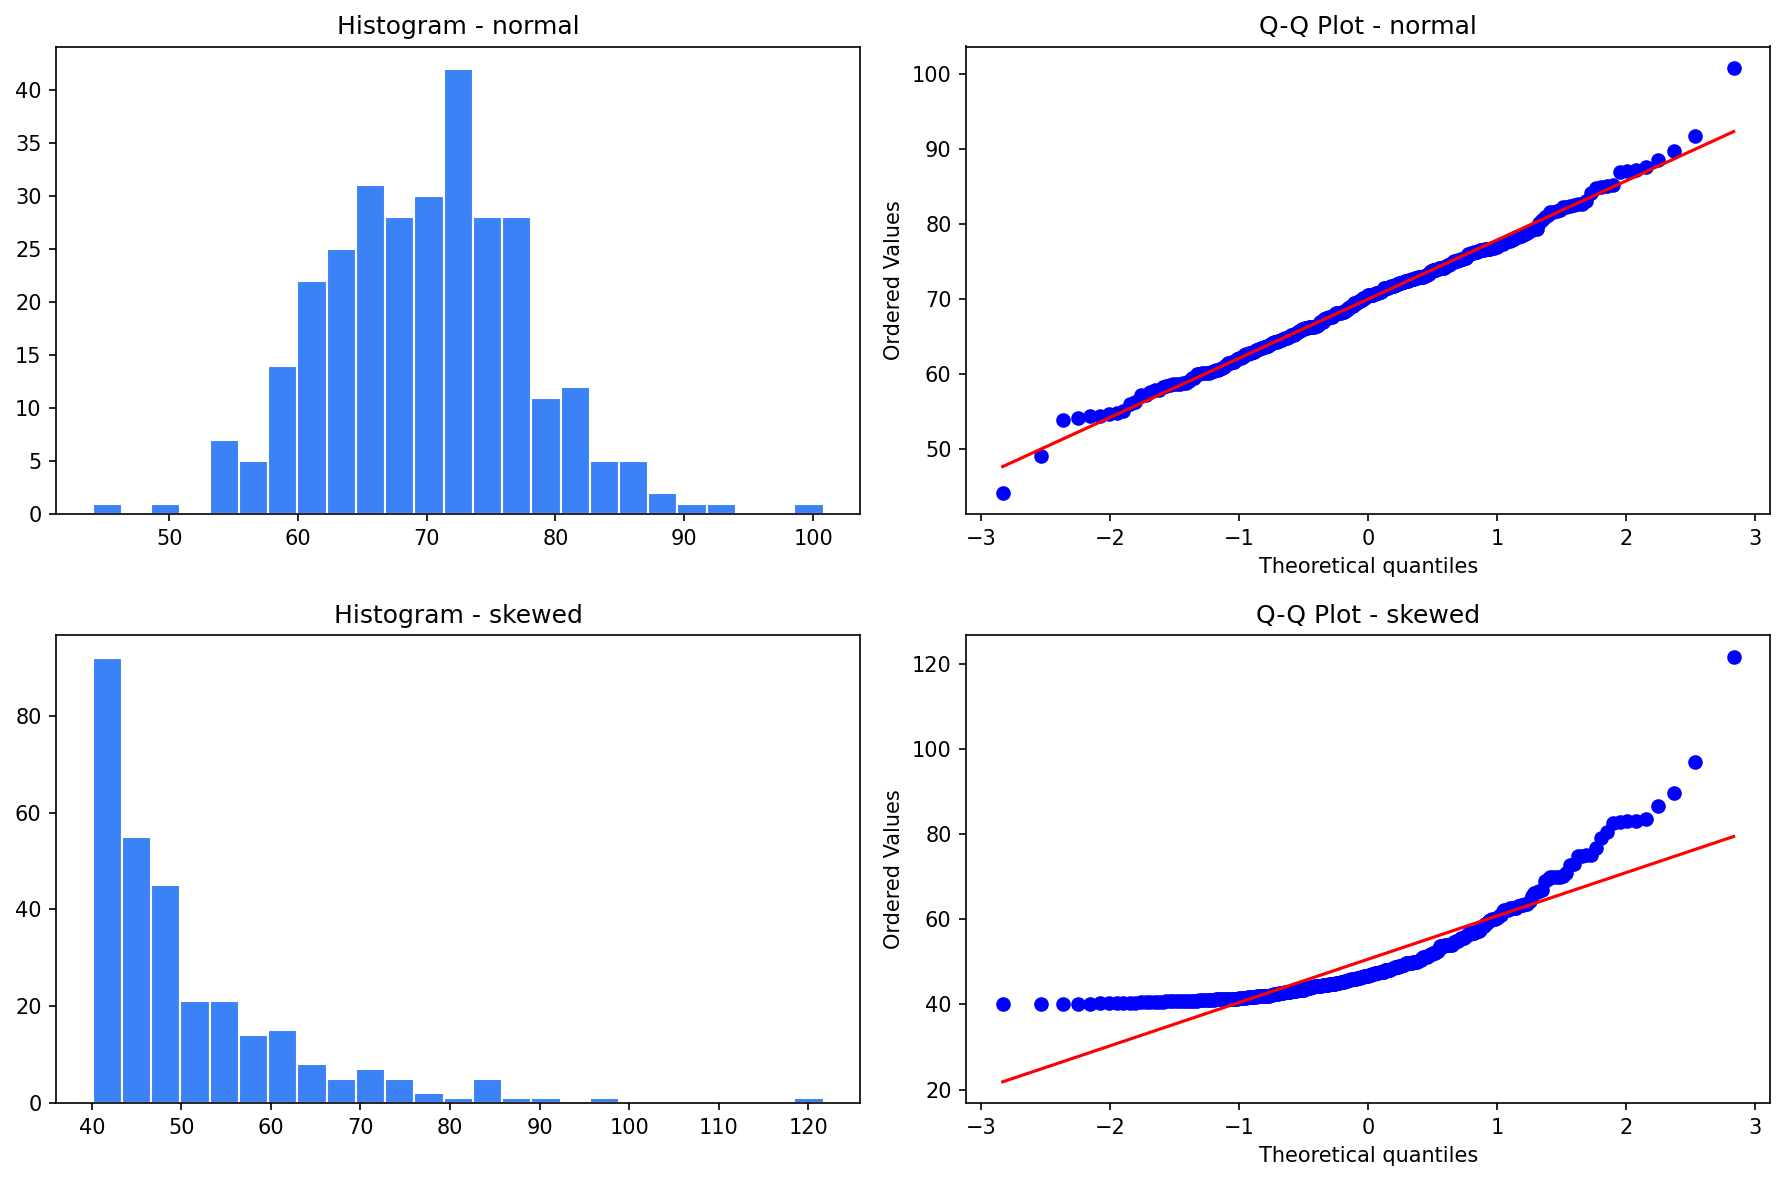
Blok kode di atas menyiapkan dua kelompok data dengan karakter berbeda, lalu membandingkannya lewat dua sudut pandang sekaligus. agg dengan skew dan kurtosis memberi indikator numerik awal: nilai kemiringan di sekitar nol mengarah ke bentuk simetris, sedangkan nilai positif besar menandakan ekor kanan yang panjang. Fungsi probplot dari SciPy memproyeksikan kuantil data terhadap kuantil distribusi normal teoretis.
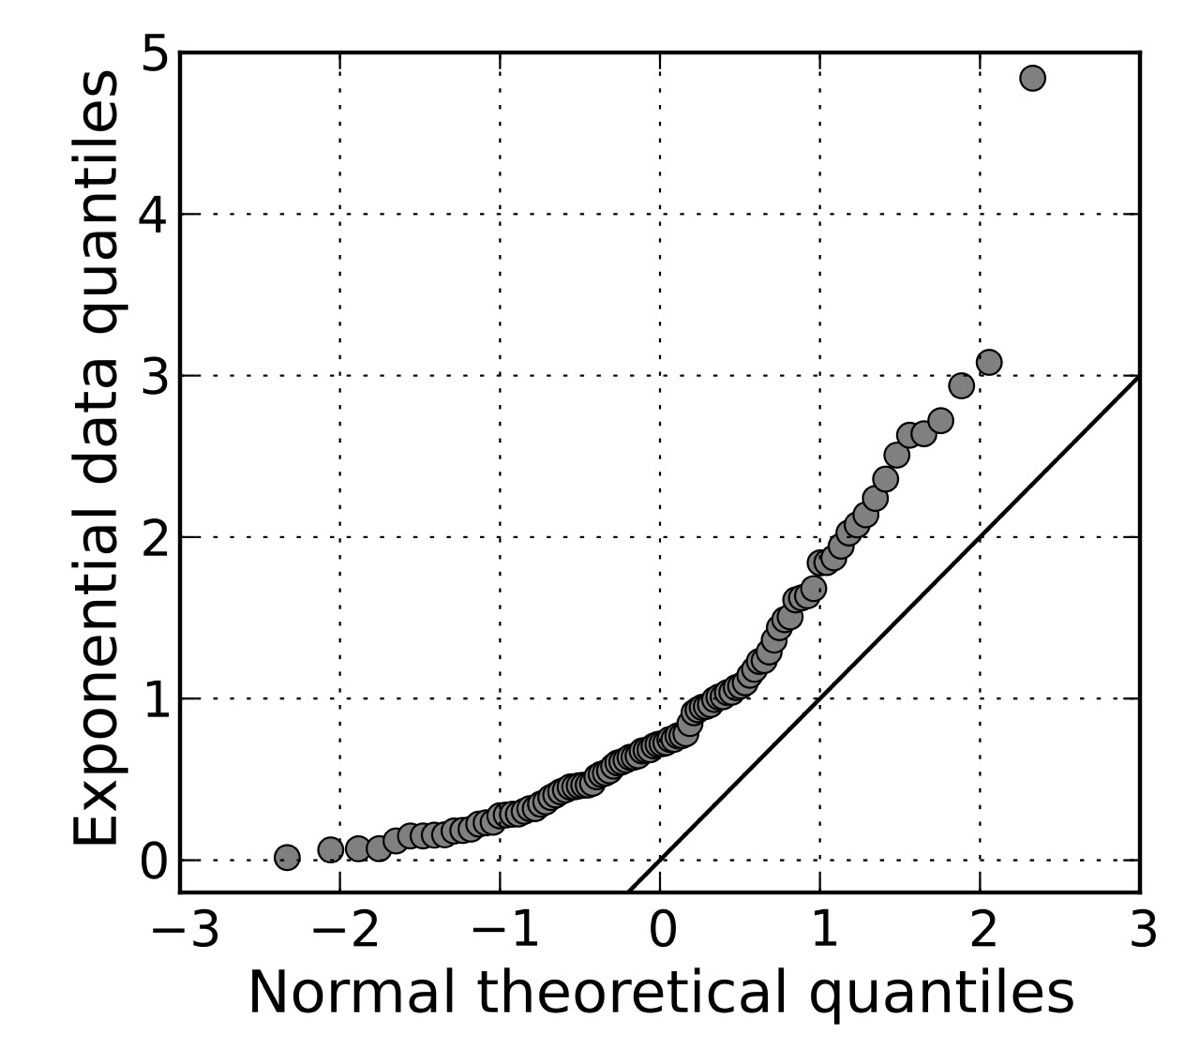
Hasil yang kita harapkan muncul dalam dua pola. Histogram data normal membentuk kurva lonceng simetris, sementara histogram data eksponensial menumpuk di sisi kiri dengan ekor memanjang ke kanan. Pada panel Q-Q, titik data normal menempel rapi di garis diagonal, sedangkan titik data eksponensial melengkung keluar dari garis di kedua ujung. Pola melengkung ke atas di ujung kanan menandakan ekor kanan yang lebih berat daripada distribusi normal.
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Gambar: Titik data eksponensial menyimpang dari garis referensi normal pada bagian ekor — Sumber: Wikimedia Commons, CC BY-SA 3.0 oleh Skbkekas
Inspeksi visual memiliki batas yang harus kita sadari. Penilaian bentuk histogram bergantung pada jumlah bin, dan dua analis dapat menyimpulkan hal berbeda dari gambar yang sama. Q-Q plot lebih informatif karena menunjukkan lokasi penyimpangan, tetapi tetap subjektif. Karena itu, visualisasi berfungsi sebagai pemeriksaan pendahuluan, bukan sebagai dasar keputusan final.
Mengukur Penyimpangan dengan Jarque-Bera dan Shapiro-Wilk
Uji formal mengubah pertanyaan visual menjadi hipotesis yang dapat diuji. H0 pada semua uji normalitas menyatakan bahwa data berasal dari distribusi normal, sedangkan H1 menyatakan sebaliknya. Kita menolak H0 ketika p-value berada di bawah tingkat signifikansi yang dipilih, umumnya alpha = 0.05.
for label, values in [('normal', normal_sample), ('skewed', skewed_sample)]:
    jb_stat, jb_p = stats.jarque_bera(values)
    sw_stat, sw_p = stats.shapiro(values)

    print(f'{label:>7} | Jarque-Bera: stat={jb_stat:8.3f} p={jb_p:.4f}')
    print(f'{label:>7} | Shapiro-Wilk: stat={sw_stat:8.3f} p={sw_p:.6f}')
Output:
 normal | Jarque-Bera: stat=   5.537 p=0.0628
 normal | Shapiro-Wilk: stat=   0.994 p=0.305689
 skewed | Jarque-Bera: stat= 699.154 p=0.0000
 skewed | Shapiro-Wilk: stat=   0.792 p=0.000000
Uji Jarque-Bera bekerja dengan menggabungkan dua momen distribusi, yaitu skewness dan kurtosis. Nilai statistiknya membesar ketika kombinasi kedua momen menyimpang dari nilai yang diharapkan pada distribusi normal. Uji ini mudah dihitung dan cocok untuk sampel besar, tetapi kurang sensitif pada sampel kecil karena estimasi momen menjadi tidak stabil.
Uji Shapiro-Wilk mengambil pendekatan berbeda dengan membandingkan urutan statistik data terhadap nilai yang diharapkan dari distribusi normal. Daya statistiknya lebih tinggi pada sampel kecil, sehingga uji ini menjadi pilihan utama untuk data dengan ratusan observasi. Batas praktisnya sekitar 5000 observasi; di atas angka tersebut, sebagian implementasi mulai kehilangan akurasi dan p-value cenderung menolak H0 terlalu sering.
Output yang diharapkan dari blok di atas adalah dua keputusan yang berbeda arah. Untuk data normal, kedua uji menghasilkan p-value di atas 0.05 sehingga H0 tidak ditolak. Nilai Jarque-Bera tercatat sekitar 0.063, cukup dekat dengan batas, sementara Shapiro-Wilk memberi p-value sekitar 0.306 yang lebih meyakinkan. Untuk data eksponensial, kedua uji menghasilkan p-value mendekati nol sehingga H0 ditolak dengan selisih statistik yang sangat besar. Kesepakatan antara dua uji dengan mekanisme berbeda memperkuat keyakinan kita terhadap kesimpulan.
Angka p-value perlu dibaca dengan hati-hati. Nilai tersebut mengukur seberapa tidak mungkin data yang kita amati jika H0 benar, bukan probabilitas bahwa H0 benar. p-value sebesar 0.20 bukan bukti bahwa data berdistribusi normal, melainkan bukti bahwa kita tidak memiliki cukup alasan untuk menolaknya.
Menangani Sampel Besar dengan Anderson-Darling dan Kolmogorov-Smirnov
Sampel besar membawa masalah tersendiri. Ketika jumlah observasi mencapai puluhan ribu, hampir setiap penyimpangan kecil terdeteksi sebagai signifikan. Uji normalitas berubah menjadi alat yang terlalu peka, dan analis sering menerima keputusan penolakan yang tidak relevan secara praktis.
large_sample = np.random.chisquare(df=30, size=20000)

ad_result = stats.anderson(large_sample, dist='norm')
print(f'Anderson-Darling A2 = {ad_result.statistic:.3f}')

for alpha, critical in zip(ad_result.significance_level, ad_result.critical_values):
    decision = 'reject H0' if ad_result.statistic > critical else 'fail to reject H0'
    print(f'  alpha {alpha:>4}% -> critical {critical:.3f} | {decision}')

ks_result = stats.kstest(
    large_sample,
    'norm',
    args=(large_sample.mean(), large_sample.std())
)
print(f'Kolmogorov-Smirnov D = {ks_result.statistic:.4f}, p-value = {ks_result.pvalue:.4f}')
Output:
Anderson-Darling A2 = 63.670
  alpha 15.0% -> critical 0.576 | reject H0
  alpha 10.0% -> critical 0.656 | reject H0
  alpha  5.0% -> critical 0.787 | reject H0
  alpha  2.5% -> critical 0.918 | reject H0
  alpha  1.0% -> critical 1.092 | reject H0
Kolmogorov-Smirnov D = 0.0377, p-value = 0.0000
Uji Anderson-Darling memberi bobot lebih besar pada penyimpangan di ekor distribusi. Nilai statistik A² dibandingkan langsung dengan tabel critical values pada beberapa tingkat signifikansi, sehingga kita tidak bergantung pada satu alpha tunggal. Bobot tambahan di ekor membuat uji ini lebih relevan untuk model yang sensitif terhadap nilai ekstrem, seperti model risiko.
Uji Kolmogorov-Smirnov membandingkan fungsi distribusi kumulatif empiris dengan fungsi distribusi normal teoretis. Jarak maksimum antara keduanya menjadi statistik D. Pada pemakaian dengan parameter yang diestimasi dari data, p-value dari kstest bersifat konservatif dan cenderung terlalu besar. Koreksi Lilliefors tersedia untuk kasus ini, dan pemakaian kstest tanpa koreksi perlu dicatat sebagai keterbatasan analisis.
Hasil yang kita amati untuk data chi-square dengan derajat kebebasan 30 adalah penolakan H0 pada semua tingkat signifikansi. Distribusi chi-square memang mendekati normal ketika derajat kebebasannya besar, tetapi tetap memiliki kemiringan positif. Dengan 20000 observasi, kemiringan kecil tersebut cukup untuk melewati nilai kritis. Temuan ini memperlihatkan bahwa signifikansi statistik tidak otomatis berarti penyimpangan yang penting.
Cara membaca situasi tersebut adalah dengan membandingkan ukuran efek. Kita dapat menghitung selisih rata-rata dan median, memeriksa rentang skewness, atau membandingkan kuantil ekor data dengan kuantil normal teoretis. Ketika penyimpangan hanya muncul di digit ketiga, keputusan untuk tetap memakai uji parametrik masih dapat dipertanggungjawabkan selama kita menuliskannya di laporan.
Menyusun Alur Keputusan Validasi Asumsi yang Dapat Dipertanggungjawabkan
Pemilihan uji sebaiknya ditentukan sebelum data dianalisis, bukan setelah hasilnya terlihat. Untuk sampel di bawah 50 observasi, Shapiro-Wilk adalah pilihan paling sensitif. Pada rentang ratusan hingga beberapa ribu observasi, Shapiro-Wilk dan Anderson-Darling dapat dipakai berdampingan. Untuk sampel di atas 5000 observasi, Anderson-Darling dengan pembacaan critical values lebih informatif daripada p-value tunggal.
Menjalankan banyak uji lalu memilih hasil yang paling menguntungkan adalah praktik yang harus dihindari. Setiap uji menambah peluang kesalahan tipe I, dan pemilihan berdasarkan hasil membuat p-value kehilangan makna. Tetapkan satu uji utama, satu uji pendukung, dan laporkan seluruh hasil apa adanya.
Ketika normalitas ditolak, kita memiliki tiga jalur yang dapat dijustifikasi. Transformasi seperti np.log1p atau akar kuadrat membantu ketika kemiringan berasal dari skala pengukuran. Uji non-parametrik menghindari asumsi bentuk distribusi sepenuhnya. Bootstrap membangun distribusi sampling empiris dan sering menjadi pilihan paling aman untuk statistik yang tidak memiliki padanan non-parametrik.
Dokumentasi hasil uji asumsi sama pentingnya dengan hasil uji hipotesis utama. Catat uji yang dipakai, ukuran sampel, nilai statistik, dan keputusan yang diambil. Pembaca laporan perlu tahu mengapa uji parametrik dipilih atau mengapa jalur non-parametrik ditempuh. Praktik ini membuat analisis dapat direproduksi dan dipertahankan ketika dipertanyakan.
Dengan alur yang konsisten, uji normalitas berubah dari formalitas di akhir analisis menjadi bagian dari desain. Kita memeriksa asumsi, memahami konsekuensinya, lalu memilih metode yang sesuai dengan kondisi data. Disiplin ini yang membedakan analisis statistik yang meyakinkan dari sekadar deretan angka p-value.
Ingin memperdalam statistik inferensial dan validasi asumsi dengan Python? Bootcamp Data Science di Rumah Coding membahas alur ini dari dasar hingga studi kasus nyata bersama mentor.
Kursus Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.