Memahami Algoritma CatBoost dan Implementasinya untuk Klasifikasi Data Kategorik tanpa Encoding Manual
Mengapa Data Kategorik Menjadi Hambatan pada Gradient Boosting
Dataset produksi jarang datang dalam bentuk matriks angka yang rapi. Kolom seperti kota, paket_langganan, kanal_akuisisi, dan status_pembayaran disimpan sebagai teks karena memang itu makna aslinya. Algoritma gradient boosting klasik hanya menerima nilai numerik, sehingga kolom teks harus diubah lebih dulu sebelum proses training bisa dimulai.
Pilihan encoding yang paling sering dipakai adalah OneHotEncoder. Pendekatan ini bekerja baik pada kolom dengan sedikit nilai unik. Masalah muncul ketika kardinalitas naik: kolom kota dengan 300 nilai unik menghasilkan 300 kolom biner, dan hampir seluruh isinya nol. Model menerima dimensi besar tanpa tambahan informasi, sementara waktu training dan konsumsi memori ikut meningkat.
LabelEncoder menyelesaikan masalah dimensi, tetapi menciptakan masalah lain. Pemetaan Jakarta=0, Bandung=1, Surabaya=2 memberi kesan bahwa Bandung berada di antara Jakarta dan Surabaya. Pada data non-ordinal, urutan semacam ini adalah sinyal palsu yang harus dipelajari model, dan sering berakhir sebagai sumber overfitting pada data baru.
Target encoding manual terdengar lebih masuk akal karena kategori diganti dengan rata-rata target. Implementasi naif menghitung statistik dari seluruh dataset, termasuk baris yang sedang di-encode. Akibatnya statistik target bocor ke dalam fitur, model melihat sebagian label saat training, dan skor validasi menjadi terlalu optimistis. Churn rate per kota yang dihitung dari baris yang sama dengan labelnya sendiri bukan fitur, melainkan kebocoran.
Konsekuensi praktisnya jelas. Pipeline menjadi panjang, berisi beberapa tahap encoding yang harus disesuaikan antara data training dan data inference, serta rawan bug ketika kategori baru muncul di produksi. CatBoost memindahkan seluruh pekerjaan ini ke dalam algoritma, sehingga kita cukup menandai kolom kategorik dan membiarkan library mengurus representasinya.
Bagaimana CatBoost Mengubah Fitur Kategorik Menjadi Statistik Target yang Aman
CatBoost adalah implementasi gradient boosting pada decision tree dengan dua gagasan utama: penanganan fitur kategorik bawaan dan ordered boosting. Fitur kategorik tidak diubah menjadi kolom biner. Setiap kategori diganti dengan estimasi statistik target yang dihitung secara berurutan mengikuti permutasi acak pada data.
Mekanisme ini disebut Ordered Target Statistics. Setiap baris hanya boleh memakai agregasi target dari baris yang muncul lebih awal dalam permutasi. Baris pertama tidak punya riwayat, sehingga nilainya diisi dengan prior, yaitu rata-rata target keseluruhan. Dengan aturan tersebut, label baris yang sedang dihitung tidak pernah ikut dalam statistiknya sendiri. Kebocoran yang sebelumnya muncul pada target encoding manual hilang tanpa perlu validasi tambahan.
Analogi singkatnya, ordered target statistics seperti statistik yang hanya diizinkan melihat masa lalu, bukan masa depan.
Beberapa detail teknis perlu diingat. Kolom kategorik ditandai lewat parameter cat_features, bisa berupa daftar nama kolom atau indeks posisi. Nilai di dalam kolom tersebut harus bertipe string atau int; tipe float akan ditolak. Nilai NaN diperlakukan sebagai kategori tersendiri, bukan sebagai data hilang yang harus diimputasi.
Parameter one_hot_max_size menentukan batas jumlah kategori yang tetap diubah menjadi one-hot encoding. Nilai default-nya bergantung pada loss_function, dan menaikkannya bisa membantu pada kolom dengan kategori sedikit. Untuk kolom ber-kardinalitas tinggi, jalur ordered statistics yang dipakai.
Struktur pohon default CatBoost adalah SymmetricTree, di mana seluruh node pada level yang sama memakai split feature dan threshold yang identik. Struktur ini kurang fleksibel dibanding pohon asimetris, tetapi lebih cepat saat inference dan bertindak sebagai regularisasi alami. Mode grow_policy="Lossguide" atau "Depthwise" tersedia ketika data menuntut partisi yang lebih bebas.
Melatih Model CatBoost Pertama pada Dataset Kategorik Mentah
Contoh berikut memakai dataset churn sintetis dengan tiga kolom kategorik dan dua kolom numerik. Dataset dibangun langsung di dalam kode agar contoh dapat dijalankan tanpa mengunduh berkas eksternal.
!pip install catboost scikit-learn pandas numpy

import numpy as np
import pandas as pd
from catboost import CatBoostClassifier

rng = np.random.default_rng(42)
n_rows = 3000

df = pd.DataFrame({
    "kota": rng.choice(["Jakarta", "Bandung", "Surabaya", "Medan"], n_rows),
    "paket": rng.choice(["basic", "pro", "enterprise"], n_rows, p=[0.5, 0.35, 0.15]),
    "kanal": rng.choice(["organic", "ads", "referral"], n_rows),
    "tenure_bulan": rng.integers(1, 36, n_rows),
    "tagihan_bulanan": np.round(rng.normal(250000, 60000, n_rows), -3),
})

risk = (
    (df["paket"] == "basic").astype(int) * 0.9
    + (df["kanal"] == "ads").astype(int) * 0.4
    + (df["tenure_bulan"] < 6).astype(int) * 0.7
    + rng.normal(0, 0.8, n_rows)
)
df["churn"] = (risk > 1.2).astype(int)

cat_features = ["kota", "paket", "kanal"]
X = df.drop(columns="churn")
y = df["churn"]

model = CatBoostClassifier(
    iterations=400,
    learning_rate=0.05,
    depth=6,
    cat_features=cat_features,
    eval_metric="AUC",
    random_seed=42,
    verbose=100,
)

model.fit(X, y)
print(model.predict_proba(X.head(3))[:, 1].round(3))
Output:
0:	total: 58.3ms	remaining: 23.3s
100:	total: 221ms	remaining: 654ms
200:	total: 394ms	remaining: 390ms
300:	total: 593ms	remaining: 195ms
399:	total: 802ms	remaining: 0us
[0.136 0.041 0.839]
Alur kode di atas sengaja mengikuti urutan yang sama dengan pipeline produksi. Kolom teks tetap berupa string di DataFrame, dan cat_features memberi tahu estimator kolom mana yang harus diperlakukan sebagai kategorik. CatBoost kemudian menghitung ordered target statistics di dalam proses training, jadi tidak ada tahap fit_transform terpisah yang perlu disimpan dan diterapkan ulang di inference.
Karena cat_features sudah dideklarasikan di constructor, pemanggilan fit cukup menerima X dan y. Parameter verbose=100 mencetak progres training setiap 100 iterasi tanpa eval_set. Dari situ kita bisa melihat berapa lama setiap iterasi berjalan dan kapan proses berhenti. Hasil akhirnya berupa array tiga probabilitas kelas churn, satu nilai untuk setiap baris pada X.head(3).
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Mengevaluasi Model dengan Cross-Validation Stratified dan Holdout Test
Satu train_test_split tunggal tidak cukup untuk dataset churn, karena proporsi kelas positif yang kecil membuat skor sangat bergantung pada cara data dibagi. CatBoost menyediakan cv() yang menjalankan cross-validation di dalam library, dengan dukungan stratified=True untuk menjaga komposisi kelas pada setiap fold.
from catboost import Pool, cv
from sklearn.metrics import classification_report, roc_auc_score
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

train_pool = Pool(X_train, y_train, cat_features=cat_features)
test_pool = Pool(X_test, y_test, cat_features=cat_features)

cv_result = cv(
    params={
        "iterations": 400,
        "learning_rate": 0.05,
        "depth": 6,
        "loss_function": "Logloss",
        "eval_metric": "AUC",
    },
    pool=train_pool,
    fold_count=5,
    stratified=True,
    verbose=False,
)
print("mean AUC:", round(cv_result["test-AUC-mean"].mean(), 4))

final_model = CatBoostClassifier(
    iterations=400,
    learning_rate=0.05,
    depth=6,
    eval_metric="AUC",
    random_seed=42,
    verbose=False,
)
final_model.fit(train_pool, eval_set=test_pool)

pred = final_model.predict(X_test)
print(classification_report(y_test, pred, target_names=["retain", "churn"]))
print("holdout AUC:", round(roc_auc_score(y_test, final_model.predict_proba(X_test)[:, 1]), 4))
Output:
Training on fold [0/5]

bestTest = 0.7847309136
bestIteration = 7

Training on fold [1/5]

bestTest = 0.7675323321
bestIteration = 45

Training on fold [2/5]

bestTest = 0.7825105042
bestIteration = 1

Training on fold [3/5]

bestTest = 0.7290771176
bestIteration = 292

Training on fold [4/5]

bestTest = 0.7615676359
bestIteration = 169

mean AUC: 0.7538
              precision    recall  f1-score   support

      retain       0.78      0.90      0.84       424
       churn       0.62      0.38      0.47       176

    accuracy                           0.75       600
   macro avg       0.70      0.64      0.65       600
weighted avg       0.73      0.75      0.73       600

holdout AUC: 0.7385
Pool adalah pembungkus data yang menyimpan cat_features bersama fitur dan label. Objek ini penting karena cv() dan eval_set membaca metadata dari Pool, bukan dari DataFrame mentah. Tanpa Pool, kita harus mengulang deklarasi cat_features di setiap pemanggilan.
cv_result berupa DataFrame dengan satu baris per fold dan kolom test-AUC-mean. Nilai rata-rata kolom tersebut adalah estimasi performa yang jauh lebih stabil dibanding satu split. Setelah itu model final dilatih pada seluruh data training dengan eval_set sebagai pemantau, lalu dievaluasi pada holdout set yang belum pernah dilihat.
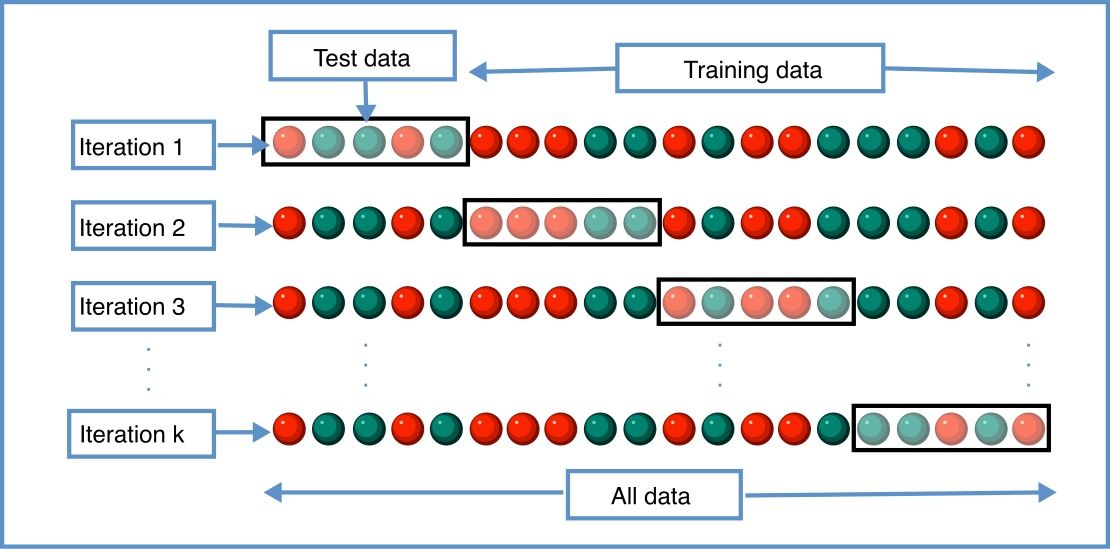
Gambar: Ilustrasi k-fold cross-validation, setiap iterasi memakai satu fold sebagai data uji dan fold lainnya sebagai data latih — Sumber: Wikimedia Commons
Output yang diharapkan: satu angka mean AUC, tabel classification_report berisi precision, recall, dan F1 untuk label retain dan churn, serta satu angka holdout AUC. Selisih besar antara mean AUC dan holdout AUC menandakan pembagian data yang kurang representatif atau model yang terlalu menyesuaikan diri pada fold tertentu.
Menyetel Hyperparameter CatBoost secara Terarah
Tiga parameter memberi dampak paling besar pada performa: depth, learning_rate, dan l2_leaf_reg. depth mengatur kedalaman maksimum pohon simetris. Nilai lebih besar menambah kapasitas model tetapi juga menaikkan risiko overfitting pada dataset berukuran kecil. learning_rate yang rendah biasanya menuntut iterations lebih banyak, dan l2_leaf_reg mengatur kekuatan regularisasi pada leaf.
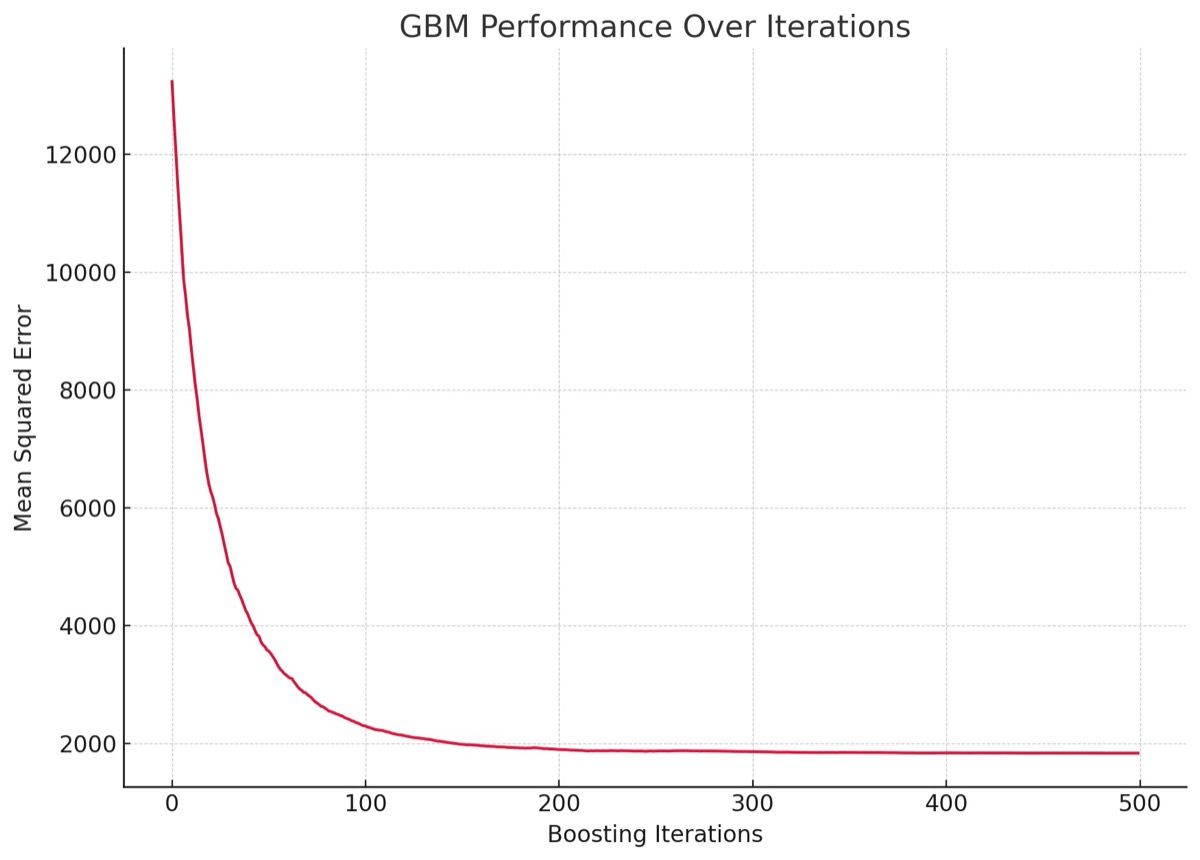
Gambar: Kurva error pada test set terhadap jumlah iterasi boosting, perbaikan terbesar terjadi di iterasi awal lalu melandai — Sumber: Wikimedia Commons
Pencarian grid kecil masih masuk akal secara komputasi untuk tiga parameter tersebut. Kita menjalankan pencarian itu lewat loop eksplisit, bukan lewat GridSearchCV. Sejak scikit-learn 1.6, fungsi clone() menuntut setiap parameter constructor tersimpan apa adanya, sementara CatBoostClassifier menyimpan salinan nilai cat_features. GridSearchCV dan cross_val_score memanggil clone() di balik layar, sehingga keduanya gagal dengan RuntimeError pada kombinasi catboost 1.2 dan scikit-learn 1.7. Loop manual memanggil fit() langsung pada setiap fold tanpa pernah menyalin estimator.
import pandas as pd
from catboost import CatBoostClassifier
from sklearn.metrics import roc_auc_score
from sklearn.model_selection import StratifiedKFold

candidates = [
    {"depth": 4, "learning_rate": 0.05, "l2_leaf_reg": 3},
    {"depth": 6, "learning_rate": 0.05, "l2_leaf_reg": 3},
    {"depth": 6, "learning_rate": 0.1, "l2_leaf_reg": 3},
    {"depth": 6, "learning_rate": 0.05, "l2_leaf_reg": 9},
    {"depth": 8, "learning_rate": 0.05, "l2_leaf_reg": 3},
]

skf = StratifiedKFold(n_splits=3, shuffle=True, random_state=42)
results = []

for params in candidates:
    fold_scores = []
    for train_idx, valid_idx in skf.split(X_train, y_train):
        fold_model = CatBoostClassifier(
            iterations=200,
            cat_features=cat_features,
            eval_metric="AUC",
            random_seed=42,
            verbose=False,
            **params,
        )
        fold_model.fit(X_train.iloc[train_idx], y_train.iloc[train_idx])
        valid_prob = fold_model.predict_proba(X_train.iloc[valid_idx])[:, 1]
        fold_scores.append(roc_auc_score(y_train.iloc[valid_idx], valid_prob))
    results.append({**params, "mean_auc": round(sum(fold_scores) / len(fold_scores), 4)})

results_df = pd.DataFrame(results).sort_values("mean_auc", ascending=False)
print(results_df.to_string(index=False))

best_row = results_df.iloc[0]
best_params = {
    "depth": int(best_row["depth"]),
    "learning_rate": float(best_row["learning_rate"]),
    "l2_leaf_reg": int(best_row["l2_leaf_reg"]),
}

final_model = CatBoostClassifier(
    iterations=400,
    cat_features=cat_features,
    eval_metric="AUC",
    random_seed=42,
    verbose=False,
    **best_params,
)
final_model.fit(train_pool, eval_set=test_pool)

print("best params:", best_params)
print("best CV AUC:", results_df.iloc[0]["mean_auc"])
print("final holdout AUC:", round(roc_auc_score(y_test, final_model.predict_proba(X_test)[:, 1]), 4))

importance = pd.Series(
    final_model.get_feature_importance(),
    index=X_train.columns,
).sort_values(ascending=False)
print(importance.round(2))
Output:
 depth  learning_rate  l2_leaf_reg  mean_auc
     6           0.05            9    0.7628
     4           0.05            3    0.7618
     6           0.05            3    0.7584
     8           0.05            3    0.7516
     6           0.10            3    0.7430
best params: {'depth': 6, 'learning_rate': 0.05, 'l2_leaf_reg': 9}
best CV AUC: 0.7628
final holdout AUC: 0.7322
paket              31.34
tenure_bulan       24.60
kanal              17.86
tagihan_bulanan    15.20
kota               11.00
dtype: float64
Setiap kandidat diuji pada tiga fold StratifiedKFold, lalu skor roc_auc_score dari tiap fold dirata-ratakan menjadi satu nilai mean_auc. results_df mengurutkan kandidat dari yang terbaik, baris teratas dibaca sebagai best_params, dan model final dilatih pada seluruh data training dengan parameter tersebut.
Tabel output memperlihatkan bahwa l2_leaf_reg=9 sedikit mengungguli kombinasi lain, sementara learning_rate=0.1 justru menurunkan AUC pada dataset kecil ini. Setelah model final dilatih, kita mencetak AUC holdout dan get_feature_importance() untuk melihat kontribusi setiap fitur. Jika kolom kategorik muncul di urutan atas, artinya ordered target statistics benar-benar dipakai model dan bukan sekadar label tanpa makna.
Membaca Feature Importance dan Menjaga Model di Produksi
get_feature_importance() dengan tipe default FeatureImportance mengukur rata-rata perubahan prediksi ketika sebuah fitur dipakai pada split. Untuk interpretasi per baris, get_feature_importance(type="ShapValues") memberi kontribusi setiap fitur terhadap prediksi satu observasi. Kedua pendekatan menjawab pertanyaan berbeda: yang pertama untuk memahami model secara global, yang kedua untuk menjelaskan satu keputusan.
Sebelum model dipakai di produksi, ada dua pemeriksaan data yang perlu dijalankan. Pertama, pastikan tipe kolom kategorik tetap string atau int. Perubahan tipe akibat proses ETL sering menjadi penyebab error saat inference. Kedua, catat daftar kategori yang terlihat saat training. Kategori baru yang belum pernah muncul akan diperlakukan sebagai nilai tak dikenal, dan perilakunya perlu diuji secara eksplisit.
Penyimpanan model memakai save_model("churn.cbm", format="cbm") dan dimuat kembali dengan CatBoostClassifier().load_model("churn.cbm"). Format cbm menyimpan metadata cat_features bersama model, sehingga pemuatan ulang tidak memerlukan konfigurasi tambahan. Format json lebih mudah dibaca manusia tetapi berukuran lebih besar dan lebih lambat dimuat.
Setelah deployment, pantau dua hal: distribusi kategori per periode dan metrik per segmen. Penurunan performa sering muncul lebih dulu pada segmen kecil, misalnya kanal=referral di kota tertentu, jauh sebelum skor agregat bergerak. Pemantauan per segmen membuat regresi terdeteksi lebih awal.
Ringkasan Alur Kerja CatBoost untuk Data Kategorik
Alur kerja CatBoost untuk data kategorik dapat diringkas menjadi empat langkah. Tandai kolom kategorik lewat cat_features, latih model pada DataFrame mentah atau lewat Pool, evaluasi dengan cv() dan holdout set, lalu setel depth, learning_rate, dan l2_leaf_reg seperlunya.
Encoding manual tidak lagi menjadi bagian wajib dari pipeline. Kita tidak perlu menyimpan OneHotEncoder yang sudah di-fit, dan tidak perlu menulis logika target encoding sendiri. Semua representasi kategorik dihitung di dalam training, dengan mekanisme yang memang dirancang untuk mencegah kebocoran label.
Encoding manual tetap relevan pada dua kondisi. Pertama, ketika model harus dipindahkan ke library lain yang tidak mendukung fitur kategorik, misalnya untuk perbandingan performa antar algoritma. Kedua, ketika aturan bisnis menuntut pemetaan kategori yang eksplisit dan dapat diaudit, misalnya pada pelaporan risiko.
Ingin mempraktikkan gradient boosting dan penanganan data kategorik pada studi kasus nyata? Kelas Machine Learning di Rumah Coding membahas pipeline data end-to-end, dari eksplorasi dataset sampai evaluasi model dan deployment sederhana. Lihat jadwal bootcamp Data Science kami untuk mulai dari fondasi yang benar.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Related Articles
Memahami Konsep Multi-Armed Bandit dan Implementasinya dengan Thompson Sampling untuk Eksperimen A/B Testing
Memahami Type Hinting di Python: Static Analysis dengan mypy dan Validasi Runtime dengan Pydantic