Memahami Konsep Analisis Survival dan Implementasinya dengan lifelines untuk Data Time-to-Event
Mengapa Data Time-to-Event Butuh Metode Khusus
Banyak dataset di praktik menyimpan durasi sampai sebuah kejadian: berapa bulan pelanggan bertahan sebelum churn, berapa jam mesin beroperasi sebelum gagal, atau berapa hari pengguna aktif sebelum berhenti berlangganan. Pertanyaan seperti ini terlihat sederhana karena jawabannya berupa angka waktu. Namun, struktur datanya berbeda dari data tabular biasa, sehingga rata-rata durasi tidak cukup untuk menjawabnya.
Sumber utama perbedaan itu adalah observasi yang belum mencapai kejadian saat pengamatan berakhir. Sebagian pelanggan mungkin masih aktif ketika periode analisis ditutup. Kita hanya tahu bahwa mereka bertahan setidaknya sampai titik tersebut, bukan berapa lama mereka akan bertahan. Kondisi ini disebut right censoring, dan mengabaikannya akan merusak kesimpulan.
Regresi linear biasa menghadapi masalah yang sama. Membuang semua baris censored membuat kita kehilangan informasi dari individu yang justru paling lama bertahan. Menandai durasi censored sebagai durasi penuh juga salah, karena estimasi durasi menjadi terlalu rendah. Kedua pendekatan tersebut menghasilkan bias yang sulit dikoreksi setelah model terlanjur dilatih.
Karena itu, dataset survival selalu disusun dari tiga komponen. Durasi T mencatat waktu sampai kejadian atau sampai pengamatan berhenti. Indikator event E bernilai 1 ketika kejadian benar-benar terjadi dan 0 ketika observasi censored. Kovariat menyimpan karakteristik yang ingin kita uji pengaruhnya terhadap risiko. Dari ketiga komponen ini, analisis survival menghasilkan tiga keluaran: kurva probabilitas bertahan, perbandingan antar kelompok, dan besar pengaruh kovariat. Pertanyaan pun bergeser dari "berapa lama rata-rata" menjadi "berapa probabilitas bertahan pada waktu tertentu".
Membaca Survival Function dan Hazard Function dari Dua Sudut Pandang
Survival function S(t) = P(T > t) menyatakan probabilitas individu bertahan melewati waktu t. Nilainya dimulai dari 1 pada waktu nol dan menurun monoton seiring bertambahnya t. Bentuk kurva inilah yang biasanya kita tampilkan ketika ingin menunjukkan seberapa lama sebuah populasi bertahan.
Hazard function h(t) = f(t) / S(t) menjelaskan hal yang berbeda. Fungsi ini mengukur laju kejadian sesaat pada waktu t, dengan syarat individu masih bertahan sampai titik itu. Hazard rate bisa dibaca seperti denyut pada monitor pasien: yang ditampilkan adalah laju kejadian pada detik itu, bukan total kejadian sepanjang hari. Karena berupa laju, nilainya tidak dibatasi antara 0 dan 1 dan bisa melebihi 1.
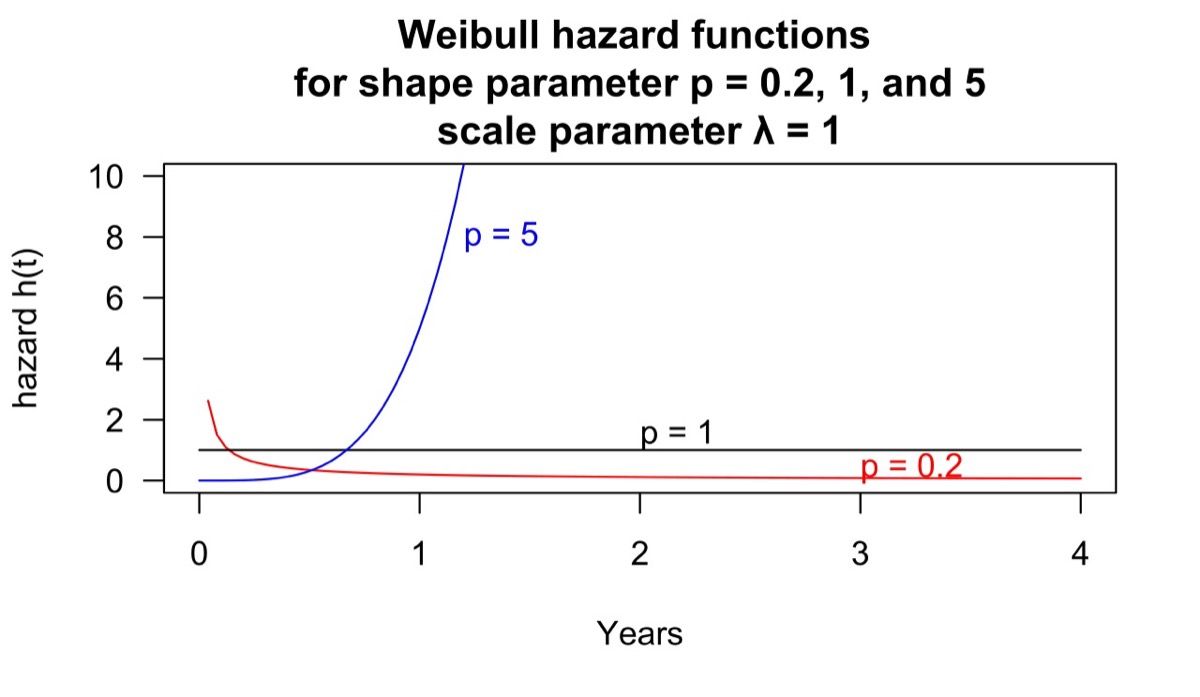
Gambar: Bentuk hazard function yang berbeda seiring waktu pada distribusi Weibull — Sumber: Wikimedia Commons, CC BY-SA 4.0
Kedua fungsi terhubung lewat S(t) = exp(-∫h(u)du). Integral hazard terhadap waktu disebut cumulative hazard H(t), dan nilai inilah yang diakumulasi sepanjang periode pengamatan. Perubahan kecil pada hazard langsung mengubah bentuk kurva survival, sehingga membaca salah satu fungsi selalu membantu memahami yang lain.
Sebelum estimasi, kita perlu mengenali tipe censoring. Right censoring paling umum karena pengamatan berhenti sebelum kejadian terjadi. Left censoring muncul ketika kejadian sudah berlangsung sebelum pengamatan dimulai. Interval censoring terjadi ketika kita hanya tahu kejadian berada di antara dua pemeriksaan. Semua pendekatan di artikel ini mengasumsikan non-informative censoring, yaitu waktu censored tidak bergantung pada risiko kejadian.
Dari asumsi itu lahir dua jalur estimasi. Pendekatan non-parametrik seperti Kaplan-Meier dan log-rank tidak menentukan bentuk distribusi waktu. Pendekatan semiparametrik seperti Cox proportional hazards memodelkan pengaruh kovariat tanpa menetapkan baseline hazard.
Mengestimasi Kurva Survival dengan Kaplan-Meier pada Dataset load_waltons
Kaplan-Meier menghitung probabilitas bertahan pada setiap titik waktu kejadian dengan mengalikan proporsi observasi yang masih bertahan. Estimator ini tidak merata-ratakan durasi, sehingga setiap observasi tetap menyumbang informasi sampai waktu censoring.
Kita mulai dengan menginstal lifelines di sel pertama notebook, lalu memuat dataset bawaan load_waltons. Dataset ini berisi 163 observasi dengan kolom T, E, dan group. Hanya 7 observasi yang censored, jadi hampir semua durasi teramati penuh.
!pip install lifelines

import pandas as pd
import matplotlib.pyplot as plt
from lifelines import KaplanMeierFitter
from lifelines.datasets import load_waltons

df = load_waltons()

kmf = KaplanMeierFitter()
kmf.fit(df["T"], df["E"])

print(f"Jumlah observasi: {len(df)}")
print(f"Observasi censored: {int((df['E'] == 0).sum())}")
print(f"Median survival time: {kmf.median_survival_time_} hari")

fig, ax = plt.subplots(figsize=(8, 5))
kmf.plot_survival_function(ci_show=True, ax=ax)
ax.set_title("Kurva Survival Kaplan-Meier Dataset Waltons")
ax.set_xlabel("Waktu (hari)")
ax.set_ylabel("Probabilitas bertahan")
plt.show()
Output:
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Jumlah observasi: 163
Observasi censored: 7
Median survival time: 56.0 hari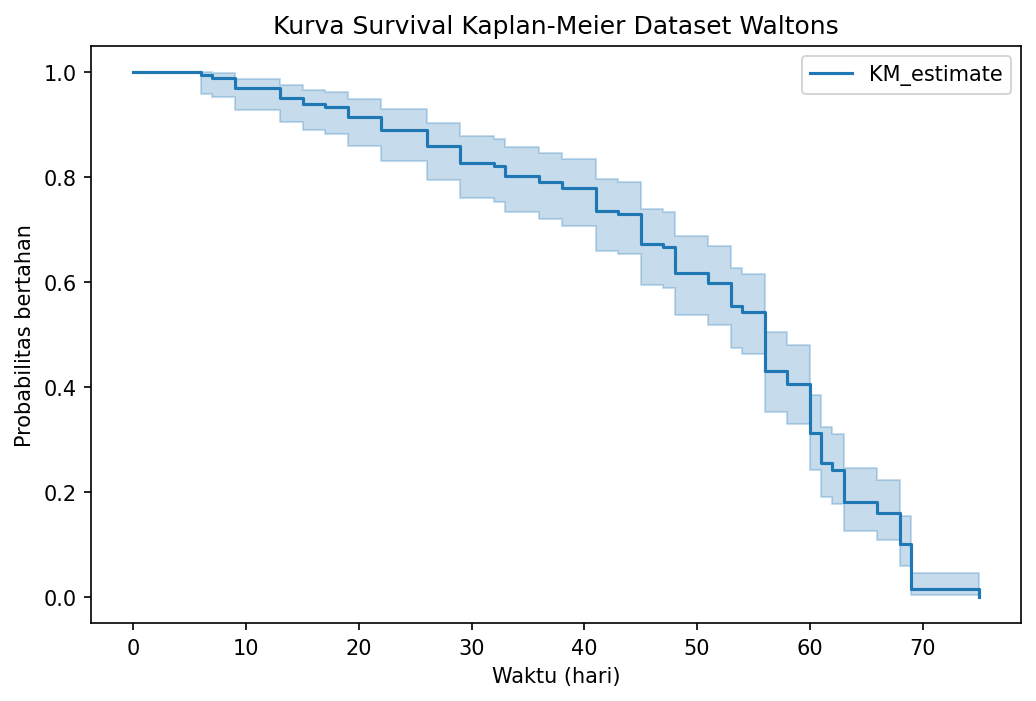
Kode di atas memuat data, melatih KaplanMeierFitter dengan durasi dan indikator event, lalu mencetak tiga angka penting. Output yang diharapkan adalah 163 observasi, 7 observasi censored, dan median survival time 56 hari. Kita memakai median, bukan rata-rata, karena distribusi durasi biasanya miring ke kanan dan sebagian observasi censored tidak punya durasi akhir yang pasti. Plot menampilkan kurva bertingkat dengan confidence interval: sumbu x adalah waktu, sumbu y probabilitas survival, dan setiap penurunan vertikal menandakan ada event pada waktu tersebut. Atribut survival_function_ menyimpan nilai S(t) di setiap titik, sementara median_survival_time_ adalah waktu ketika kurva melewati 0.5.
Menguji Perbedaan Antar Kelompok dengan Log-Rank Test
Kurva Kaplan-Meier memberi gambaran visual, tetapi kita tetap butuh uji formal. Log-rank test membandingkan jumlah event yang teramati dengan jumlah event yang diharapkan pada setiap titik waktu jika survival kedua kelompok identik. Hipotesis nol menyatakan tidak ada perbedaan survival, sedangkan hipotesis alternatif menyatakan minimal satu kelompok berbeda.
from lifelines.statistics import logrank_test

group_mir = df[df["group"] == "miR-137"]
group_control = df[df["group"] == "control"]

result = logrank_test(
    group_mir["T"],
    group_control["T"],
    event_observed_A=group_mir["E"],
    event_observed_B=group_control["E"],
)

print(f"Test statistic: {result.test_statistic:.2f}")
print(f"p-value: {result.p_value:.2e}")

fig, ax = plt.subplots(figsize=(8, 5))

kmf_mir = KaplanMeierFitter()
kmf_mir.fit(group_mir["T"], group_mir["E"], label="miR-137")
kmf_mir.plot_survival_function(ax=ax, ci_show=False)

kmf_control = KaplanMeierFitter()
kmf_control.fit(group_control["T"], group_control["E"], label="control")
kmf_control.plot_survival_function(ax=ax, ci_show=False)

ax.set_title("Perbandingan Kurva Survival antar Group")
ax.set_xlabel("Waktu (hari)")
ax.set_ylabel("Probabilitas bertahan")
plt.show()
Output:
Test statistic: 122.25
p-value: 2.04e-28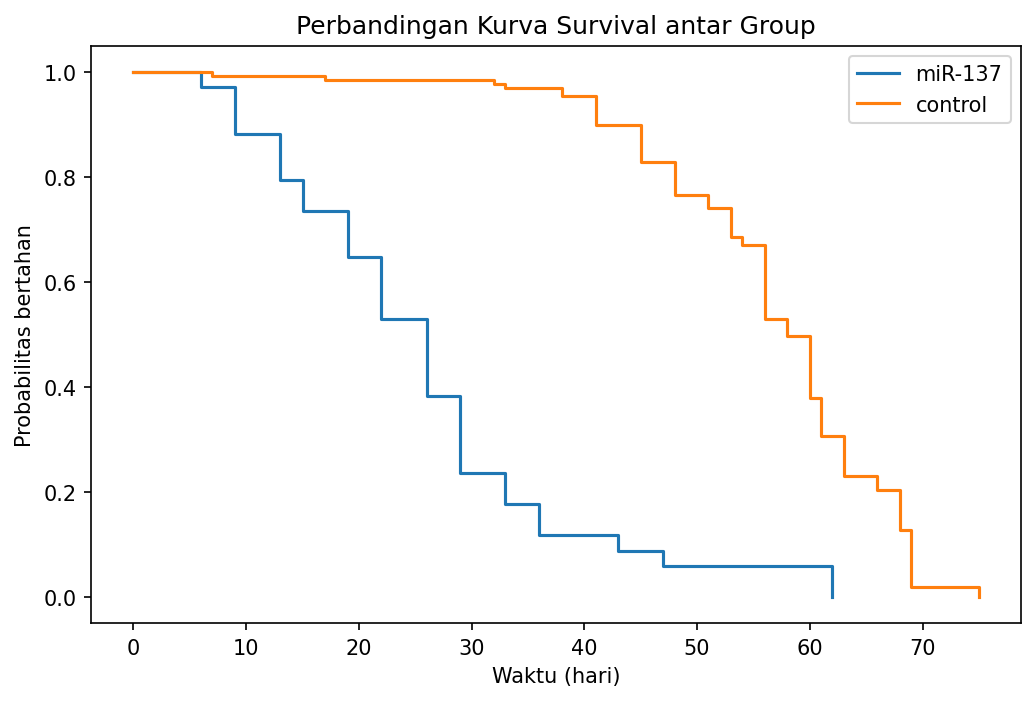
Output yang diharapkan adalah test statistic sekitar 122.25 dan p-value sekitar 2.04e-28. Statistik sebesar itu muncul ketika jumlah event teramati di satu kelompok jauh melampaui ekspektasi di bawah hipotesis nol. Nilai p yang jauh di bawah alpha = 0.05 membuat kita menolak hipotesis nol: kurva survival kedua group memang berbeda. Plot menegaskan hal itu, dengan kurva miR-137 turun lebih cepat dan median 26 hari, sementara control bertahan sampai median 58 hari.
Uji ini punya dua batasan yang perlu diingat. Log-rank tidak mengukur besar efek, jadi kita tidak bisa menyimpulkan seberapa kuat perbedaannya. Uji ini juga tidak mengontrol kovariat lain. Saat membandingkan lebih dari dua kelompok, jalankan koreksi multiple comparison agar p-value tidak membengkak.
Memodelkan Kovariat dengan Cox Proportional Hazards dan Membaca Hazard Ratio
Kaplan-Meier dan log-rank hanya menangani satu faktor kategorik. Ketika kita ingin mengukur pengaruh beberapa kovariat sekaligus, model Cox menjadi pilihan standar. Model ini menuliskan hazard sebagai h(t|X) = h0(t) * exp(β1X1 + ... + βpXp), dengan baseline hazard h0(t) dibiarkan tidak dispesifikasikan. Karena itu model ini disebut semiparametrik.
CoxPHFitter membutuhkan kovariat numerik, sehingga kolom group perlu dikonversi lebih dulu.
from lifelines import CoxPHFitter

cox_df = pd.get_dummies(df, columns=["group"], drop_first=True)

cph = CoxPHFitter()
cph.fit(cox_df, duration_col="T", event_col="E")

summary = cph.summary[["coef", "exp(coef)", "p"]]
print(summary)
print(f"Concordance index: {cph.concordance_index_:.3f}")
Output:
                   coef  exp(coef)             p
covariate
group_miR-137  2.052535   7.787619  3.084709e-21
Concordance index: 0.656
pd.get_dummies mengubah group menjadi kolom biner, dan drop_first=True menghindari kolom yang redundan. Tabel output berisi coef 2.05, exp(coef) 7.79, dan p-value 3.08e-21. Hazard ratio 7.79 berarti group miR-137 memiliki risiko event hampir delapan kali lebih tinggi dibanding baseline control pada setiap titik waktu. Interval kepercayaan 95% untuk hazard ratio berada di kisaran 5.09 sampai 11.91, dan seluruh rentangnya berada di atas 1.
concordance_index_ sebesar 0.656 mengukur daya diskriminasi model: sekitar 66% pasangan observasi diurutkan dengan benar berdasarkan risiko. Angka ini bukan ukuran kalibrasi, jadi model dengan concordance tinggi tetap bisa menghasilkan prediksi probabilitas yang meleset. Koefisien Cox juga bersifat relatif terhadap baseline, bukan prediksi durasi absolut.
Memeriksa Asumsi Proportional Hazards dan Menghindari Kesalahan Umum
Asumsi inti model Cox adalah hazard ratio antar individu konstan sepanjang waktu. Jika asumsi ini dilanggar, satu koefisien tidak lagi cukup menjelaskan efek kovariat karena pengaruhnya berubah seiring waktu. Pemeriksaannya menggunakan korelasi residual Schoenfeld terhadap waktu.
from lifelines.statistics import proportional_hazard_test

cph.check_assumptions(cox_df, p_value_threshold=0.05, show_plots=False)

ph_test = proportional_hazard_test(cph, cox_df, time_transform="rank")
print(ph_test.summary)
Output:
<lifelines.StatisticalResult: proportional_hazard_test>
 null_distribution = chi squared
degrees_of_freedom = 1
             model = <lifelines.CoxPHFitter: fitted with 163 total observations, 7 right-censored observations>
         test_name = proportional_hazard_test

---
                    test_statistic      p  -log2(p)
group_miR-137 km             14.03 <0.005     12.44
              rank           13.26 <0.005     11.85

1. Variable 'group_miR-137' failed the non-proportional test: p-value is 0.0002.

               test_statistic         p   -log2(p)
group_miR-137       13.257743  0.000271  11.846992
check_assumptions menjalankan uji proportional hazard untuk setiap kovariat dan mencetak ringkasan lengkap. Uji ini membandingkan residual Schoenfeld dengan waktu; korelasi yang signifikan berarti efek kovariat berubah seiring waktu. Pada dataset ini, group_miR-137 gagal dalam uji tersebut dengan p-value sekitar 0.0003, jauh di bawah ambang 0.05. Artinya pengaruh group terhadap hazard tidak konstan, sehingga hazard ratio tunggal sebesar 7.79 hanya berlaku sebagai rata-rata sepanjang periode pengamatan.
Ada beberapa solusi praktis. Kita bisa memakai stratifikasi lewat argumen strata=["group"] agar baseline hazard berbeda per kelompok. Alternatif lain adalah memodelkan efek bergantung waktu atau memisahkan analisis per periode. Untuk pelaporan, selalu sertakan interval kepercayaan, periksa korelasi antar kovariat, pastikan asumsi non-informative censoring, dan gunakan sampel yang memadai.
Kesalahan umum yang sering muncul adalah membaca hazard ratio sebagai risiko absolut. Hazard ratio bersifat relatif, jadi nilai 7.79 bukan berarti 779% pelanggan akan churn. Kesalahan lain adalah mengabaikan censoring saat menyiapkan data dan melaporkan p-value tanpa menyertakan effect size. Keduanya membuat kesimpulan terlihat meyakinkan padahal tidak informatif.
Melanjutkan Latihan dengan Data Time-to-Event Kita Sendiri
Analisis survival memberi kerangka berpikir yang lebih jujur untuk data durasi, karena censoring diperlakukan sebagai informasi, bukan gangguan. Untuk memperdalam statistika inferensial, pemodelan time-to-event, dan praktik Python secara terstruktur, program Data Science di Rumah Coding menyediakan jalur belajar dengan studi kasus nyata. Kita bisa mulai dari satu dataset durasi di sekitar kita, lalu membangun kurva survival dan model Cox pertama bersama-sama.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Related Articles
Memahami Konsep Multi-Armed Bandit dan Implementasinya dengan Thompson Sampling untuk Eksperimen A/B Testing
Memahami Type Hinting di Python: Static Analysis dengan mypy dan Validasi Runtime dengan Pydantic