Memahami Konsep Calibration Curve: Teori Kalibrasi Probabilitas Model dengan Implementasi Scikit-learn
Mengapa Akurasi Tinggi Tidak Menjamin Probabilitas yang Dapat Dipercaya
Akurasi dan kalibrasi mengukur dua hal berbeda. Akurasi menilai apakah ranking prediksi benar: kelas dengan probabilitas tertinggi menjadi jawaban model. Kalibrasi menilai apakah angka probabilitasnya jujur: dari semua prediksi bernilai 0.9, tepat sekitar 90% harus benar-benar positif. Model bisa memiliki akurasi lumayan tetapi probabilitas yang menyesatkan.
Dampaknya nyata dalam pengambilan keputusan. Skor kredit 0.9 yang sebenarnya hanya akurat 79% akan menyebabkan bank menyetujui terlalu banyak debitur berisiko. Prediksi risiko penyakit 0.9 dengan kebenaran 79% akan memicu tindakan medis berlebihan. Keputusan berbasis threshold membutuhkan probabilitas yang dapat dipercaya, bukan sekadar ranking yang benar.
Kaitan dengan materi sebelumnya juga langsung. Pada post Gaussian Mixture Model, kita memakai predict_proba untuk mengukur kepercayaan tiap cluster. Angka kepercayaan tersebut hanya berguna jika modelnya terkalibrasi. Probabilitas 0.7 yang sebenarnya berarti 0.5 akan merusak seluruh logika threshold yang kita bangun.
Mari kita buktikan dengan eksperimen. Kita latih GaussianNB dan SVC pada dataset yang fitur-fiturnya diduplikasi — kondisi yang melanggar asumsi independensi Naive Bayes. Lalu kita periksa klaim keyakinan masing-masing model.
!pip install numpy scikit-learn

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.svm import SVC
from sklearn.metrics import brier_score_loss, accuracy_score

X, y = make_classification(n_samples=1000, n_features=6, n_informative=4,
                           n_redundant=0, weights=[0.7], flip_y=0.05,
                           random_state=42)
X = np.hstack([X, X, X])
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42)

nb = GaussianNB().fit(X_train, y_train)
svc = SVC(probability=True, random_state=42).fit(X_train, y_train)

for name, model in [("GaussianNB", nb), ("SVC", svc)]:
    proba = model.predict_proba(X_test)[:, 1]
    pred = model.predict(X_test)
    confident = np.maximum(proba, 1 - proba) > 0.9
    print(f"{name}:")
    print(f"  Akurasi = {accuracy_score(y_test, pred):.3f}")
    print(f"  Brier Score = {brier_score_loss(y_test, proba):.4f}")
    print(f"  Prediksi sangat yakin (>0.9): {confident.sum()} dari {len(y_test)}")
    print(f"  Akurasi pada prediksi yakin = {(pred[confident] == y_test[confident]).mean():.3f}")
Output:
GaussianNB:
  Akurasi = 0.730
  Brier Score = 0.2196
  Prediksi sangat yakin (>0.9): 215 dari 300
  Akurasi pada prediksi yakin = 0.791
SVC:
  Akurasi = 0.890
  Brier Score = 0.0866
  Prediksi sangat yakin (>0.9): 194 dari 300
  Akurasi pada prediksi yakin = 0.938
Hasilnya menunjukkan masalah kalibrasi secara gamblang. GaussianNB mengklaim sangat yakin pada 215 prediksi, tetapi hanya 79.1% yang benar — klaim di atas 0.9 tidak terbayar. Penyebabnya adalah duplikasi fitur: Naive Bayes menghitung bukti yang sama tiga kali sehingga probabilitasnya terdorong ke ekstrem. Sebaliknya SVC mengklaim yakin pada 194 prediksi dengan kebenaran 93.8%, jauh lebih jujur. Perbedaan kualitas ini terangkum dalam Brier Score: 0.2196 melawan 0.0866.
Cara Membaca Calibration Curve dan Brier Score
Angka rata-rata tidak cukup untuk mendiagnosis kalibrasi. Kita butuh melihat perilaku model di setiap level keyakinan. Di sinilah _calibration curve_ bekerja: sumbu horizontal menunjukkan rata-rata probabilitas prediksi dalam tiap bin, sumbu vertikal menunjukkan fraksi positif aktual dalam bin yang sama. Model yang terkalibrasi sempurna akan menempel pada garis diagonal.
Cara membacanya sederhana. Kurva yang berada di bawah diagonal berarti model overconfident: klaim probabilitas lebih tinggi dari kenyataan. Kurva di atas diagonal berarti model underconfident: klaim lebih rendah dari kenyataan. Penyimpangan di ujung kanan kurva paling berbahaya karena di sanalah keputusan penting diambil berdasarkan keyakinan tinggi.
_Brier Score_ merangkum kualitas probabilitas dalam satu angka: rata-rata kuadrat selisih antara probabilitas prediksi dan label aktual (0 atau 1). Semakin kecil nilainya, semakin baik. Metrik ini menghukum dua kesalahan sekaligus: ranking yang salah dan keyakinan yang berlebihan. Inilah alasan Brier Score menjadi metrik utama evaluasi kalibrasi.
Kode berikut menggambar _calibration curve_ kedua model dengan CalibrationDisplay.from_estimator dari sklearn.calibration.
!pip install scikit-learn matplotlib

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.svm import SVC
from sklearn.calibration import CalibrationDisplay
from sklearn.metrics import brier_score_loss

X, y = make_classification(n_samples=1000, n_features=6, n_informative=4,
                           n_redundant=0, weights=[0.7], flip_y=0.05,
                           random_state=42)
X = np.hstack([X, X, X])
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42)

nb = GaussianNB().fit(X_train, y_train)
svc = SVC(probability=True, random_state=42).fit(X_train, y_train)

fig, ax = plt.subplots(figsize=(7, 5))
CalibrationDisplay.from_estimator(nb, X_test, y_test, n_bins=10, name="GaussianNB", ax=ax)
CalibrationDisplay.from_estimator(svc, X_test, y_test, n_bins=10, name="SVC", ax=ax)
plt.show()

print(f"Brier Score GaussianNB = {brier_score_loss(y_test, nb.predict_proba(X_test)[:, 1]):.4f}")
print(f"Brier Score SVC = {brier_score_loss(y_test, svc.predict_proba(X_test)[:, 1]):.4f}")
Output:
Brier Score GaussianNB = 0.2196
Brier Score SVC = 0.0866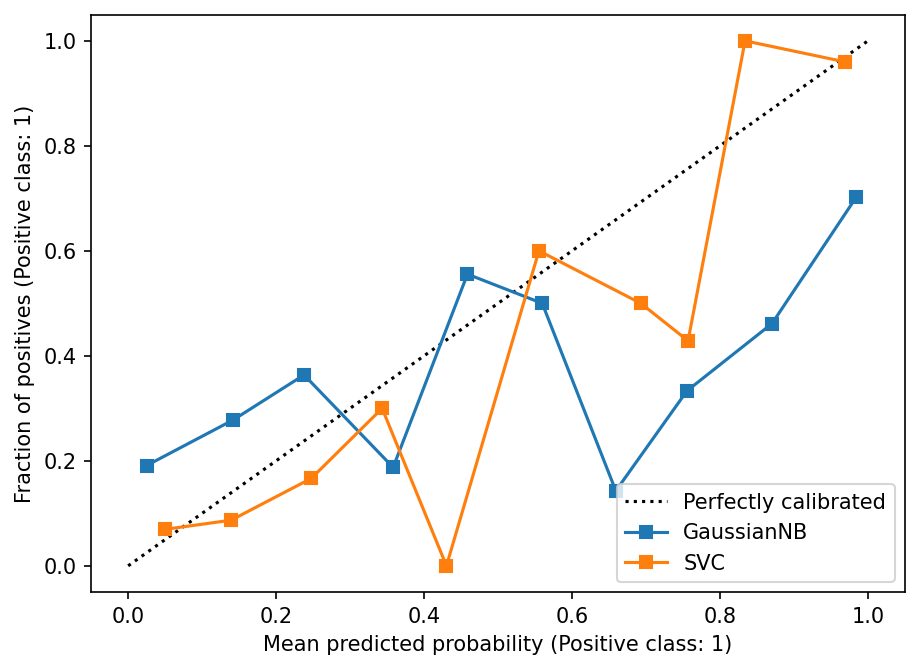
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Plot di atas memvisualkan diagnosis kita. Kurva GaussianNB menyimpang jauh dari diagonal di wilayah probabilitas tinggi — model mengklaim 0.9 padahal fraksi aktualnya jauh lebih rendah. Kurva SVC menempel rapat pada diagonal di hampir seluruh rentang. Brier Score mengonfirmasi kesan visual: 0.2196 untuk model yang buruk kalibrasinya melawan 0.0866 untuk model yang jujur. Workflow diagnosis ini — plot kurva lalu konfirmasi dengan Brier Score — berlaku untuk model klasifikasi apa pun.
Metode Kalibrasi Platt Scaling dan Isotonic Regression
Setelah terdiagnosis, model yang miscalibrated bisa diperbaiki tanpa melatih ulang base model. Idenya adalah mempelajari fungsi pemetaan dari skor mentah model ke probabilitas yang terkalibrasi menggunakan data validasi terpisah. Scikit-learn menyediakan dua metode lewat CalibratedClassifierCV.
Metode pertama adalah _Platt Scaling_ (method="sigmoid"). Metode ini memasang kurva sigmoid (regresi logistik) yang memetakan skor mentah ke rentang probabilitas. Asumsinya adalah hubungan antara skor dan probabilitas sejati berbentuk S. Keunggulannya adalah efisiensi data: karena hanya dua parameter yang dipelajari, metode ini bekerja baik bahkan dengan data kalibrasi sedikit. Kelemahannya adalah kekakuan — jika bentuk miscalibration tidak menyerupai sigmoid, koreksinya tidak optimal.
Metode kedua adalah _Isotonic Regression_ (method="isotonic"). Metode non-parametrik ini mempelajari fungsi tangga monotonik yang fleksibel mengikuti pola data. Metode ini mampu mengoreksi bentuk miscalibration apa pun selama hubungannya monotonik. Harganya adalah kebutuhan data: dengan data kalibrasi sedikit, fungsi tangga akan overfit pada noise. Aturan praktisnya adalah gunakan sigmoid untuk data kalibrasi kecil (ratusan sampel) dan isotonic untuk data besar (seribu sampel atau lebih).
Parameter cv pada CalibratedClassifierCV mengatur strategi cross-validation internal agar data kalibrasi tidak bocor ke training base model. Dengan cv=5, data training dibagi lima lipatan dan setiap lipatan dikalibrasi oleh model yang dilatih pada empat lipatan lainnya. Mekanisme ini mencegah estimasi kalibrasi yang terlalu optimistis.
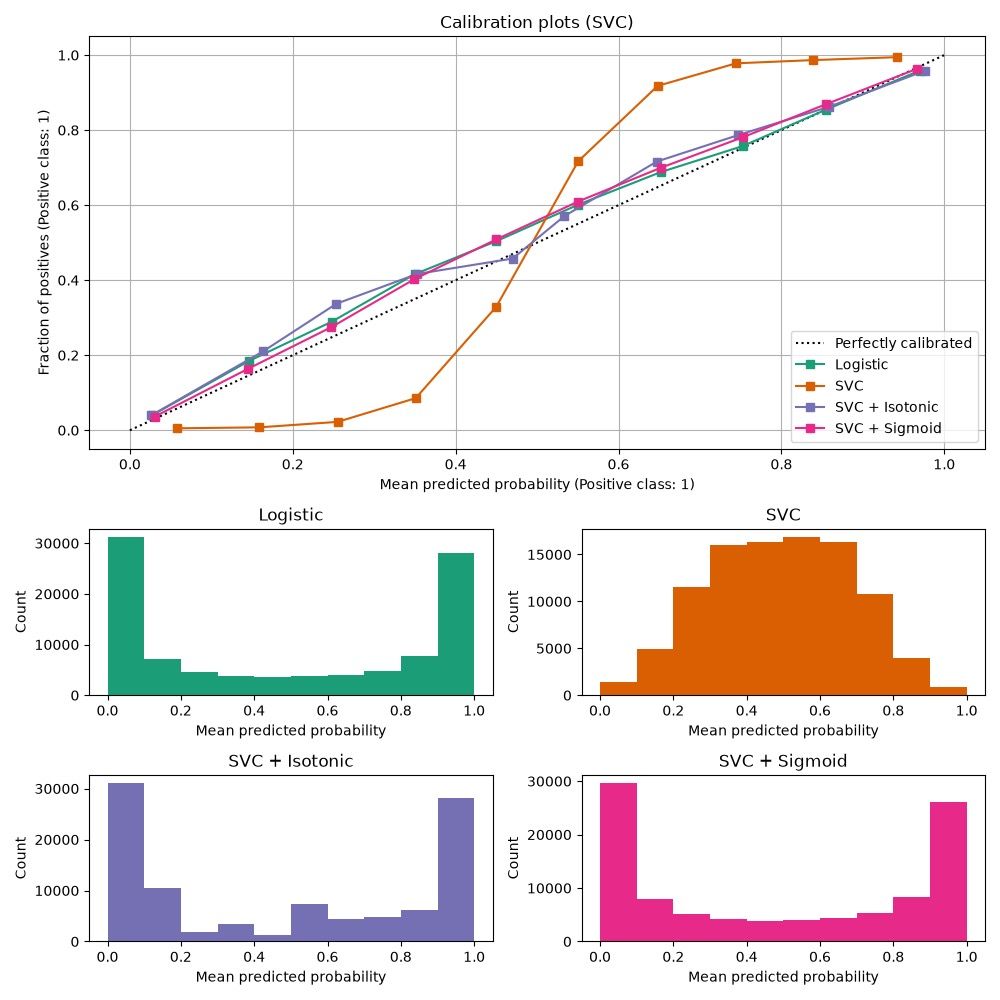
Gambar: Contoh referensi kalibrasi pada SVC — panel atas menunjukkan kurva sebelum dan sesudah koreksi, panel bawah menunjukkan redistribusi massa probabilitas hasil kalibrasi. — Sumber: scikit-learn
Implementasi Kalibrasi dengan CalibratedClassifierCV dan Evaluasi Perbaikan
Sekarang kita terapkan kedua metode pada GaussianNB yang bermasalah. Kita bungkus base model dengan CalibratedClassifierCV, latih pada data yang sama, lalu bandingkan Brier Score sebelum dan sesudah kalibrasi. Kita juga plot ketiga kurva dalam satu gambar untuk melihat perbaikan secara visual.
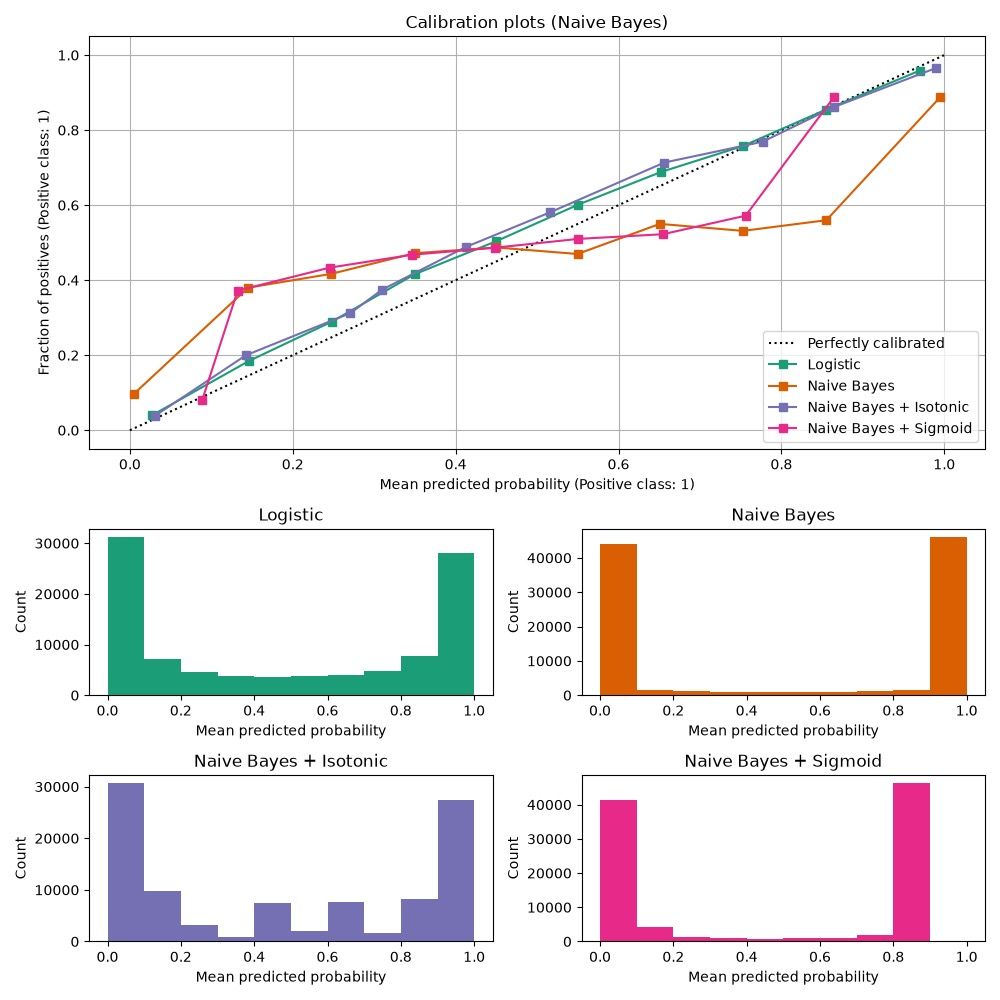
Gambar: Contoh referensi kalibrasi pada Naive Bayes — kurva oranye yang menyimpang terkoreksi mendekati diagonal oleh kedua metode. — Sumber: scikit-learn
!pip install scikit-learn matplotlib

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB
from sklearn.calibration import CalibratedClassifierCV, CalibrationDisplay
from sklearn.metrics import brier_score_loss

X, y = make_classification(n_samples=1000, n_features=6, n_informative=4,
                           n_redundant=0, weights=[0.7], flip_y=0.05,
                           random_state=42)
X = np.hstack([X, X, X])
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42)

base = GaussianNB()
sig = CalibratedClassifierCV(GaussianNB(), method="sigmoid", cv=5)
iso = CalibratedClassifierCV(GaussianNB(), method="isotonic", cv=5)
base.fit(X_train, y_train)
sig.fit(X_train, y_train)
iso.fit(X_train, y_train)

fig, ax = plt.subplots(figsize=(7, 5))
for model, name in [(base, "Uncalibrated"), (sig, "Sigmoid"), (iso, "Isotonic")]:
    CalibrationDisplay.from_estimator(model, X_test, y_test, n_bins=10, name=name, ax=ax)
plt.show()

for name, model in [("Uncalibrated", base), ("Sigmoid", sig), ("Isotonic", iso)]:
    proba = model.predict_proba(X_test)[:, 1]
    print(f"Brier Score {name} = {brier_score_loss(y_test, proba):.4f}")
Output:
Brier Score Uncalibrated = 0.2196
Brier Score Sigmoid = 0.1820
Brier Score Isotonic = 0.1793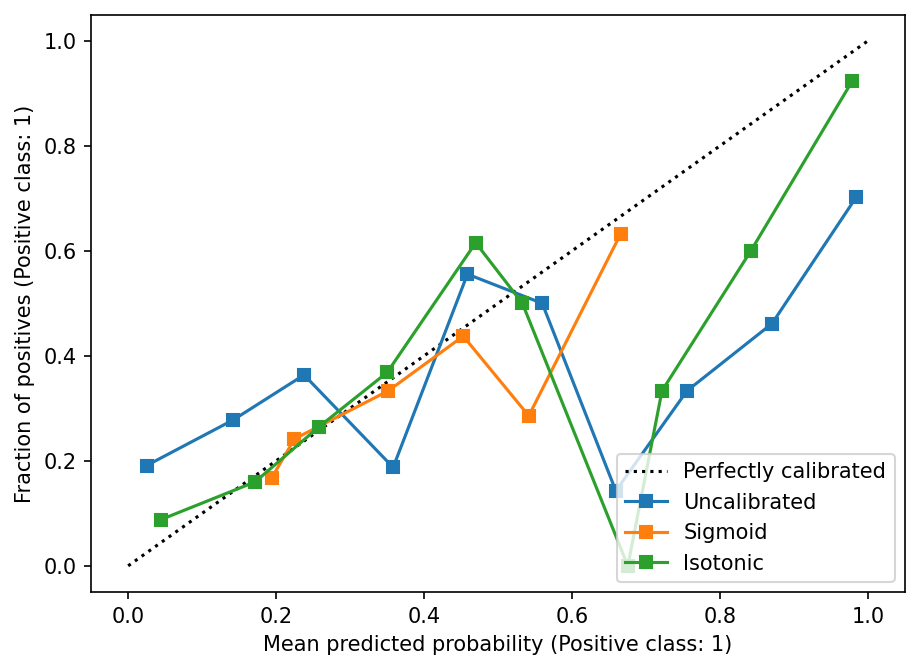
Perbaikan terjadi pada kedua metode. Brier Score turun dari 0.2196 menjadi 0.1820 dengan Platt Scaling dan 0.1793 dengan Isotonic Regression. Pada plot, kedua kurva terkoreksi mendekati diagonal terutama di wilayah probabilitas tinggi yang sebelumnya paling menyimpang. Isotonic sedikit lebih baik di sini karena data kalibrasi mencukupi (700 sampel training dengan 5-fold). Perlu dicatat bahwa kalibrasi tidak mengubah ranking prediksi secara material — akurasi model tetap sekitar 0.73. Yang diperbaiki murni kejujuran angka probabilitasnya.
Best Practices Kalibrasi dalam Pipeline Produksi
Kalibrasi bukan pekerjaan sekali jalan. Empat praktik berikut menjaga probabilitas model tetap dapat dipercaya di production.
Pertama, selalu pisahkan data kalibrasi dari data training base model. Mengkalibrasi pada data yang sama dengan training menghasilkan koreksi yang terlalu optimistis. Gunakan parameter cv pada CalibratedClassifierCV atau sediakan _calibration set_ khusus hasil split.
Kedua, kalibrasi ulang secara berkala. Distribusi data produksi bergeser seiring waktu (_concept drift_) sehingga pemetaan kalibrasi kedaluwarsa. Jadwalkan evaluasi Brier Score tiap periode dan trigger kalibrasi ulang ketika skor melewati threshold.
Ketiga, kenali karakter model yang dipakai. Model berbasis tree seperti Random Forest dan Gradient Boosting umumnya membutuhkan kalibrasi karena voting antar tree mendistorsi probabilitas. LogisticRegression biasanya sudah cukup terkalibrasi karena fungsi logitnya memang memodelkan probabilitas. Naive Bayes hampir selalu butuh kalibrasi ketika asumsi independensinya dilanggar.
Keempat, monitor Brier Score lintas fold bukan hanya pada satu split. Kode berikut memvalidasi kestabilan kalibrasi dengan 5-fold dan mencetak skor per fold agar kita tahu variansinya.
!pip install scikit-learn

import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import StratifiedKFold, cross_val_predict
from sklearn.naive_bayes import GaussianNB
from sklearn.calibration import CalibratedClassifierCV
from sklearn.metrics import brier_score_loss

X, y = make_classification(n_samples=1000, n_features=6, n_informative=4,
                           n_redundant=0, weights=[0.7], flip_y=0.05,
                           random_state=42)
X = np.hstack([X, X, X])
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

raw = cross_val_predict(GaussianNB(), X, y, cv=cv, method="predict_proba")[:, 1]
cal = cross_val_predict(CalibratedClassifierCV(GaussianNB(), method="sigmoid", cv=3),
                        X, y, cv=cv, method="predict_proba")[:, 1]

print(f"Brier Score NB tanpa kalibrasi (5-fold) = {brier_score_loss(y, raw):.4f}")
print(f"Brier Score NB terkalibrasi (5-fold) = {brier_score_loss(y, cal):.4f}")

fold_scores = []
for train_idx, test_idx in cv.split(X, y):
    m = CalibratedClassifierCV(GaussianNB(), method="sigmoid", cv=3)
    m.fit(X[train_idx], y[train_idx])
    fold_scores.append(brier_score_loss(y[test_idx], m.predict_proba(X[test_idx])[:, 1]))
print("Brier Score terkalibrasi per fold:", [f"{s:.4f}" for s in fold_scores])
Output:
Brier Score NB tanpa kalibrasi (5-fold) = 0.2149
Brier Score NB terkalibrasi (5-fold) = 0.1809
Brier Score terkalibrasi per fold: ['0.1605', '0.1814', '0.1770', '0.1884', '0.1972']
Validasi 5-fold mengonfirmasi perbaikan bukan kebetulan satu split. Skor terkalibrasi 0.1809 mengungguli skor mentah 0.2149 secara konsisten, dengan rentang per fold 0.1605 sampai 0.1972. Variansi antar fold yang sempit menandakan prosedur kalibrasi stabil. Pola monitoring seperti inilah yang perlu kita otomatiskan dalam pipeline production: hitung Brier Score tiap batch data baru dan waspadai tren kenaikan.
Ikuti bootcamp Machine Learning di Rumah Coding untuk memperdalam evaluasi dan deployment model — dari validasi offline sampai monitoring production yang andal.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Machine Learning Bootcamp
A beginner-friendly, 7-week project-based bootcamp designed to take you from Python basics to deploying your first Machine Learning model. Through hands-on practice, you will master essential data manipulation, build predictive algorithms, and develop an end-to-end, industry-ready application to kickstart your career in data science.
End-to-End Student Success Predictor
- Automated Data Pipeline: A preprocessing script that automatically cleans missing values, encodes categorical data (like course type or student background), and scales numerical inputs.
- Predictive Engine: A tuned machine learning classification model (e.g., Random Forest) specifically optimized for high Recall, ensuring that "at-risk" students are not missed.
- Interactive Web Dashboard: A user-friendly Streamlit interface featuring a sidebar where instructors can manually input a student's study hours, quiz scores, and login frequency to get an instant pass/fail probability.