Memahami Metrik Evaluasi Klasifikasi: Teori Confusion Matrix, Precision, Recall, dan F1-Score dengan Python

Anatomi Confusion Matrix sebagai Fondasi Metrik Klasifikasi
Confusion matrix adalah tabel kontingensi yang membandingkan label actual dengan label predicted pada tugas klasifikasi. Untuk klasifikasi biner, tabel ini berisi empat sel inti yang menjadi sumber semua metrik turunan. True Positive (TP) adalah kasus positif yang diprediksi positif. True Negative (TN) adalah kasus negatif yang diprediksi negatif. False Positive (FP) muncul saat kasus negatif diprediksi positif, sementara False Negative (FN) muncul saat kasus positif diprediksi negatif.
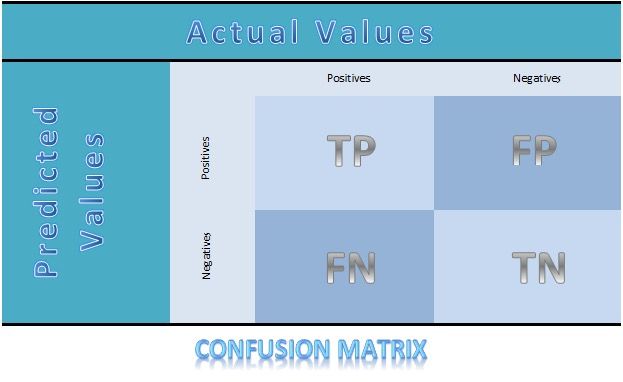
Gambar: Diagram 2x2 confusion matrix yang melabeli sel TP, FP, FN, dan TN — Sumber: Wikimedia Commons
scikit-learn memakai konvensi baris sebagai label aktual dan kolom sebagai label prediksi. Posisi [0, 0] menampung TN, [0, 1] menampung FP, [1, 0] menampung FN, dan [1, 1] menampung TP. Konvensi ini penting karena kekeliruan membaca orientasi sumbu langsung membalik interpretasi seluruh metrik.
Dua jenis error tidak setara, baik secara teknis maupun bisnis. Pada skrining medis, FN berarti pasien sakit dinyatakan sehat, sebuah kegagalan yang berisiko tinggi. Pada filter spam, FP berarti email penting masuk ke folder spam, gangguan yang merugikan pengguna. Kita tidak bisa memilih metrik evaluasi sebelum tahu jenis error mana yang paling mahal untuk ditanggung.
Contoh berikut melatih LogisticRegression pada dataset breast cancer bawaan scikit-learn, lalu mencetak confusion matrix dari test set.
!pip install scikit-learn numpy matplotlib

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import confusion_matrix

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, random_state=42, stratify=data.target
)

model = LogisticRegression(max_iter=5000)
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
cm = confusion_matrix(y_test, y_pred)

tn, fp, fn, tp = cm.ravel()
print(cm)
print(f"TP={tp} FN={fn} FP={fp} TN={tn}")
Output:
[[48  5]
 [ 1 89]]
TP=89 FN=1 FP=5 TN=48
Fungsi confusion_matrix mengembalikan array 2x2. Nilai tp dan tn berada di diagonal utama, sedangkan fp dan fn berada di luar diagonal. Sebelum menyentuh metrik turunan, kita sebaiknya membaca matrix ini lebih dulu untuk melihat di mana model paling sering salah.
Cara Kerja Precision, Recall, dan F1-Score serta Kapan Memakainya
Precision mengukur ketepatan prediksi positif, yaitu rasio TP terhadap total prediksi positif:
Precision = TP / (TP + FP)
Nilai precision tinggi berarti ketika model menyatakan sebuah sampel positif, klaim itu besar kemungkinan benar. Recall atau sensitivity mengukur cakupan penemuan kasus positif:
Recall = TP / (TP + FN)
Recall tinggi berarti model berhasil menangkap sebagian besar kasus positif yang benar-benar ada. Menggeser decision threshold model mengubah kedua nilai ini secara berlawanan; menaikkan ambang membuat prediksi positif lebih selektif sehingga precision naik, tetapi recall turun karena lebih banyak kasus positif terlewat.
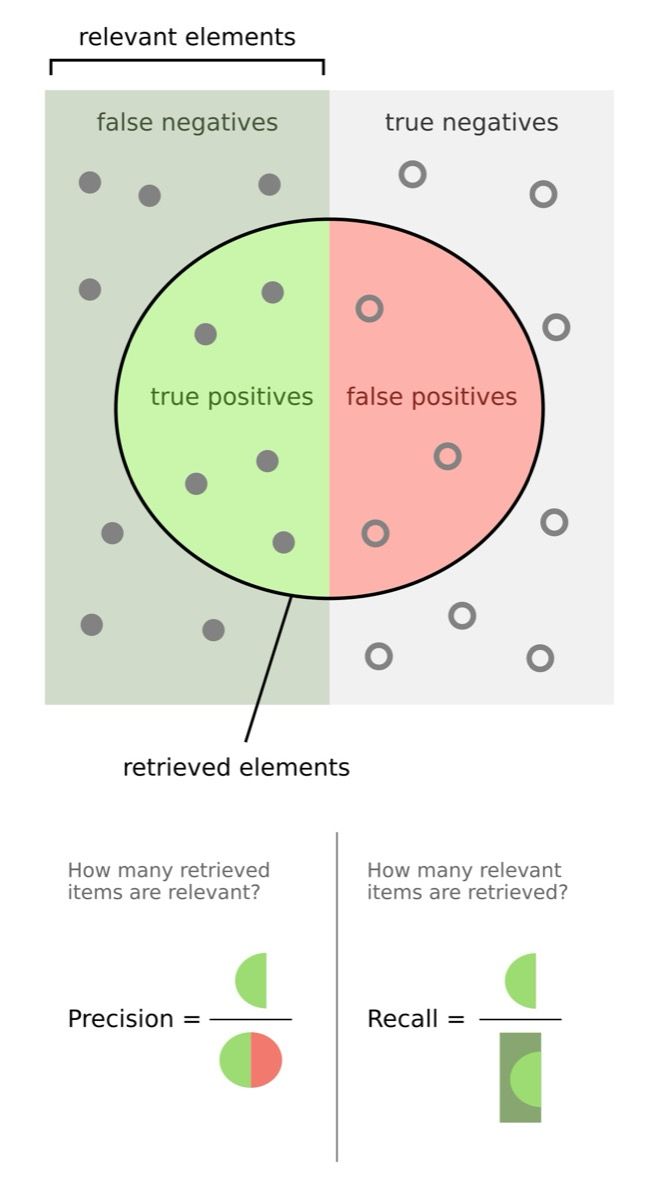
Gambar: Diagram konseptual hubungan antara precision dan recall yang saling berlawanan — Sumber: Wikimedia Commons
F1-Score menggabungkan keduanya memakai harmonic mean:
F1 = 2 * (Precision * Recall) / (Precision + Recall)
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Harmonic mean dipilih karena menghukum nilai yang timpang. Jika precision 0.9 dan recall 0.1, rata-rata aritmetika memberi 0.5, sedangkan harmonic mean hanya memberi 0.18. Angka ini lebih jujur karena model yang mengabaikan satu sisi tidak layak disebut baik. Saat salah satu sisi perlu diberi bobot lebih besar, kita memakai F-beta score, dengan beta > 1 menekankan recall dan beta < 1 menekankan precision.
Studi kasus memperjelas pilihan metrik. Deteksi kanker memprioritaskan recall karena melewatkan pasien sakit jauh lebih berbahaya daripada memunculkan alarm palsu. Filter spam memprioritaskan precision karena memblokir email penting lebih merugikan daripada membiarkan satu spam lolos.
Mengapa Accuracy Menyesatkan pada Data Tidak Seimbang
Dataset breast cancer tidak berimbang. Kelas benign berjumlah 357 sampel, sementara malignant hanya 212. Rasio ini belum ekstrem, tetapi cukup untuk memperlihatkan masalah accuracy. Model yang selalu menebak kelas mayoritas bisa mendapat accuracy yang tampak wajar tanpa mempelajari pola kelas minoritas.
Gejala ini disebut accuracy paradox. Kita membuktikannya dengan DummyClassifier berstrategi most_frequent, lalu membandingkannya dengan LogisticRegression. Precision dan recall dihitung khusus untuk kelas malignant.
!pip install scikit-learn numpy matplotlib

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score, precision_score, recall_score

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, random_state=42, stratify=data.target
)

majority = DummyClassifier(strategy="most_frequent")
majority.fit(X_train, y_train)
dummy_pred = majority.predict(X_test)

real = LogisticRegression(max_iter=5000)
real.fit(X_train, y_train)
real_pred = real.predict(X_test)

for name, pred in [("Dummy", dummy_pred), ("Logistic", real_pred)]:
    acc = accuracy_score(y_test, pred)
    prec = precision_score(y_test, pred, pos_label=0, zero_division=0)
    rec = recall_score(y_test, pred, pos_label=0, zero_division=0)
    print(f"{name:9s} acc={acc:.3f} prec_mal={prec:.3f} rec_mal={rec:.3f}")
Output:
Dummy     acc=0.629 prec_mal=0.000 rec_mal=0.000
Logistic  acc=0.958 prec_mal=0.980 rec_mal=0.906
Baseline dummy mendapat accuracy 0.629, sekilas tampak lumayan, tetapi precision dan recall nol pada kelas malignant: tidak ada satu pun kanker yang terdeteksi. Model logistic mencapai accuracy 0.958 dengan precision 0.980 dan recall 0.906. Akurasi menyembunyikan kegagalan total pada kelas yang paling penting, dan hanya valid saat kelas seimbang atau biaya kedua jenis error setara.
Membaca classification_report untuk Evaluasi Per Kelas
classification_report merangkum precision, recall, f1-score, dan support untuk setiap kelas dalam satu tabel. Kolom support berisi jumlah sampel aktual tiap kelas, sehingga kita tahu seberapa layak sebuah angka metrik dipercaya. Kelas dengan support kecil menghasilkan metrik yang lebih sensitif terhadap beberapa kesalahan saja.
Baris macro avg menghitung rata-rata sederhana seluruh kelas, sehingga tiap kelas mendapat bobot sama tanpa memandang jumlah sampelnya. Baris weighted avg membobot setiap kelas sesuai support, sehingga kelas mayoritas lebih dominan. Pada data tidak seimbang, macro avg lebih representatif untuk melihat performa kelas minoritas, sedangkan weighted avg menggambarkan performa keseluruhan.
!pip install scikit-learn numpy matplotlib

from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, random_state=42, stratify=data.target
)

model = LogisticRegression(max_iter=5000)
model.fit(X_train, y_train)
y_pred = model.predict(X_test)

print(classification_report(y_test, y_pred, target_names=data.target_names, digits=3))
Output:
              precision    recall  f1-score   support

   malignant      0.980     0.906     0.941        53
      benign      0.947     0.989     0.967        90

    accuracy                          0.958       143
   macro avg      0.963     0.947     0.954       143
weighted avg      0.959     0.958     0.958       143
Saat membaca laporan, kita mencari kelas dengan recall rendah terlebih dahulu, karena kelas itulah kandidat utama perbaikan. Setiap angka pada report dapat diturunkan kembali ke sel confusion matrix, sehingga kedua alat ini saling melengkapi alih-alih berdiri sendiri.
Menyetel Threshold dengan precision_recall_curve
predict memakai threshold default 0.5, sebuah keputusan yang jarang disesuaikan padahal konsekuensinya besar. Sebelum dipotong threshold, model sebenarnya menghasilkan skor kontinu lewat predict_proba. Kita bisa memakai skor itu untuk mengeksplorasi seluruh tradeoff precision dan recall.
Fungsi precision_recall_curve mengembalikan nilai precision dan recall pada semua nilai threshold sekaligus. Kita memilih threshold berdasarkan tujuan bisnis, misalnya recall minimum yang masih dapat diterima. Setelah threshold digeser, kita hitung ulang precision dan recall sebagai verifikasi.
!pip install scikit-learn numpy matplotlib

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import precision_recall_curve, precision_score, recall_score

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, random_state=42, stratify=data.target
)

model = LogisticRegression(max_iter=5000)
model.fit(X_train, y_train)
proba = model.predict_proba(X_test)[:, 1]

precision, recall, thresholds = precision_recall_curve(y_test, proba)

def scores(pred):
    return precision_score(y_test, pred), recall_score(y_test, pred)

base_pred = (proba >= 0.5).astype(int)
custom = 0.7
custom_pred = (proba >= custom).astype(int)

p0, r0 = scores(base_pred)
p1, r1 = scores(custom_pred)
print(f"threshold=0.50 precision={p0:.3f} recall={r0:.3f}")
print(f"threshold={custom:.2f} precision={p1:.3f} recall={r1:.3f}")

plt.figure(figsize=(7, 5))
plt.plot(recall, precision, label="PR curve")
plt.scatter([r0], [p0], color="black", label="threshold 0.50")
plt.scatter([r1], [p1], color="red", label=f"threshold {custom}")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.title("Precision-Recall Curve")
plt.legend()
plt.savefig("pr-curve.png", dpi=100, bbox_inches="tight")
print("pr-curve.png saved")
Output:
threshold=0.50 precision=0.947 recall=0.989
threshold=0.70 precision=0.956 recall=0.956
pr-curve.png saved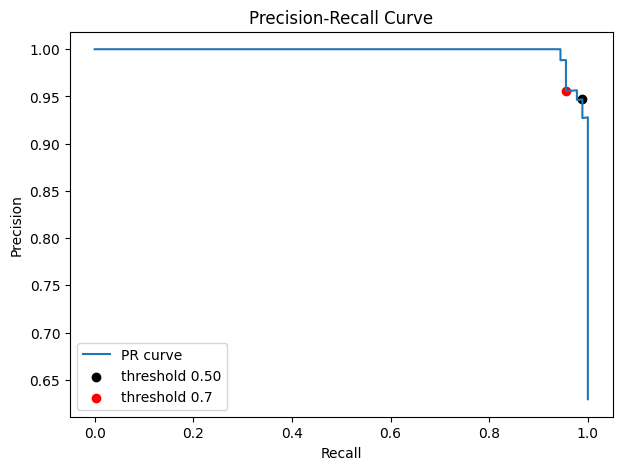
Menaikkan threshold ke 0.7 umumnya menaikkan precision dan menurunkan recall. Titik pada kurva menunjukkan kompromi yang tersedia, dan pilihan akhir tetap ditentukan oleh toleransi kita terhadap masing-masing jenis error.
ROC-AUC dan PR-AUC untuk Evaluasi Model Ranking
roc_auc_score mengukur luas area di bawah kurva TPR melawan FPR. Nilainya dapat dibaca sebagai probabilitas model memberi skor lebih tinggi pada sampel positif acak dibandingkan sampel negatif acak. Area 0.5 setara model acak, sedangkan area 1.0 berarti separasi sempurna. Kita memperoleh kurva dengan roc_curve.
ROC-AUC punya keterbatasan pada data sangat tidak seimbang. FPR dihitung dari kelas negatif yang jumlahnya besar, sehingga kurva tetap terlihat bagus meski kelas minoritas sering terlewat. Untuk kasus seperti ini, average_precision_score dan precision_recall_curve menghasilkan PR-AUC yang lebih sensitif terhadap kelas positif yang jarang.
!pip install scikit-learn numpy matplotlib

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import (
    roc_curve,
    roc_auc_score,
    precision_recall_curve,
    average_precision_score,
)

data = load_breast_cancer()
X_train, X_test, y_train, y_test = train_test_split(
    data.data, data.target, test_size=0.25, random_state=42, stratify=data.target
)

model = LogisticRegression(max_iter=5000)
model.fit(X_train, y_train)
proba = model.predict_proba(X_test)[:, 1]

roc_auc = roc_auc_score(y_test, proba)
pr_auc = average_precision_score(y_test, proba)
print(f"ROC-AUC={roc_auc:.3f}  PR-AUC={pr_auc:.3f}")

fpr, tpr, _ = roc_curve(y_test, proba)
precision, recall, _ = precision_recall_curve(y_test, proba)

fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].plot(fpr, tpr, label=f"AUC={roc_auc:.3f}")
axes[0].plot([0, 1], [0, 1], "--", color="gray")
axes[0].set_xlabel("False Positive Rate")
axes[0].set_ylabel("True Positive Rate")
axes[0].set_title("ROC Curve")
axes[0].legend()

axes[1].plot(recall, precision, label=f"AP={pr_auc:.3f}")
axes[1].set_xlabel("Recall")
axes[1].set_ylabel("Precision")
axes[1].set_title("Precision-Recall Curve")
axes[1].legend()

plt.tight_layout()
plt.savefig("roc-pr-curves.png", dpi=100, bbox_inches="tight")
print("roc-pr-curves.png saved")
Output:
ROC-AUC=0.996  PR-AUC=0.998
roc-pr-curves.png saved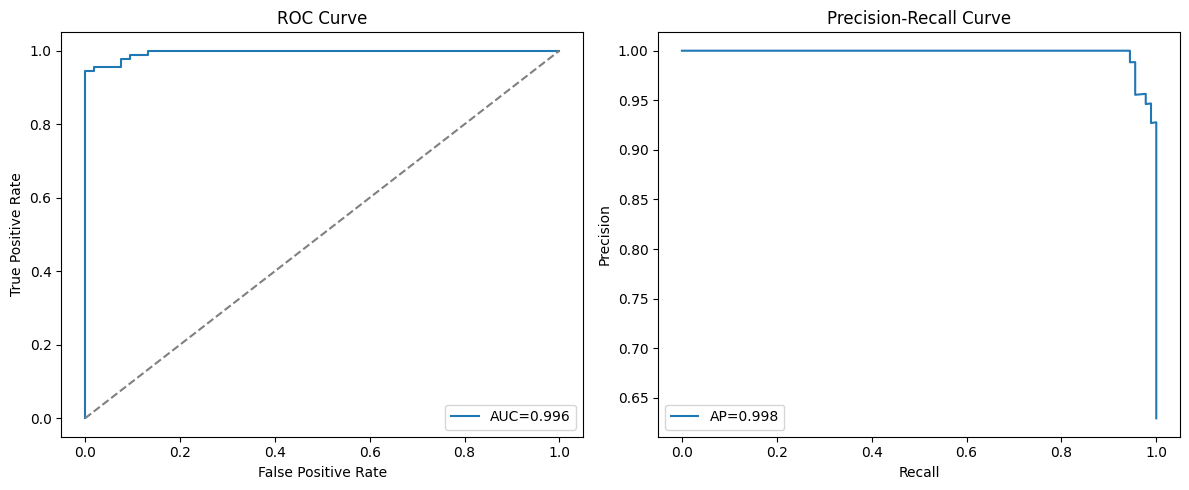
Panduan praktisnya sederhana. Pakai ROC-AUC saat kita butuh gambaran umum kemampuan ranking model pada kelas yang cukup seimbang. Pakai PR-AUC saat kelas positif jarang dan penting, karena metrik ini tidak tersamarkan oleh besarnya kelas negatif.
Metrik hanya berguna bila dipasangkan dengan keputusan yang tepat. We mengajak kamu memperdalam seluruh alur ini di kursus dan bootcamp Machine Learning Rumah Coding, mulai dari preprocessing, pelatihan model, sampai pemilihan metrik evaluasi yang sesuai tujuan bisnis. Pelajari cara membangun pipeline evaluasi model end-to-end bersama mentor yang siap membimbing setiap langkah.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.