Teori dan Implementasi Gaussian Mixture Model untuk Soft Clustering dengan Scikit-learn
Perbedaan Hard Clustering dan Soft Clustering pada Data Overlap
K-Means menetapkan setiap titik data ke tepat satu cluster dengan kepastian penuh. Pendekatan yang disebut _hard clustering_ ini bekerja baik ketika kelompok data terpisah jelas. Masalah muncul ketika dua kelompok saling tumpang tindih dan sebuah titik berada tepat di zona perbatasan.
_Soft clustering_ menyelesaikan masalah tersebut dengan memberikan setiap titik sebuah distribusi probabilitas keanggotaan ke seluruh komponen. Sebuah titik tidak lagi berlabel "cluster A" atau "cluster B" secara mutlak. Titik tersebut memiliki peluang 70% milik cluster A dan 30% milik cluster B, misalnya. Informasi ketidakpastian ini sangat berharga dalam aplikasi nyata.
Contoh konkretnya adalah segmentasi pelanggan. Seorang pelanggan bisa menunjukkan perilaku belanja yang berada di antara segmen "hemat" dan segmen "premium". Memaksanya masuk ke satu segmen akan menghilangkan nuansa penting bagi tim marketing. Dengan probabilitas keanggotaan, kita dapat memperlakukan pelanggan ambigu secara berbeda dari pelanggan yang sudah jelas segmennya. Pelanggan dengan peluang 55:45 layak mendapat penawaran gabungan dari dua segmen. Pelanggan dengan peluang 95:5 bisa diperlakukan seperti anggota penuh segmen dominannya.
Mari kita buat dataset sintetis dengan dua distribusi Gaussian yang saling overlap untuk melihat zona ambigu secara visual.
!pip install numpy matplotlib

import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
cluster_a = np.random.multivariate_normal([0, 0], [[1.0, 0.3], [0.3, 1.0]], 150)
cluster_b = np.random.multivariate_normal([3, 2], [[1.2, -0.4], [-0.4, 1.0]], 150)
data = np.vstack([cluster_a, cluster_b])

plt.figure(figsize=(7, 5))
plt.scatter(cluster_a[:, 0], cluster_a[:, 1], alpha=0.6, label="Grup A")
plt.scatter(cluster_b[:, 0], cluster_b[:, 1], alpha=0.6, label="Grup B")
plt.axvspan(1.0, 2.2, color="gray", alpha=0.15, label="Zona ambigu")
plt.xlabel("Fitur 1")
plt.ylabel("Fitur 2")
plt.title("Dua Gaussian yang Overlap dengan Zona Ambigu")
plt.legend()
plt.show()

print("Total titik:", len(data))
print("Titik dengan Fitur 1 di antara 1.0 dan 2.2:",
      int(np.sum((data[:, 0] > 1.0) & (data[:, 0] < 2.2))))
Output:
Total titik: 300
Titik dengan Fitur 1 di antara 1.0 dan 2.2: 50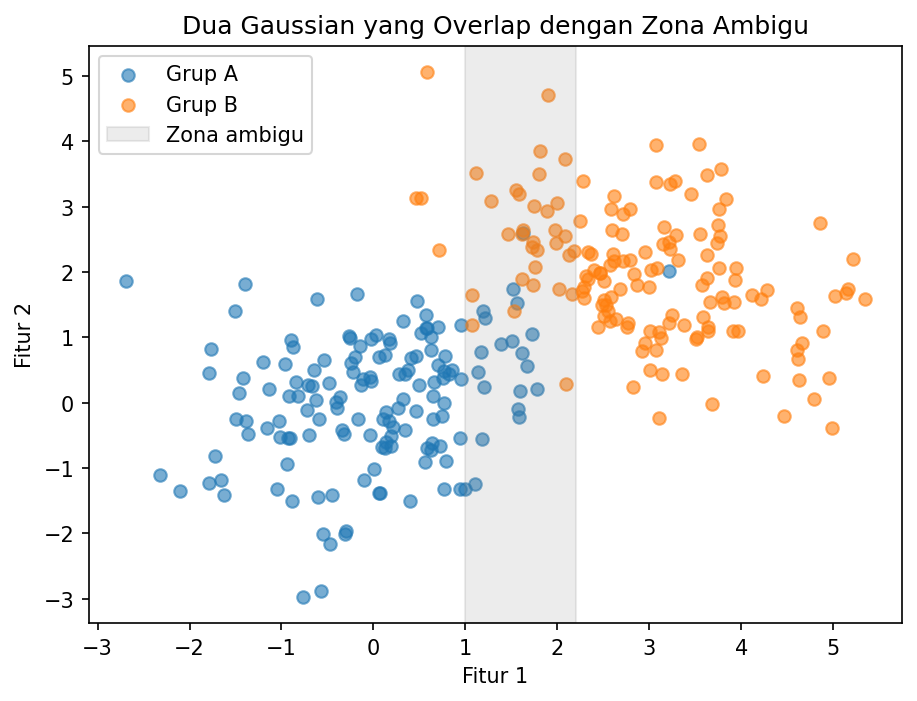
Kode di atas membangkitkan 300 titik dari dua distribusi Gaussian dengan parameter multivariate_normal. Area abu-abu menandai zona ambigu berisi 50 titik yang sulit ditetapkan ke satu grup secara tegas. Titik-titik inilah yang akan ditangani jauh lebih baik oleh pendekatan probabilistik dibanding _hard clustering_.
Cara Kerja Gaussian Mixture Model dan Algoritma Expectation Maximization
Gaussian Mixture Model (GMM) memodelkan data sebagai campuran dari K distribusi Gaussian. Setiap komponen memiliki tiga parameter: _weight_ yang menyatakan proporsi komponen dalam campuran, _mean_ yang menyatakan pusat komponen, dan _covariance_ yang menyatakan bentuk serta orientasi sebaran komponen.
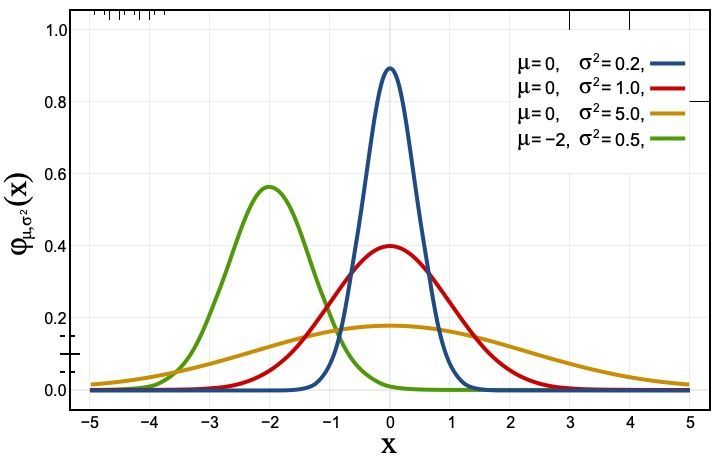
Gambar: Kurva distribusi normal dengan kombinasi _mean_ dan standar deviasi berbeda — setiap komponen GMM berbentuk kurva seperti ini dalam tiap dimensinya. — Sumber: Wikimedia Commons (Inductiveload, Public Domain)
Parameter _covariance_ adalah keunggulan utama GMM dibanding K-Means. Scikit-learn menyediakan empat pilihan: full memberikan matriks kovarians bebas untuk tiap komponen sehingga cluster berbentuk elips dengan orientasi apa pun, tied memakai satu matriks bersama untuk semua komponen, diag hanya mengizinkan elips sejajar sumbu, dan spherical memaksa bentuk bundar seperti K-Means. Pilihan ini mengontrol fleksibilitas model terhadap kompleksitas komputasi.
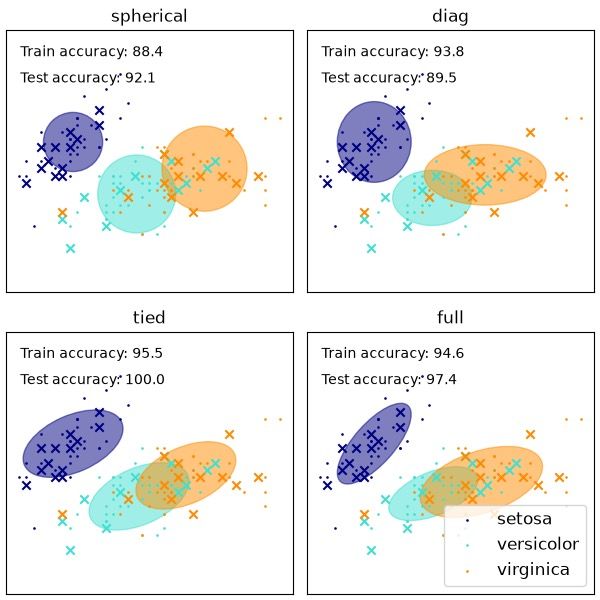
Gambar: Empat tipe kovarians GMM pada dataset yang sama — dari bundar (`spherical`) sampai elips bebas orientasi (`full`). — Sumber: scikit-learn
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from found...
Karena label cluster tidak diketahui, parameter GMM tidak bisa diestimasi dengan rumus tertutup. Solusinya adalah algoritma _Expectation Maximization_ (EM) yang bekerja dalam dua langkah berulang. Pada E-step, algoritma menghitung _responsibility_ yaitu probabilitas setiap titik berasal dari setiap komponen berdasarkan parameter saat ini. Pada M-step, algoritma memperbarui _weight_, _mean_, dan _covariance_ menggunakan _responsibility_ tersebut sebagai bobot. Setiap iterasi EM dijamin tidak menurunkan _log-likelihood_ data. Proses iteratif ini memperbaiki tebakan parameter sedikit demi sedikit berdasarkan bukti dari data itu sendiri.
Iterasi EM berhenti ketika _log-likelihood_ tidak lagi meningkat secara signifikan melewati nilai tol. Perlu kita sadari bahwa EM hanya menjamin konvergensi ke optimum lokal, bukan global. Inilah alasan GaussianMixture memiliki parameter n_init untuk menjalankan optimasi dari beberapa inisialisasi berbeda dan memilih hasil terbaik.
Implementasi GMM dengan Scikit-learn dan Membaca Probabilitas Keanggotaan
Sekarang kita implementasikan GMM menggunakan sklearn.mixture.GaussianMixture. Kelas ini menyediakan metode fit untuk training, predict untuk label cluster, dan predict_proba untuk matriks probabilitas keanggotaan. Metode terakhir inilah yang membedakan GMM dari K-Means.
Kita tetapkan random_state=42 agar hasil reproduksibel dan covariance_type="full" agar model menangkap bentuk elips data. Setelah training, kita analisis kolom probabilitas maksimum untuk memisahkan titik yakin dari titik ambigu dengan threshold 0.7.
!pip install pandas scikit-learn

import pandas as pd
import numpy as np
from sklearn.mixture import GaussianMixture

np.random.seed(42)
cluster_a = np.random.multivariate_normal([0, 0], [[1.0, 0.3], [0.3, 1.0]], 150)
cluster_b = np.random.multivariate_normal([3, 2], [[1.2, -0.4], [-0.4, 1.0]], 150)
data = np.vstack([cluster_a, cluster_b])

gmm = GaussianMixture(n_components=2, covariance_type="full", random_state=42)
gmm.fit(data)

proba = gmm.predict_proba(data)
labels = gmm.predict(data)
max_proba = proba.max(axis=1)

result = pd.DataFrame(data, columns=["fitur_1", "fitur_2"])
result["prob_komponen_0"] = proba[:, 0].round(3)
result["prob_komponen_1"] = proba[:, 1].round(3)
result["max_prob"] = max_proba.round(3)
result["status"] = np.where(max_proba >= 0.7, "yakin", "ambigu")
result["cluster"] = labels

print("Weight komponen:", gmm.weights_.round(3))
print("Mean komponen:\n", gmm.means_.round(2))
print("\nDistribusi status:\n", result["status"].value_counts())
print("\nContoh titik ambigu:\n", result[result["status"] == "ambigu"].head(3))
Output:
Weight komponen: [0.495 0.505]
Mean komponen:
 [[-0.01  0.03]
 [ 2.95  1.97]]

Distribusi status:
 status
yakin     294
ambigu      6
Name: count, dtype: int64

Contoh titik ambigu:
       fitur_1   fitur_2  prob_komponen_0  ...  max_prob  status cluster
7    1.723327  1.058019            0.499  ...     0.501  ambigu       1
55   1.562649  1.531277            0.351  ...     0.649  ambigu       1
214  1.076504  1.651451            0.642  ...     0.642  ambigu       0

[3 rows x 7 columns]
Output menunjukkan model menemukan dua komponen dengan bobot hampir seimbang dan _mean_ yang mendekati pusat asli data. Dari 300 titik, 6 titik terdeteksi ambigu dengan probabilitas maksimum di bawah 0.7 — contohnya titik nomor 7 dengan peluang nyaris 50:50 ke kedua komponen. Workflow ini memberi kita segmentasi sekaligus ukuran kepercayaan untuk setiap keputusan cluster.
Memilih Jumlah Komponen Optimal dengan BIC dan AIC
Menentukan nilai K yang tepat adalah tantangan klasik dalam clustering. GMM menawarkan jawaban yang berdasar statistik melalui dua kriteria: _Bayesian Information Criterion_ (BIC) dan _Akaike Information Criterion_ (AIC). Kedua metrik menyeimbangkan kualitas fit (_log-likelihood_) dengan penalti atas jumlah parameter model.
Aturan praktisnya sederhana: semakin rendah skor BIC atau AIC, semakin baik model. BIC memberikan penalti lebih berat terhadap kompleksitas sehingga cenderung memilih model lebih sederhana dibanding AIC. Dalam praktik, kita prioritaskan BIC ketika menginginkan model parsimoni. Kita gunakan AIC ketika akurasi prediksi lebih penting dari kesederhanaan. Prosedur standarnya adalah melatih GMM untuk rentang nilai n_components, mencatat kedua skor, lalu memilih titik minimum pada kurva BIC.
!pip install scikit-learn matplotlib

import numpy as np
import matplotlib.pyplot as plt
from sklearn.mixture import GaussianMixture

np.random.seed(42)
cluster_a = np.random.multivariate_normal([0, 0], [[1.0, 0.3], [0.3, 1.0]], 150)
cluster_b = np.random.multivariate_normal([3, 2], [[1.2, -0.4], [-0.4, 1.0]], 150)
data = np.vstack([cluster_a, cluster_b])

k_range = range(1, 7)
bic_scores = []
aic_scores = []
for k in k_range:
    model = GaussianMixture(n_components=k, covariance_type="full", random_state=42)
    model.fit(data)
    bic_scores.append(model.bic(data))
    aic_scores.append(model.aic(data))

for k, bic, aic in zip(k_range, bic_scores, aic_scores):
    print(f"K={k}: BIC={bic:.1f}, AIC={aic:.1f}")

plt.figure(figsize=(7, 4))
plt.plot(list(k_range), bic_scores, marker="o", label="BIC")
plt.plot(list(k_range), aic_scores, marker="s", label="AIC")
plt.xlabel("Jumlah komponen (K)")
plt.ylabel("Skor")
plt.title("Pemilihan K Optimal dengan BIC dan AIC")
plt.legend()
plt.show()

print("K terbaik menurut BIC:", int(np.argmin(bic_scores)) + 1)
Output:
K=1: BIC=2169.0, AIC=2150.5
K=2: BIC=2091.8, AIC=2051.0
K=3: BIC=2116.4, AIC=2053.5
K=4: BIC=2150.3, AIC=2065.1
K=5: BIC=2171.6, AIC=2064.2
K=6: BIC=2204.2, AIC=2074.6
K terbaik menurut BIC: 2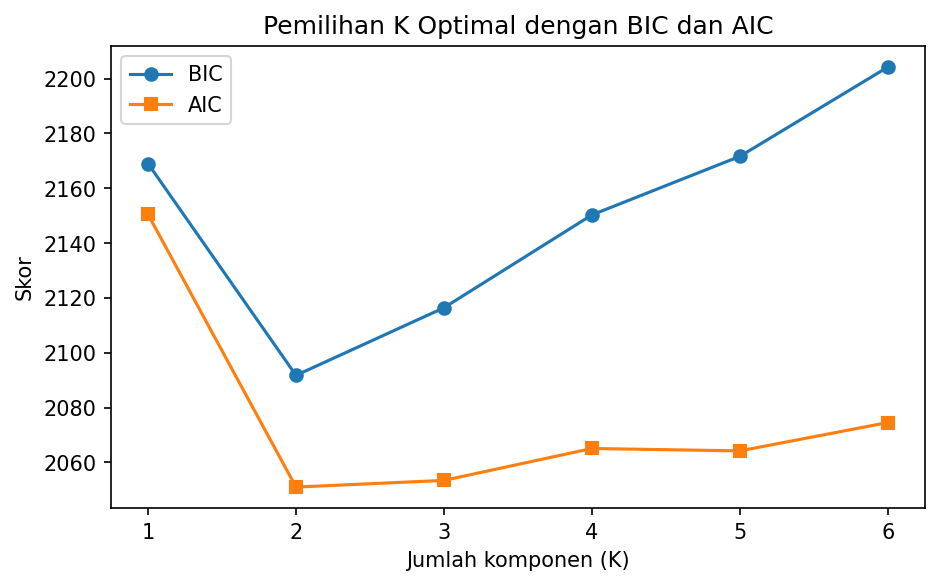
Hasil eksekusi di atas tegas: K=2 menghasilkan skor BIC dan AIC terendah. Skor turun tajam dari K=1 ke K=2 lalu naik kembali karena penalti kompleksitas. Pola lembah ini memberi kita dasar kuantitatif untuk memilih jumlah komponen, jauh lebih formal dibanding membaca titik siku pada grafik Elbow K-Means.
Visualisasi Ellipse Kovarians dan Best Practices GMM
Salah satu visualisasi paling informatif untuk GMM adalah menggambar elips kovarians di atas scatter plot. Setiap elips menunjukkan orientasi dan sebaran satu komponen Gaussian. Visualisasi ini mustahil dihasilkan K-Means karena algoritma tersebut tidak memodelkan kovarians sama sekali.
Kode berikut membandingkan GMM dan K-Means berdampingan pada data elips yang sama. Perhatikan bagaimana batas keputusan GMM mengikuti orientasi data, sementara K-Means memaksakan batas lurus yang memotong cluster secara tidak natural.
!pip install scikit-learn matplotlib

import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Ellipse
from sklearn.mixture import GaussianMixture
from sklearn.cluster import KMeans

np.random.seed(42)
cluster_a = np.random.multivariate_normal([0, 0], [[1.0, 0.3], [0.3, 1.0]], 150)
cluster_b = np.random.multivariate_normal([3, 2], [[1.2, -0.4], [-0.4, 1.0]], 150)
data = np.vstack([cluster_a, cluster_b])

gmm = GaussianMixture(n_components=2, covariance_type="full", random_state=42)
gmm_labels = gmm.fit_predict(data)
kmeans_labels = KMeans(n_clusters=2, n_init=10, random_state=42).fit_predict(data)

fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].scatter(data[:, 0], data[:, 1], c=gmm_labels, cmap="viridis", alpha=0.6)
for mean, cov in zip(gmm.means_, gmm.covariances_):
    eigenvals, eigenvecs = np.linalg.eigh(cov)
    angle = np.degrees(np.arctan2(eigenvecs[1, 0], eigenvecs[0, 0]))
    width, height = 2 * np.sqrt(eigenvals)
    axes[0].add_patch(Ellipse(mean, width, height, angle=angle,
                              edgecolor="red", facecolor="none", linewidth=2))
axes[0].set_title("GMM dengan Ellipse Kovarians")
axes[1].scatter(data[:, 0], data[:, 1], c=kmeans_labels, cmap="viridis", alpha=0.6)
axes[1].set_title("K-Means sebagai Pembanding")
plt.show()

agreement = np.mean(
    (gmm_labels == kmeans_labels) | (gmm_labels == 1 - kmeans_labels)
)
print(f"Kesepakatan label GMM vs K-Means: {agreement:.1%}")
Output:
Kesepakatan label GMM vs K-Means: 100.0%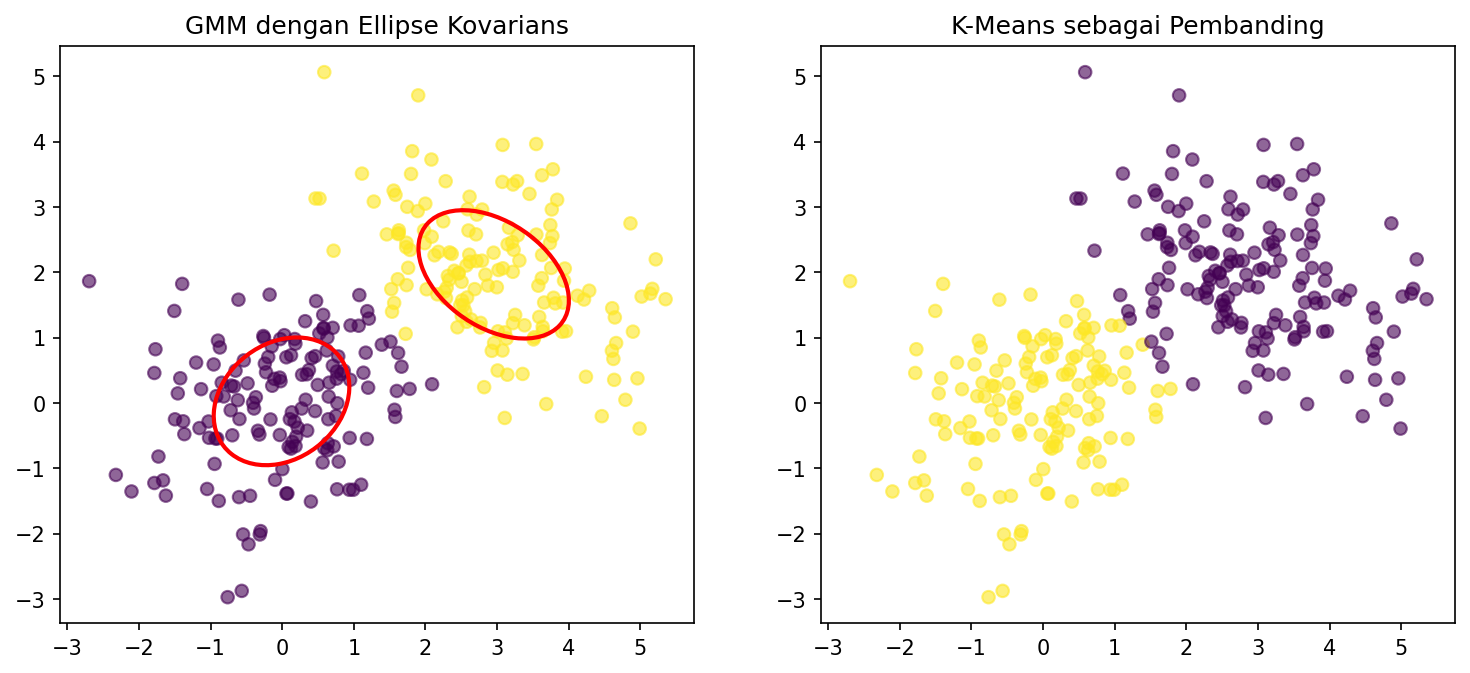
Elips merah pada panel kiri memperlihatkan bentuk dan orientasi tiap komponen Gaussian secara eksplisit. Tingkat kesepakatan 100.0% menunjukkan kedua algoritma memberikan label yang sama pada dataset ini, tetapi GMM memberi dua hal yang tidak dimiliki K-Means: probabilitas kepercayaan tiap titik dan visualisasi bentuk cluster yang sebenarnya. Pada data yang lebih kompleks atau overlap lebih berat, perbedaan label akan muncul — dan di titik-titik itulah probabilitas GMM memberi nilai tambah nyata.
Beberapa praktik terbaik perlu kita pegang. Pertama, standarisasi fitur dengan StandardScaler sebelum training karena GMM berbasis jarak seperti K-Means. Kedua, jalankan training dengan beberapa random_state berbeda untuk menghindari optimum lokal EM yang buruk. Kita bandingkan _log-likelihood_ tiap run dan pertahankan model dengan skor tertinggi. Ketiga, waspadai singularitas kovarians pada dataset kecil — komponen bisa kolaps ke satu titik dan menyebabkan error konvergensi. Solusinya adalah menambah reg_covar atau menyediakan data lebih banyak. Keempat, hindari n_components terlalu besar karena EM akan overfitting dan waktu komputasi meningkat signifikan.
Ikuti bootcamp Machine Learning di Rumah Coding untuk memperdalam _unsupervised learning_ dari clustering sampai _dimensionality reduction_ melalui proyek end-to-end.
Course Terkait
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Machine Learning Bootcamp
A beginner-friendly, 7-week project-based bootcamp designed to take you from Python basics to deploying your first Machine Learning model. Through hands-on practice, you will master essential data manipulation, build predictive algorithms, and develop an end-to-end, industry-ready application to kickstart your career in data science.
End-to-End Student Success Predictor
- Automated Data Pipeline: A preprocessing script that automatically cleans missing values, encodes categorical data (like course type or student background), and scales numerical inputs.
- Predictive Engine: A tuned machine learning classification model (e.g., Random Forest) specifically optimized for high Recall, ensuring that "at-risk" students are not missed.
- Interactive Web Dashboard: A user-friendly Streamlit interface featuring a sidebar where instructors can manually input a student's study hours, quiz scores, and login frequency to get an instant pass/fail probability.
Related Articles
Memahami Konsep Calibration Curve: Teori Kalibrasi Probabilitas Model dengan Implementasi Scikit-learn

Memahami Konsep Loss Function: Teori Cross-Entropy dan MSE dengan Implementasi NumPy dari Nol