Setup Log Aggregation dengan ELK Stack menggunakan Docker Compose: Elasticsearch, Logstash, dan Kibana
Memahami Arsitektur Log Aggregation dan Peran ELK Stack
Saat aplikasi hanya berjalan di satu container, perintah docker logs sudah memadai untuk melihat aktivitas sistem. Ketika jumlah service bertambah menjadi belasan, perintah itu berubah menjadi pekerjaan manual yang melelahkan. Kita harus membuka satu per satu container, lalu mencocokkan timestamp secara manual untuk memahami urutan kejadian. Log aggregation menyelesaikan masalah ini dengan mengumpulkan seluruh log ke satu tempat terpusat.
Memusatkan log dari berbagai service mirip memindahkan berkas dari banyak lemari terpisah ke satu arsip pusat, sehingga pencariannya tidak lagi bergantung pada lokasi asal. ELK Stack menjalankan peran ini melalui tiga komponen dengan tanggung jawab yang jelas. Elasticsearch berperan sebagai penyimpan dan mesin pencari yang meng-index setiap event log. Logstash bertugas menerima log mentah, memprosesnya, dan mengubahnya menjadi field terstruktur. Kibana menyediakan antarmuka untuk menelusuri dan memvisualisasikan data yang sudah tersimpan.
Alur data berjalan searah dan mudah dilacak. Aplikasi menulis log, lalu log tersebut dikirim menuju Logstash. Pada tahap ini filter memecah pesan mentah menjadi field seperti log.level atau service. Hasilnya di-index ke Elasticsearch, kemudian Kibana membaca index tersebut dan menampilkannya dalam bentuk tabel serta grafik. Docker Compose cocok untuk menjalankan rangkaian ini di environment development dan staging karena kita cukup mendefinisikan seluruh service dalam satu file YAML dan menyalakannya dengan satu perintah.
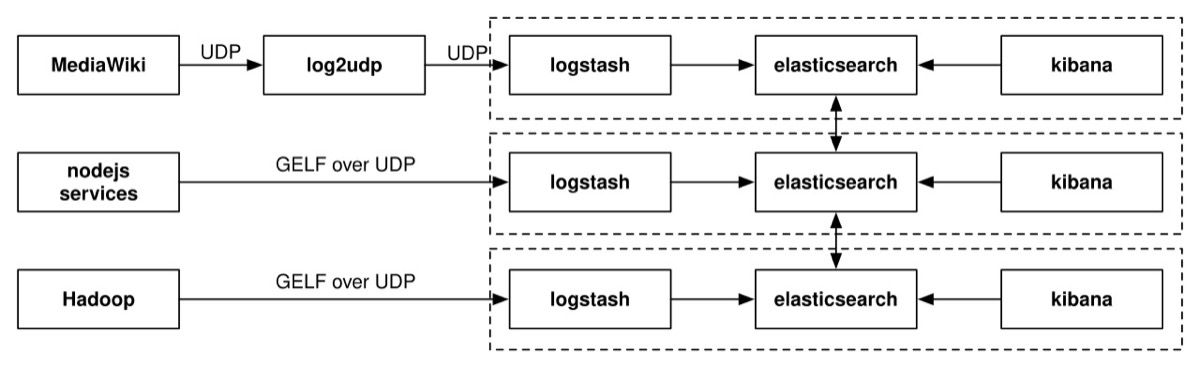
Gambar: Alur log aggregation pada arsitektur ELK — log dari berbagai sumber aplikasi dikirim ke Logstash, diproses, lalu di-index ke Elasticsearch dan dibaca oleh Kibana — Sumber: Wikimedia Commons
Menjalankan Elasticsearch dan Kibana dengan Docker Compose
Kita mulai dari dua service inti, yaitu elasticsearch dan kibana. Keduanya didefinisikan dalam satu file docker-compose.yml supaya bisa dijalankan bersamaan. Konfigurasi berikut sudah mencakup pembatasan heap, penyimpanan data persisten, dan healthcheck untuk memastikan urutan startup yang benar.
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.13.4
    environment:
      - discovery.type=single-node
      - ES_JAVA_OPTS=-Xms512m -Xmx512m
      - xpack.security.enabled=false
    ports:
      - "9200:9200"
    volumes:
      - es-data:/usr/share/elasticsearch/data
    healthcheck:
      test: ["CMD-SHELL", "curl -s http://localhost:9200 || exit 1"]
      interval: 10s
      timeout: 5s
      retries: 10

  kibana:
    image: docker.elastic.co/kibana/kibana:8.13.4
    environment:
      - ELASTICSEARCH_HOSTS=http://elasticsearch:9200
    ports:
      - "5601:5601"
    depends_on:
      elasticsearch:
        condition: service_healthy

volumes:
  es-data:
Parameter discovery.type=single-node membuat Elasticsearch berjalan tanpa proses clustering, yang sesuai untuk satu node development. Opsi ES_JAVA_OPTS membatasi heap pada 512MB agar host tidak kehabisan RAM. Volume es-data memastikan index tetap ada setelah container di-restart, sedangkan depends_on dengan condition: service_healthy menahan Kibana sampai Elasticsearch benar-benar siap menerima koneksi.
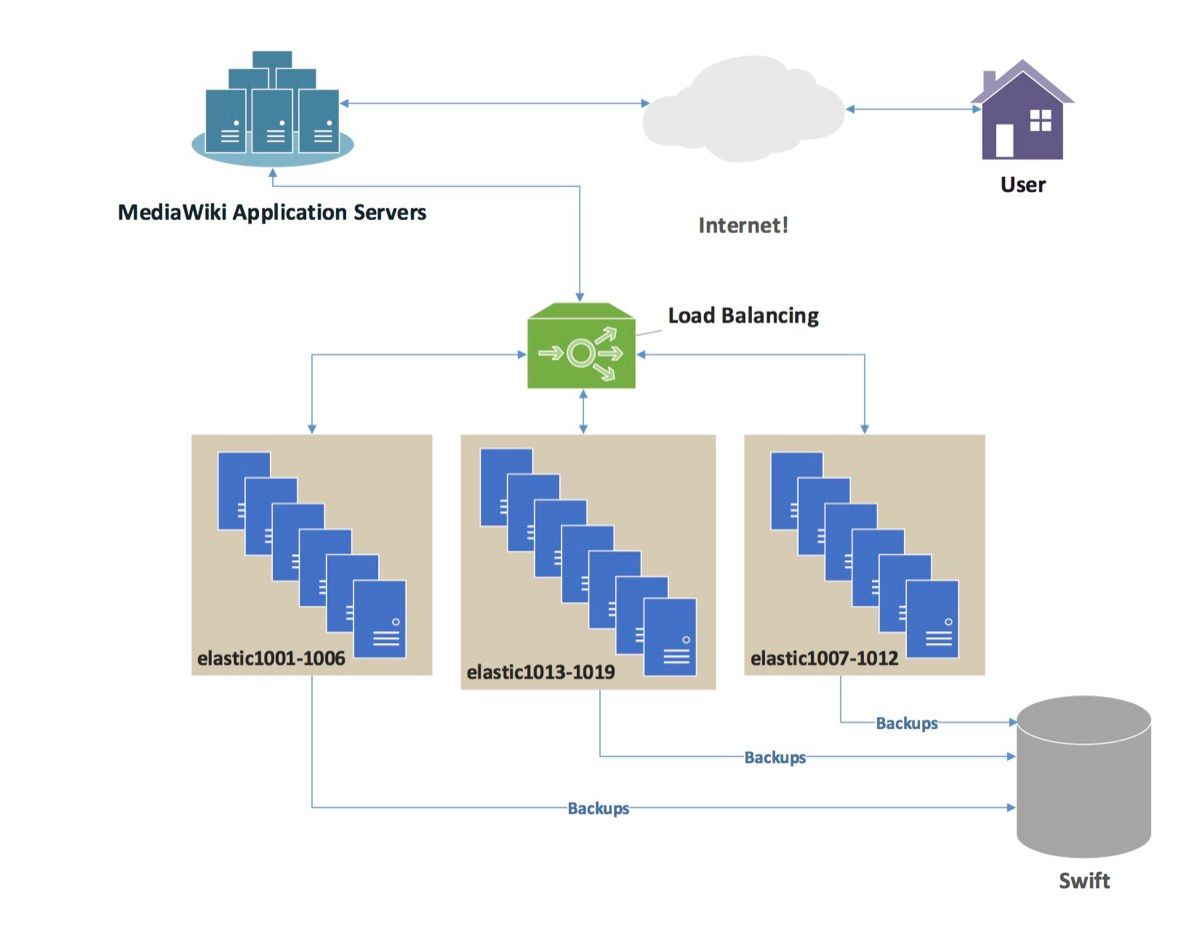
Gambar: Contoh cluster Elasticsearch multi-node di lingkungan produksi dengan load balancing dan backup — berbeda dari setup single-node pada Docker Compose di atas — Sumber: Wikimedia Commons
Setelah file disimpan, kita jalankan docker compose up -d untuk menyalakan kedua service. Untuk memverifikasi bahwa cluster sudah aktif, kita panggil endpoint kesehatan Elasticsearch dengan curl -s localhost:9200. Respons yang kita harapkan adalah JSON berisi cluster_name, version.number, dan tagline: "You Know, for Search". Jika JSON tersebut muncul, Kibana sudah bisa diakses melalui http://localhost:5601.
Mengonfigurasi Logstash Pipeline untuk Parsing Log
Python Fundamentals
Master the fundamentals of Python through hands-on, real-world projects. Designe...
Logstash memproses log melalui tiga tahap berurutan, yaitu input, filter, dan output. Tahap input menerima data, filter mengubahnya menjadi field terstruktur, dan output mengirimkannya ke tujuan akhir. Kita mendaftarkan service logstash ke Compose dan memasang volume berisi konfigurasi pipeline.
  logstash:
    image: docker.elastic.co/logstash/logstash:8.13.4
    volumes:
      - ./logstash/pipeline:/usr/share/logstash/pipeline
    ports:
      - "5044:5044"
      - "12201:12201/udp"
    depends_on:
      elasticsearch:
        condition: service_healthy
Isi file logstash/pipeline/logstash.conf menentukan bagaimana log diproses. Kita menambahkan input beats untuk Filebeat dan input gelf untuk logging driver Docker, lalu memparse pola log dengan grok.
input {
  beats {
    port => 5044
  }
  gelf {
    port => 12201
  }
}

filter {
  grok {
    match => { "message" => "%{TIMESTAMP_ISO8601:log.timestamp} %{LOGLEVEL:log.level} %{GREEDYDATA:log.message}" }
  }
  date {
    match => ["log.timestamp", "ISO8601"]
    target => "@timestamp"
  }
}

output {
  elasticsearch {
    hosts => ["http://elasticsearch:9200"]
    index => "app-logs-%{+YYYY.MM.dd}"
  }
}
Filter grok bekerja dengan mencocokkan pola pada field message. Pola di atas memecah baris log menjadi tiga field, yaitu log.timestamp, log.level, dan log.message. Filter date memakai nilai log.timestamp sebagai @timestamp agar urutan waktu konsisten dengan waktu asli kejadian. Pada tahap output, blok index => "app-logs-%{+YYYY.MM.dd}" membuat index harian sehingga data lama mudah dipisahkan. Kita bisa memantau prosesnya lewat docker compose logs -f logstash dan mencari baris yang menandakan event berhasil di-index.
Mengirim Log Aplikasi ke ELK Stack
Ada dua cara menghubungkan aplikasi ke pipeline Logstash. Pendekatan pertama memakai logging driver Docker secara langsung, dan pendekatan kedua memakai Filebeat sebagai pengumpul. Pendekatan logging driver lebih ringkas karena setiap baris stdout container otomatis diteruskan tanpa proses tambahan.
  api:
    build: ./api
    environment:
      - SERVICE_NAME=api
      - ENVIRONMENT=staging
    logging:
      driver: gelf
      options:
        gelf-address: "udp://logstash:12201"
Driver gelf mengirim setiap baris log ke logstash:12201 sesuai input gelf yang sudah kita definisikan. Field SERVICE_NAME dan ENVIRONMENT disertakan sebagai metadata, sehingga kita bisa memfilter log berdasarkan service maupun environment. Agar semua log tertangkap, aplikasi harus menulis ke stdout dan stderr, bukan ke file terpisah di dalam container. Contoh aplikasi Python berikut menulis log terstruktur ke stdout dengan memanfaatkan modul logging bawaan.
import logging
import sys

logging.basicConfig(
    level=logging.INFO,
    stream=sys.stdout,
    format="%(asctime)s %(levelname)s %(message)s",
)

logger = logging.getLogger("api")
logger.info("server started on port 8000")
logger.error("database connection timeout")
Output:
2026-10-15 04:10:03,800 INFO server started on port 8000
2026-10-15 04:10:03,800 ERROR database connection timeout
Output yang diharapkan muncul di docker compose logs -f logstash adalah event baru dengan field service, log.level, dan message yang sudah terisi. Jika kita memilih pendekatan Filebeat, konfigurasinya cukup diarahkan ke container log dan output beats pada port 5044.
Menelusuri dan Memvisualisasikan Log di Kibana
Langkah pertama di Kibana adalah membuat data view yang menunjuk ke index app-logs-*. Setelah itu kita bisa melihat daftar field yang tersedia dan memverifikasi bahwa @timestamp, log.level, service, dan message terbaca dengan tipe yang tepat. Untuk menelusuri log, kita memakai bahasa query KQL pada kolom pencarian, misalnya service: "api" and log.level: "error" untuk mempersempit hasil ke error dari service tertentu.
Selain penelusuran, kita sering membutuhkan agregasi jumlah log per interval waktu. Query _search berikut mengambil jumlah error per jam tanpa mengembalikan dokumen mentah, sehingga responsnya jauh lebih kecil.
GET app-logs-*/_search
{
  "size": 0,
  "query": {
    "bool": {
      "filter": [
        { "term": { "service.keyword": "api" } },
        { "term": { "log.level": "error" } }
      ]
    }
  },
  "aggs": {
    "errors_over_time": {
      "date_histogram": {
        "field": "@timestamp",
        "calendar_interval": "1h"
      }
    }
  }
}
Parameter size: 0 menonaktifkan pengembalian dokumen karena kita hanya menginginkan hasil agregasi. Blok bool.filter menyaring dokumen dengan service bernilai api dan log.level bernilai error. Agregasi date_histogram mengelompokkan hasil per jam, sehingga respons berisi array buckets dengan field key dan doc_count. Dari data ini kita bisa membangun grafik jumlah error per jam pada Dashboards. Caranya, kita membuat visualisasi Line dengan sumbu waktu dari @timestamp dan metrik Count, lalu menyimpannya ke dalam dashboard. Kombinasi KQL untuk penyaringan dan chart untuk pemantauan membuat pola error jangka panjang lebih mudah terlihat dibanding membaca log satu per satu.
Best Practices untuk Log Pipeline yang Stabil
Stabilitas pipeline sangat bergantung pada pengelolaan resource. Elasticsearch dan Logstash sama-sama mengonsumsi memori dalam jumlah besar, jadi kita perlu menetapkan batas heap melalui ES_JAVA_OPTS dan membatasi memori Logstash dengan opsi LS_JAVA_OPTS. Tanpa batas ini, host bisa kehabisan RAM saat volume log meningkat.
Untuk mengendalikan ukuran data, kita bisa memakai index harian seperti app-logs-%{+YYYY.MM.dd} yang sudah diterapkan sebelumnya. Pendekatan lanjutan adalah Index Lifecycle Management yang otomatis memindahkan index lama ke penyimpanan lebih murah atau menghapusnya setelah periode tertentu. Strategi ini menjaga ukuran cluster tetap terkendali tanpa intervensi manual.
Dari sisi keamanan, stack ini sebaiknya tidak diekspos langsung ke internet. Kita bisa menahan akses hanya pada network internal Compose dan mengaktifkan autentikasi xpack.security ketika berjalan di environment yang lebih terbuka. Terakhir, terapkan healthcheck dan restart policy pada setiap service. Elasticsearch harus sehat lebih dulu sebelum Logstash dan Kibana dijalankan, dan restart: unless-stopped memastikan service yang berhenti karena masalah sementara akan hidup kembali secara otomatis.
Membangun observability yang andal adalah keterampilan inti untuk setiap engineer backend dan DevOps. Jika kita ingin mendalami container orchestration, monitoring, dan deployment production secara terstruktur, Bootcamp Docker & DevOps Rumah Coding menyediakan jalur belajar lengkap dari dasar sampai praktik di lingkungan nyata.
Course Terkait
Python Fundamentals
Master the fundamentals of Python through hands-on, real-world projects. Designed for absolute beginners, this course takes you from writing your first line of code to building a fully functional application. By the end of this course, you will have a solid grasp of core programming concepts, data structures, and file management, laying a strong foundation for future studies in Data Science, Web Development, or Automation.
Personal Finance Tracker & Analyzer (CLI)
- Interactive Main Menu: A continuous loop menu allowing users to choose between adding records, viewing summaries, or exiting the app.
- Transaction Logging: Users can input transaction types (Income/Expense), amounts, categories (e.g., Food, Salary, Transport), and descriptions.
- Robust Input Validation: Utilizes try-except blocks to prevent the program from crashing if a user accidentally types letters instead of numbers for financial amounts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.