Teori dan Implementasi Learning Curve untuk Mendiagnosis Overfitting dan Underfitting dengan Scikit-learn
Keterbatasan Evaluasi Tunggal dalam Menilai Kualitas Model
Satu angka akurasi jarang cukup untuk menilai kualitas model. Ketika kita melatih model dan melihat skor 0.98 pada training set, godaan untuk langsung menyimpulkan model bekerja sangat baik sangat besar. Masalahnya, skor tinggi di data yang sudah dilihat model tidak membuktikan apa pun tentang data baru. Model bisa saja menghafal setiap sampel training alih-alih mempelajari pola yang sebenarnya.
Ada dua gejala yang tidak akan terlihat dari satu skor. Yang pertama adalah overfitting, saat skor training tinggi tetapi performa pada data validation jatuh. Yang kedua adalah underfitting, saat kedua skor sama-sama rendah karena model terlalu sederhana untuk menangkap struktur data. Kedua kondisi ini menuntut aksi perbaikan yang berlawanan arah, sehingga salah mendiagnosis berarti salah memperbaiki.
Pendekatan train_test_split tunggal juga punya keterbatasan lain. Hasil evaluasi sangat bergantung pada cara data dibagi, dan pembagian acak yang berbeda bisa menghasilkan skor yang berbeda jauh. Lebih dari itu, satu split tidak memberi tahu arah perbaikan. Satu split hanya menunjukkan berapa skor akhir, tetapi bukan mengapa skor itu rendah atau apakah menambah data akan membantu.
Di sinilah learning curve berperan. Alih-alih satu angka, learning curve menunjukkan bagaimana performa berubah seiring bertambahnya jumlah data training. Bentuk kurvanya memperlihatkan arah masalahnya, bukan hanya besarnya.
Membaca Bentuk Learning Curve untuk Membedakan Overfitting dan Underfitting
Learning curve adalah plot dua garis: skor training dan skor validation, masing-masing digambar terhadap ukuran training set pada sumbu horizontal. Cara membacanya bergantung pada bentuk dan jarak kedua garis.
Pada kasus overfitting kita melihat jarak yang lebar antara keduanya. Kurva training bertahan di skor tinggi, sementara kurva validation masih rendah. Gap antara training dan validation score itu seperti selisih antara nilai latihan dan nilai ujian, besar selisihnya menandakan model hanya menghafal soal latihan. Model semacam ini punya variance tinggi karena sangat peka terhadap detail data training dan gagal menggeneralisasi.
Pola underfitting justru sebaliknya. Kedua kurva bertemu di skor yang rendah karena model terlalu sederhana untuk menangkap pola yang ada. Model ini punya bias tinggi, dan menambah data tidak akan banyak menolong karena kapasitasnya memang kurang.
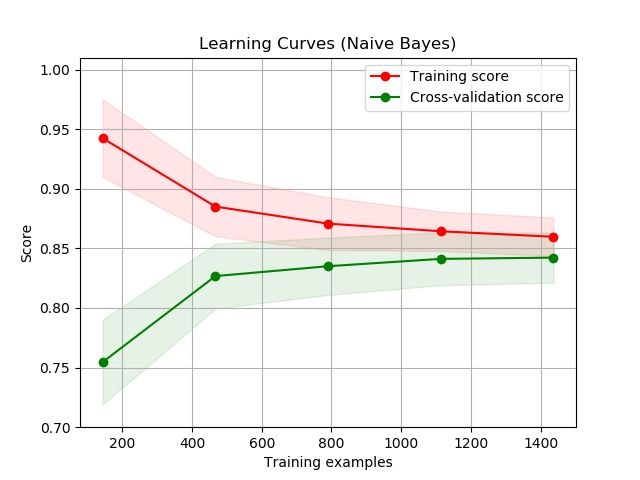
Gambar: Contoh learning curve dengan dua kurva training dan cross-validation yang konvergen karena gap menyempit seiring bertambahnya data (naive Bayes) — Sumber: Wikimedia Commons
Kondisi ideal ditandai oleh dua kurva yang konvergen menuju skor tinggi dengan gap yang sempit. Kedua kurva yang konvergen menuju skor tinggi menandakan model sudah belajar pola yang benar, bukan menghafal data.
Sumbu horizontal pada learning curve umumnya berskala logaritmik, dan keputusan ini penting. Sebagian besar perbaikan performa terjadi pada penambahan data pertama. Pada kasus high variance, kurva validation akan terus menanjak dan mendekati kurva training ketika data ditambah. Kalau kedua garis sudah bertemu sebelum data habis, menambah data lebih banyak tidak lagi memberi manfaat besar.
Menghasilkan Learning Curve dengan fungsi learning_curve dari Scikit-learn
Scikit-learn menyediakan fungsi learning_curve dari modul sklearn.model_selection yang mengotomatiskan seluruh proses. Fungsi ini menyelesaikan satu tugas: melatih ulang model pada subset data training dengan berbagai ukuran, lalu mengevaluasinya pada data validation memakai cross-validation.
Tiga parameter mengendalikan perilakunya. train_sizes menentukan ukuran subset yang diuji, bisa berupa proporsi dari 0.1 sampai 1.0 atau jumlah absolut sampel. cv menentukan jumlah lipatan cross-validation di tiap ukuran, sementara scoring memilih metrik evaluasi seperti accuracy atau f1.
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Struktur outputnya penting untuk dipahami. Fungsi mengembalikan tiga array. train_sizes_abs berisi jumlah sampel absolut yang benar-benar dipakai di tiap iterasi. train_scores dan test_scores berbentuk dua dimensi: satu baris per ukuran training set dan satu kolom per fold. Bentuk dua dimensi inilah yang memungkinkan kita mengukur stabilitas model antar fold, bukan sekadar skor rata-rata.
Workflow-nya sederhana. Untuk setiap ukuran training set, learning_curve menjalankan cv kali pelatihan dan evaluasi. Kita lalu meringkas hasilnya dengan mean dan std pada sumbu kolom, sehingga tiap ukuran training set terwakili oleh satu nilai rata-rata beserta deviasinya. Ringkasan inilah yang nantinya digambar menjadi kurva.
Kode berikut menghasilkan learning curve dari satu model dan mencetak rata-rata skor training serta validation untuk setiap ukuran training set.
!pip install scikit-learn numpy

import numpy as np
from sklearn.datasets import load_iris
from sklearn.model_selection import learning_curve
from sklearn.tree import DecisionTreeClassifier

X, y = load_iris(return_X_y=True)
model = DecisionTreeClassifier(random_state=42)

train_sizes, train_scores, test_scores = learning_curve(
    model, X, y,
    train_sizes=np.linspace(0.1, 1.0, 6),
    cv=5,
    scoring="accuracy",
    shuffle=True,
    random_state=42,
)

train_mean = train_scores.mean(axis=1)
test_mean = test_scores.mean(axis=1)

print(f"{'Train size':>10} | {'Train':>7} | {'Validation':>10}")
print("-" * 34)
for size, tr, te in zip(train_sizes, train_mean, test_mean):
    print(f"{size:>10} | {tr:>7.3f} | {te:>10.3f}")
Output:
Train size |   Train | Validation
----------------------------------
        12 |   1.000 |      0.833
        33 |   1.000 |      0.953
        55 |   1.000 |      0.947
        76 |   1.000 |      0.940
        98 |   1.000 |      0.947
       120 |   1.000 |      0.953
Output di atas memperlihatkan pola khas decision tree tanpa batas kedalaman. Skor training menempel di angka 1.000 pada semua ukuran, tetapi skor validation bergerak di sekitar 0.95 dan tidak pernah menyamainya. Gap yang tersisa ini adalah sinyal overfitting: model menghafal seluruh data training, sementara performa pada data validation tertinggal.
Visualisasi dan Diagnosis pada Dataset Sintetis dengan Dua Model Pembanding
Untuk melihat pola overfitting dan underfitting secara langsung, kita butuh dua model dengan karakter berbeda pada satu dataset yang sama. Dataset sintetis dari make_classification memberi kita skenario terkontrol: kita tahu jumlah fitur informatif dan bisa menyuntikkan sedikit label noise lewat parameter flip_y.
Kita bandingkan dua model. DecisionTreeClassifier tanpa batas kedalaman bisa tumbuh sampai menghafal setiap sampel training, sehingga rentan overfitting. LogisticRegression menarik batas keputusan linear yang kaku, sehingga cenderung underfitting pada data yang butuh interaksi non-linear.
Kode berikut membangun dataset, menghitung learning curve kedua model, lalu menggambarnya berdampingan. Pita tipis di sekitar tiap garis adalah standar deviasi antar fold dari fill_between, penanda seberapa stabil skor pada tiap ukuran data.
!pip install scikit-learn numpy matplotlib

import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import learning_curve

X, y = make_classification(
    n_samples=1000, n_features=20, n_informative=4,
    n_redundant=2, n_classes=2, flip_y=0.05, random_state=42,
)

models = {
    "DecisionTree (tanpa batas)": DecisionTreeClassifier(random_state=42),
    "LogisticRegression": LogisticRegression(max_iter=1000, random_state=42),
}

fig, axes = plt.subplots(1, 2, figsize=(13, 5), sharey=True)

for ax, (name, model) in zip(axes, models.items()):
    sizes, train_scores, test_scores = learning_curve(
        model, X, y, train_sizes=np.linspace(0.1, 1.0, 6),
        cv=5, scoring="accuracy", shuffle=True, random_state=42,
    )
    train_mean, train_std = train_scores.mean(axis=1), train_scores.std(axis=1)
    test_mean, test_std = test_scores.mean(axis=1), test_scores.std(axis=1)

    ax.plot(sizes, train_mean, "o-", color="tab:blue", label="Training score")
    ax.fill_between(sizes, train_mean - train_std, train_mean + train_std, alpha=0.15, color="tab:blue")
    ax.plot(sizes, test_mean, "o-", color="tab:orange", label="Validation score")
    ax.fill_between(sizes, test_mean - test_std, test_mean + test_std, alpha=0.15, color="tab:orange")

    ax.set_title(name)
    ax.set_xlabel("Jumlah data training")
    ax.set_ylim(0.5, 1.02)
    ax.legend(loc="lower right")
    ax.grid(alpha=0.3)

axes[0].set_ylabel("Accuracy")
plt.tight_layout()
plt.show()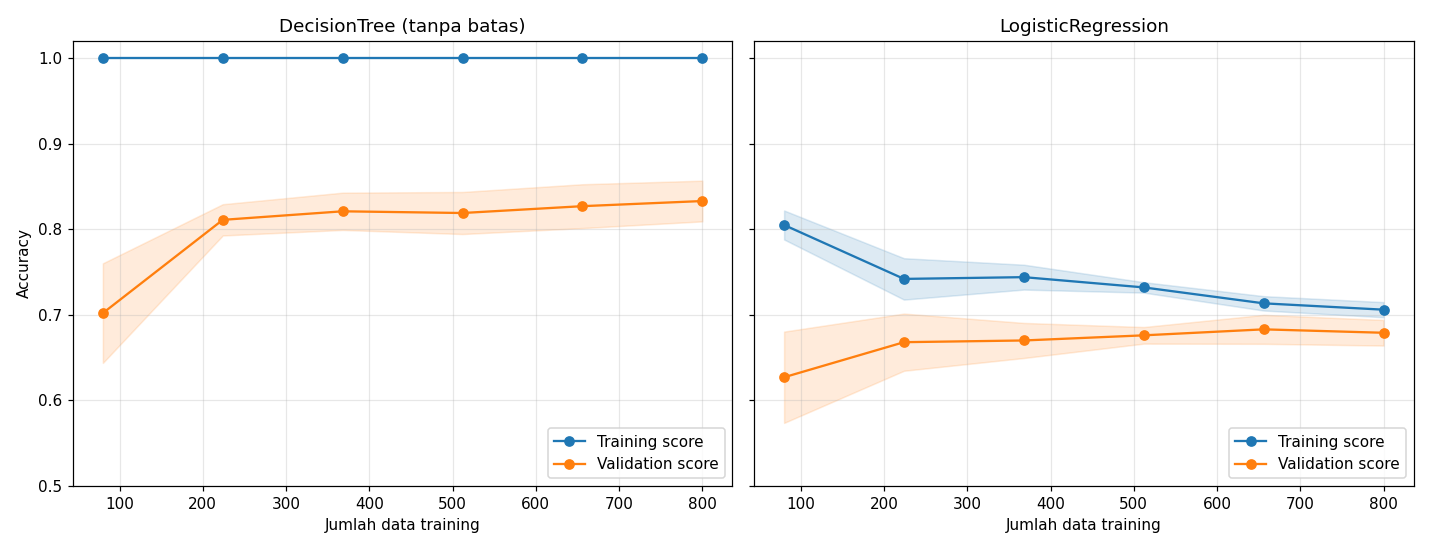
Gambar: Dua subplot learning curve berdampingan. Panel kiri menunjukkan DecisionTree yang overfitting, panel kanan menunjukkan LogisticRegression yang underfitting. Sumber: output penulis.
Setelah plot muncul, diagnosis menjadi visual. Kurva DecisionTree menunjukkan garis training yang menempel di angka 1.000 sementara garis validation tertinggal di sekitar 0.83 dengan gap lebar, ciri high variance. Kurva LogisticRegression justru menunjukkan dua garis yang rapat tetapi bertemu di skor sedang: training sekitar 0.71 dan validation sekitar 0.68, ciri high bias. Perbandingan berdampingan ini membuat perbedaan kedua masalah terlihat jelas, bukan sekadar terduga dari satu angka akurasi.
Aksi Perbaikan Berdasarkan Hasil Diagnosis Learning Curve
Setiap diagnosis mengarah pada satu set aksi yang berbeda, dan itulah nilai praktis learning curve.
Jika gap antara training dan validation lebar, model mengalami high variance. Aksi yang masuk akal adalah menambah data training, menerapkan regularisasi seperti membatasi max_depth pada decision tree atau menambah penalti L2 pada regresi, mengurangi fitur yang tidak relevan, atau memilih model yang lebih sederhana. Menambah data akan menutup gap karena kurva validation naik mendekati kurva training.
Jika kedua kurva bertemu di skor rendah, model mengalami high bias. Solusinya berbanding balik: tingkatkan kompleksitas model, tambahkan fitur yang relevan, atau ganti ke model non-linear yang mampu menangkap interaksi. Menambah data pada kondisi ini nyaris tidak menolong.
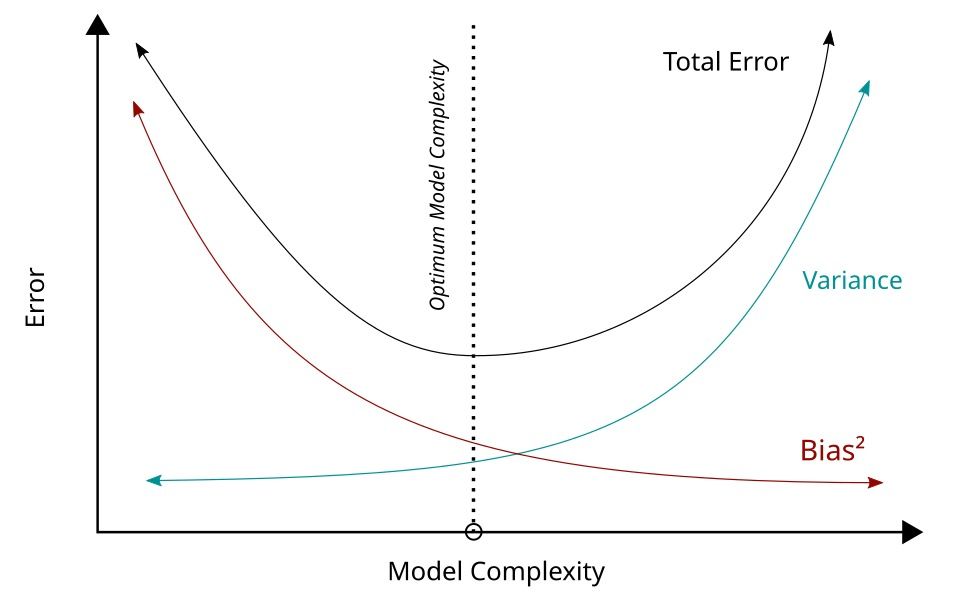
Gambar: Dekomposisi total error menjadi komponen bias kuadrat dan variance terhadap kompleksitas model, lengkap dengan titik kompleksitas optimal — Sumber: Wikimedia Commons
Learning curve bekerja paling baik sebagai pemeriksaan awal, bukan alat tuning tunggal. Setelah arah masalah diketahui, kita bisa mempersempit pencarian dengan validation_curve untuk melacak pengaruh satu hyperparameter, lalu GridSearchCV untuk mencari kombinasi terbaik pada rentang yang sudah menyempit.
Ada beberapa jebakan umum. Kurva bisa terlihat berisik kalau cv terlalu kecil sehingga variansi antar fold besar. Dataset yang terlalu sedikit membuat kurva validation naik-turun tajam. Metrik scoring yang tidak sesuai tujuan bisnis juga bisa menyesatkan: akurasi pada data tidak seimbang, misalnya, menyembunyikan performa buruk pada kelas minoritas. Jadikan learning curve sebagai pemeriksaan rutin sebelum kita mengejar angka akurasi akhir.
Ingin menguasai alur evaluasi model dari awal sampai diagnosis overfitting dan underfitting secara end-to-end? Rumah Coding menyediakan bootcamp Machine Learning yang membahas learning curve, cross-validation, dan model selection dengan studi kasus praktis.
Kursus Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.