Memahami Konsep Cost-Sensitive Learning: Menangani Kesalahan Prediksi dengan Bobot Kelas di Scikit-learn
Kapan Akurasi Menyesatkan dan Mengapa Biaya Kesalahan Tidak Setara
Cost-sensitive learning bertolak dari satu asumsi: tidak semua kesalahan prediksi berharga sama. Model klasifikasi standar memperlakukan false positive dan false negative sebagai kesalahan yang setara, padahal pada banyak kasus nyata keduanya punya dampak yang jauh berbeda. Pada deteksi fraud, melewatkan satu transaksi curang (false negative) menimbulkan kerugian langsung, sementara menandai transaksi normal sebagai curang (false positive) hanya memicu verifikasi tambahan. Keduanya jelas tidak sebanding.
Akurasi menjadi metrik yang menyesatkan ketika distribusi kelas timpang. Model yang memprediksi semua sampel sebagai kelas mayoritas tetap mendapat akurasi tinggi, namun recall kelas minoritas bisa nol. Kita perlu merepresentasikan biaya tiap jenis kesalahan secara eksplisit melalui cost matrix, yaitu matriks yang memberi bobot pada tiap sel confusion matrix. Nilai pada matriks ini menentukan seberapa besar penalti untuk false positive dibanding false negative.
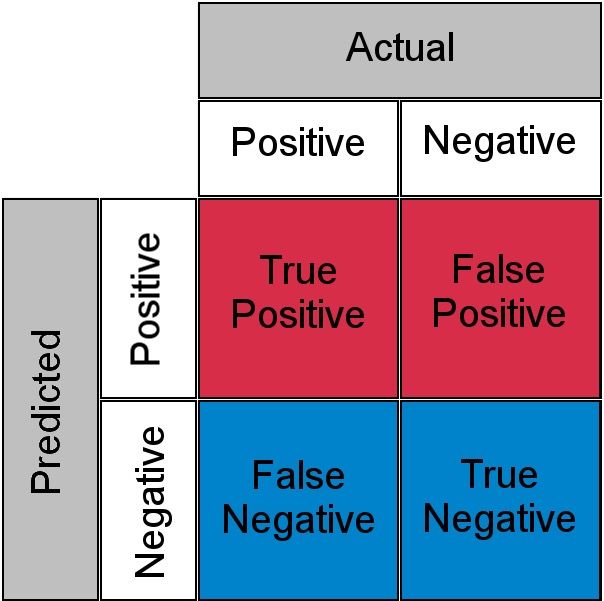
Gambar: Matriks konfusi biner, dasar penyusunan cost matrix (domain publik) — Sumber: Wikimedia Commons
Kita mulai dengan membangun dataset tidak seimbang dan mengamati perilaku model default.
!pip install scikit-learn numpy
import numpy as np
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X, y = make_classification(
    n_samples=5000, n_features=20, n_informative=5,
    n_redundant=2, weights=[0.95, 0.05], flip_y=0.01, random_state=42,
)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, stratify=y, random_state=42,
)
print("Distribusi kelas train:", np.bincount(y_train))

model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train)
print(classification_report(y_test, model.predict(X_test), digits=3))
Output:
Distribusi kelas train: [3311  189]
              precision    recall  f1-score   support

           0      0.952     0.997     0.974      1419
           1      0.714     0.123     0.211        81

    accuracy                          0.950      1500
   macro avg      0.833     0.560     0.592      1500
weighted avg      0.939     0.950     0.933      1500
Kita membangun 5000 sampel dengan weights=[0.95, 0.05], sehingga kelas positif minoritas hanya sekitar 5% dari data. Setelah melatih LogisticRegression tanpa bobot, classification_report menampilkan akurasi sekitar 94–95%, namun recall kelas minoritas biasanya hanya berkisar 0.3–0.5. Angka ini membuktikan model lebih memilih menjaga kelas mayoritas dan mengabaikan sebagian besar kasus positif. Dari sini kita tahu bahwa akurasi keseluruhan bukan indikator yang dapat dipercaya untuk kasus biaya asimetris.
Bagaimana Bobot Kelas Mengubah Fungsi Objektif Model
Parameter class_weight bekerja dengan mengalikan kontribusi loss setiap sampel dengan bobot kelasnya. Setiap kesalahan pada kelas minoritas ditagih lebih mahal pada fungsi objektif, sehingga model terdorong menekan kesalahan tersebut. Untuk setting 'balanced', Scikit-learn menghitung bobot tiap kelas dengan rumus berikut.
weight per kelas = n_samples / (n_classes * count_class)
Kelas yang jumlahnya sedikit mendapat bobot lebih besar, dan sebaliknya. Nilai ini setara dengan memberi perhatian ekstra pada kelas minoritas saat optimisasi. Hubungan class_weight dan sample_weight terletak pada granularitas: class_weight menetapkan bobot per kelas, sedangkan sample_weight menetapkan bobot per baris data. Ketika cost matrix bergantung pada atribut tiap baris, bukan hanya label, sample_weight menjadi representasi yang lebih fleksibel.
Efek akhirnya terlihat pada decision boundary. Model bergeser menerima lebih banyak false positive demi menekan false negative, sehingga recall kelas minoritas naik dengan konsekuensi precision yang biasanya turun. Pergeseran ini adalah trade-off yang memang kita inginkan ketika biaya false negative jauh lebih besar. Perlu dicatat bahwa bobot tidak mengubah informasi yang tersedia pada data; parameter ini hanya mengubah cara model memprioritaskan kesalahan.
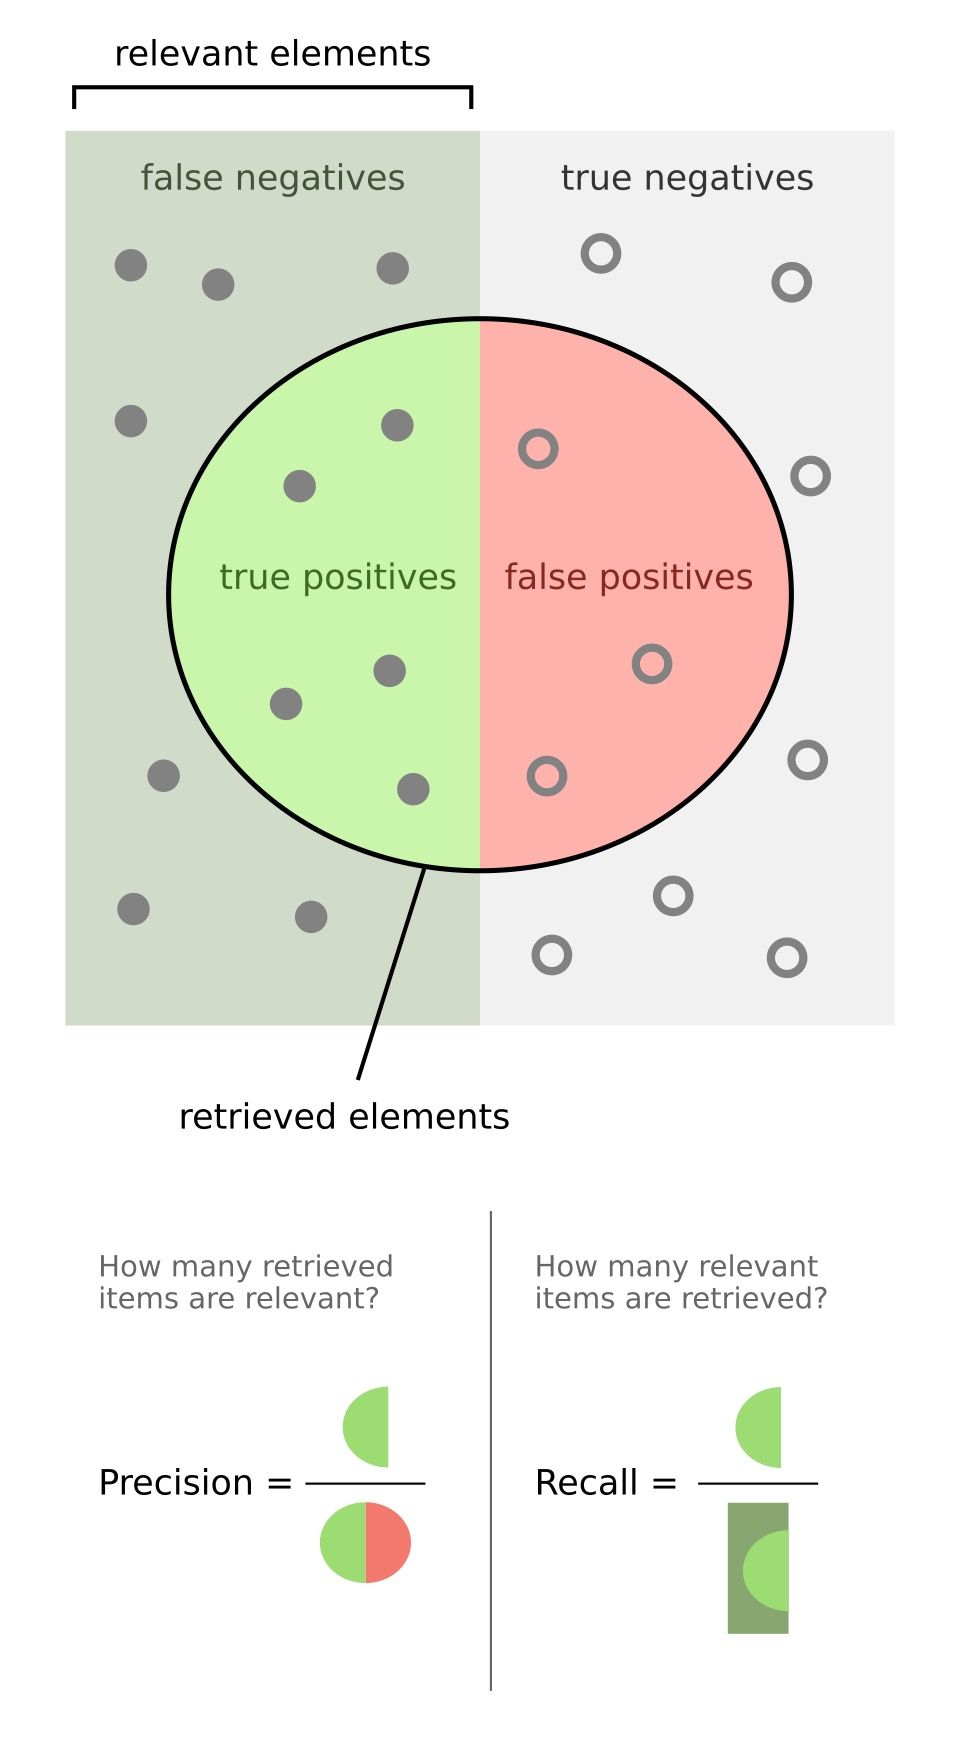
Gambar: Diagram konsep precision dan recall pada klasifikasi biner (CC BY-SA 4.0) — Sumber: Wikimedia Commons
Secara matematis, gradient yang dihasilkan tiap langkah training ikut terskala oleh bobot sampel. Ketika bobot kelas minoritas cukup besar, arah pembaruan parameter didominasi oleh upaya menekan kesalahan pada kelas tersebut. Inilah alasan bobot dapat mengubah model tanpa menambah data baru sama sekali.
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
Menerapkan class_weight pada Estimator Scikit-learn
Nilai class_weight bisa berupa string 'balanced' untuk perhitungan otomatis, atau dictionary manual seperti {0: 1, 1: 10} ketika kita ingin mengontrol rasio biaya secara eksplisit. Gunakan 'balanced' saat kita hanya ingin menyeimbangkan kontribusi kelas, dan gunakan dictionary saat cost matrix sudah diketahui dari kebutuhan bisnis. Estimator menangani bobot dengan cara berbeda: LogisticRegression dan SVC memakai bobot pada fungsi loss, sedangkan RandomForestClassifier memakai bobot saat menghitung impurity split.
Kita bandingkan tiga estimator dengan dan tanpa class_weight, lalu fokus pada metrik kelas minoritas.
!pip install scikit-learn
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.metrics import classification_report

estimators = {
    "LogReg": LogisticRegression(max_iter=1000),
    "RandomForest": RandomForestClassifier(n_estimators=200, random_state=42),
    "SVC": SVC(),
}

for name, est in estimators.items():
    for weight in [None, "balanced"]:
        model = est.set_params(class_weight=weight)
        model.fit(X_train, y_train)
        report = classification_report(
            y_test, model.predict(X_test), output_dict=True, zero_division=0,
        )
        minor = report["1"]
        print(f"{name:12} weight={str(weight):8} "
              f"recall={minor['recall']:.3f} f1={minor['f1-score']:.3f}")
Output:
LogReg       weight=None     recall=0.123 f1=0.211
LogReg       weight=balanced recall=0.753 f1=0.263
RandomForest weight=None     recall=0.370 f1=0.536
RandomForest weight=balanced recall=0.173 f1=0.292
SVC          weight=None     recall=0.383 f1=0.544
SVC          weight=balanced recall=0.716 f1=0.545
Loop ini melatih setiap estimator dua kali, sekali tanpa bobot dan sekali dengan class_weight='balanced'. Kita mengakses metrik kelas minoritas lewat key "1" pada output_dict=True, bukan metrik keseluruhan yang didominasi kelas mayoritas. Output akan menunjukkan recall dan F1 kelas minoritas yang naik setelah bobot diaktifkan, dengan perbedaan besar antar estimator. Kita juga dapat membaca pergeseran confusion matrix untuk memastikan kenaikan recall memang berasal dari berkurangnya false negative, bukan dari perubahan acak pada prediksi.
Kontrol Biaya per Sampel dengan sample_weight
class_weight berguna saat biaya seragam di dalam satu kelas. Namun pada banyak kasus, biaya bergantung pada atribut tiap baris, misalnya nilai transaksi. Di sinilah sample_weight mengambil peran: kita menurunkan cost matrix menjadi vektor bobot sepanjang jumlah sampel, berdasarkan label aslinya.
!pip install scikit-learn numpy
import numpy as np
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.metrics import make_scorer, f1_score

cost_false_negative = 10.0
cost_false_positive = 1.0

def to_sample_weight(y_true):
    return np.where(y_true == 1, cost_false_negative, cost_false_positive)

weights = to_sample_weight(y_train)
model = LogisticRegression(max_iter=1000)
model.fit(X_train, y_train, sample_weight=weights)

scorer = make_scorer(f1_score, pos_label=1)
scores = cross_val_score(
    LogisticRegression(max_iter=1000), X_train, y_train,
    cv=5, scoring=scorer, params={"sample_weight": weights},
)
print("F1 kelas minoritas per fold:", scores.round(3))
Output:
F1 kelas minoritas per fold: [0.262 0.395 0.307 0.367 0.324]Fungsi to_sample_weight memetakan label asli ke bobot biaya: kelas positif mendapat bobot 10, kelas negatif bobot 1. Rasio ini menandakan bahwa satu false negative sepuluh kali lebih mahal daripada satu false positive. Kita meneruskan vektor bobot yang sama ke fit dan ke cross_val_score melalui argumen params, sehingga setiap fold training memakai bobot yang konsisten. Perlu diperhatikan bahwa weights di sini masih dihitung dari seluruh y_train; pada alur yang lebih ketat, bobot untuk tiap fold sebaiknya diturunkan hanya dari fold training agar tidak ada kebocoran informasi.
Menyeimbangkan Bobot melalui Ambang Keputusan dan Metrik yang Tepat
Bobot kelas bukan satu-satunya tuas. Ambang keputusan dari predict_proba ikut menentukan total biaya. Alih-alih memakai default 0.5, kita bisa menyapu berbagai threshold dan memilih titik dengan expected cost minimum sesuai cost matrix.
!pip install scikit-learn numpy matplotlib
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import precision_recall_curve, fbeta_score

model = LogisticRegression(max_iter=1000, class_weight="balanced")
model.fit(X_train, y_train)
proba = model.predict_proba(X_test)[:, 1]

precision, recall, thresholds = precision_recall_curve(y_test, proba)
costs = []
for t in thresholds:
    preds = (proba >= t).astype(int)
    fn = np.sum((y_test == 1) & (preds == 0))
    fp = np.sum((y_test == 0) & (preds == 1))
    costs.append(cost_false_negative * fn + cost_false_positive * fp)

best_idx = int(np.argmin(costs))
best_threshold = thresholds[best_idx]
print("Threshold optimal:", round(best_threshold, 3))
print("Expected cost minimum:", int(min(costs)))
print("F2 score di threshold ini:",
      round(fbeta_score(y_test, (proba >= best_threshold).astype(int), beta=2), 3))

plt.plot(thresholds, costs)
plt.axvline(best_threshold, color="red", linestyle="--")
plt.xlabel("Threshold")
plt.ylabel("Expected cost")
plt.title("Expected cost vs decision threshold")
plt.savefig("expected_cost_threshold.png", dpi=100, bbox_inches="tight")
Output:
Threshold optimal: 0.578
Expected cost minimum: 499
F2 score di threshold ini: 0.445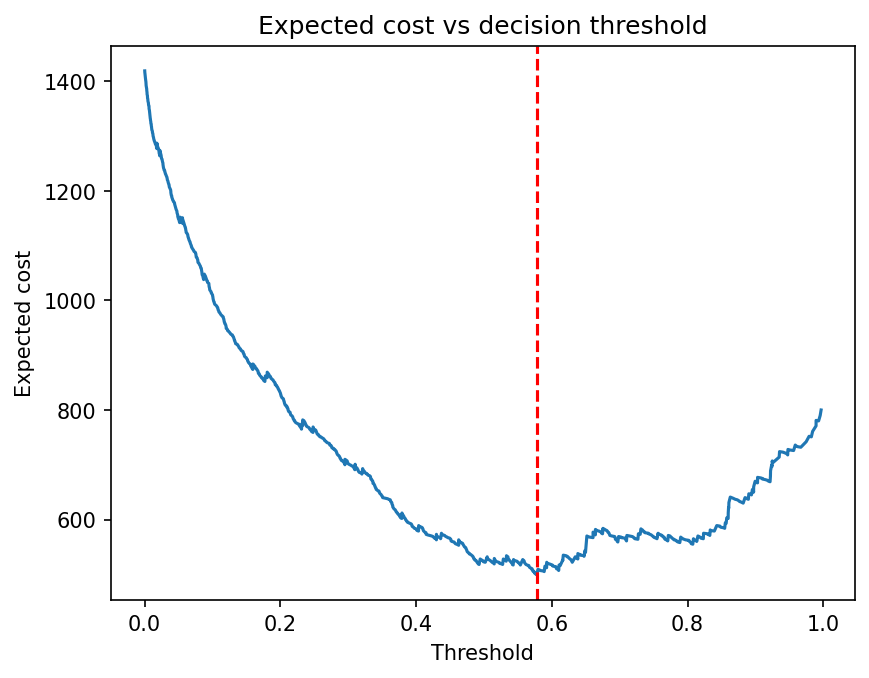
Loop menyapu setiap threshold dari precision_recall_curve dan menghitung expected cost dari jumlah false negative dan false positive yang dihasilkan. Threshold terbaik adalah titik dengan cost terendah, bukan 0.5. Kita juga melaporkan F2 score karena F-beta memberi bobot lebih besar pada recall, sesuai asumsi bahwa false negative lebih mahal. Plot menyimpan kurva cost terhadap threshold beserta garis penanda titik terpilih. Untuk kasus biaya asimetris, accuracy dan ROC-AUC sering kurang informatif karena keduanya memperlakukan kedua jenis kesalahan secara setara.
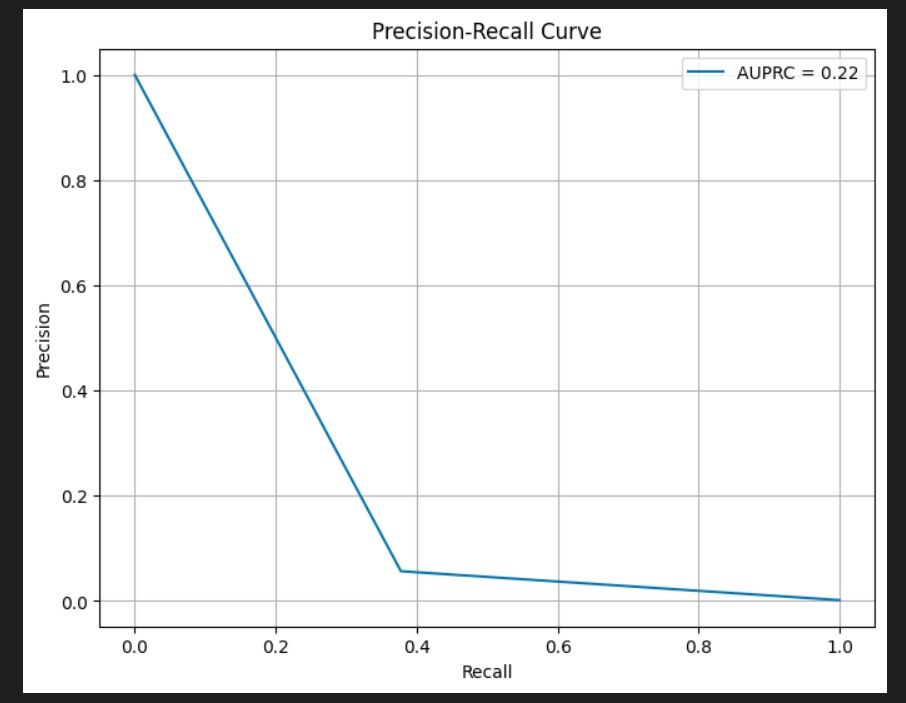
Gambar: Kurva precision-recall yang memperlihatkan trade-off precision dan recall di berbagai threshold (CC0) — Sumber: Wikimedia Commons
Praktik Terbaik dan Jebakan Umum di Produksi
Menghitung bobot dari seluruh dataset sebelum cross-validation adalah kesalahan yang umum. Bobot sebaiknya diturunkan dari training fold saja agar tidak ada informasi dari data validasi yang bocor ke proses training. Selain itu, selalu laporkan metrik kelas minoritas bersama expected cost; angka akurasi tunggal dapat menyembunyikan regresi pada kasus yang justru paling penting untuk ditangkap.
Cost-sensitive learning sebaiknya dibandingkan dengan pendekatan resampling seperti SMOTE atau undersampling, bukan dipakai sebagai pengganti secara buta. Keduanya menyelesaikan masalah yang berbeda: resampling mengubah distribusi data, sedangkan bobot mengubah fungsi objektif. Pada beberapa kasus, kombinasi keduanya memberi hasil terbaik.
Langkah terakhir adalah membangun cost matrix dari kebutuhan bisnis nyata bersama stakeholder, lalu merevisinya ketika biaya berubah. Cost matrix yang hanya ditebak di ruang rapat akan menghasilkan titik operasi yang salah, sebesar apa pun kualitas modelnya. Setelah deployment, pantau drift pada distribusi kelas dan recall kelas minoritas. Pergeseran distribusi dapat mengubah titik operasi yang optimal, sehingga threshold dan bobot perlu dievaluasi ulang secara berkala.
Ingin memperdalam evaluasi model dan strategi penanganan data tidak seimbang secara terstruktur? Pelajari lebih lanjut di Bootcamp Machine Learning Rumah Coding, dari pembahasan cost matrix sampai penerapan model yang siap produksi.
Course Terkait
Data Science with Python
Master the art of data analysis, visualization, and predictive modeling.
E-commerce Sales Dashboard
- Data Cleaning Pipeline
- Interactive Charts
- Sales Forecasting Model
Deep Learning Bootcamp
A beginner-friendly, highly interactive bootcamp designed to take you from foundational concepts to deploying real-world Artificial Intelligence applications. Through a completely project-based approach, you will master the core of Deep Learning, Artificial Neural Networks, and Computer Vision using Python and TensorFlow, ultimately building a professional-grade AI web application for your portfolio.
GreenGuard: Intelligent Plant Disease Diagnosis Web App
- Interactive Image Upload UI: A clean, user-friendly interface built with Streamlit that supports drag-and-drop image uploads directly from a computer or mobile phone.
- Real-Time AI Inference: Utilizes a lightweight, optimized CNN model (like MobileNetV2) to process the image and return a diagnosis in seconds without heavy server load.
- Confidence Scoring Dashboard: Visually displays the model's prediction probability (e.g., "95% confident this is Tomato Late Blight") using interactive progress bars or charts.
LLM Bootcamp
This project-based bootcamp is designed for beginners to dive practically into the world of Large Language Models (LLMs). Through hands-on building, you will learn how to interact with top-tier AI APIs, master prompt engineering, orchestrate complex workflows using LangChain, and implement Retrieval-Augmented Generation (RAG) to query your own documents. By the end of this course, you will have the skills to build, test, and deploy a fully functional, custom AI web application.
Domain-Specific AI Knowledge Assistant
- Dynamic Document Processing: A sidebar interface allowing users to upload new PDF or TXT files, which the app automatically chunks, embeds, and stores in the vector database.
- Context-Aware Chat UI: A modern chat interface built with Streamlit that maintains conversation history, allowing users to ask follow-up questions naturally.
- Strict Guardrails (Anti-Hallucination): System instructions designed so the AI politely declines to answer questions that fall outside the context of the uploaded documents.
Related Articles
Teori dan Implementasi Learning Curve untuk Mendiagnosis Overfitting dan Underfitting dengan Scikit-learn
Memahami Metrik Evaluasi Klasifikasi: Teori Confusion Matrix, Precision, Recall, dan F1-Score dengan Python